CoreWeave GH200-alapú felhőpéldányokat kínálna 2024 elején
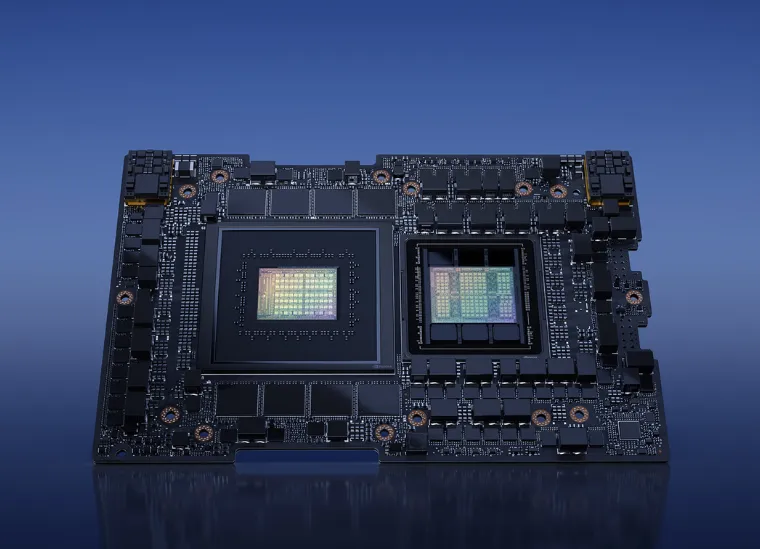
A CoreWeave 2024 első negyedévére NVIDIA GH200 Grace Hopper Superchip-alapú felhőpéldányokat jelentett be. A szolgáltató szerint az új hardver nagyobb teljesítményt és hatékonyabb működést hozhat a generatív mesterséges intelligencia és a nagy teljesítményű számítástechnika számára.
- A CoreWeave 2024 első negyedévére GH200-alapú példányokat tervezett.
- A vállalat az NVIDIA HGX H200 platform integrációját is tervezi.
- A CoreWeave szerint a H200 több memóriát és nagyobb átviteli sebességet kínál a H100-nál.
- A szolgáltató AI- és HPC-munkaterhelésekhez kínálja az új infrastruktúrát.
A GH200 és a H200 is bekerülhet a kínálatba
A CoreWeave az SC23 konferencia kapcsán közölte, hogy együttműködik az NVIDIA-val, és 2024 első negyedévében új, NVIDIA GH200 Grace Hopper Superchipre épülő példányokat tervez kínálni. A bejelentés szerint a platform a mesterséges intelligencia és a nagy teljesítményű számítástechnika, vagyis a HPC munkaterheléseit célozza.
A vállalat emellett az NVIDIA HGX H200 platform integrációját is tervezi saját szoftveres környezetébe és rendszereibe. A platform része az NVIDIA H200 Tensor Core GPU, amelyet az NVIDIA korábban jelentett be. A CoreWeave közlése szerint a H200 nagyobb átviteli sebességet és több memóriát kínál az NVIDIA H100 GPU-nál.
A szolgáltató szerint gyorsulhat a nagy modellek kiszolgálása
A CoreWeave szerint az NVIDIA H200 a generatív AI és a nagy teljesítményű számítástechnika fejlesztését gyorsíthatja. A vállalat külön kiemelte a nagy nyelvi modellek következtetési feladatait, amelyeknél a nagyobb memória és az átviteli teljesítmény gyorsabb feldolgozást tehet lehetővé.
A cég állítása szerint ezek a képességek az ügyfelek teljes birtoklási költségét is csökkenthetik. A CoreWeave ezért a közleményben azt írta, hogy a következő évben az elsők között szeretné telepíteni az új platformot a felhőszolgáltatók között. Konkrét árakat, elérhetőségi feltételeket és teljesítményszámokat nem közölt.
H100 klaszterek és együttműködések az SC23-on
A CoreWeave az SC23-on több technológiai partnerrel közös munkát is bemutatott. A felsorolt partnerek között szerepel a VAST Data, a SchedMD, a Weights and Biases és a Zeet. A vállalat NVIDIA-val közös nevezését is ismertette az MLPerf Training 3.0 gépi tanulási benchmarkon, amelyről azt állította, hogy rekordot jelentő eredményeket hozott.
A szolgáltató bemutatója kitért a szerver nélküli infrastruktúrára, valamint arra az álláspontjára, hogy a csupasz fémes infrastruktúra előnyös lehet a következtetéshez, a modelltréninghez és a modern AI- és ML-munkaterhelésekhez. A CoreWeave jelenlegi, NVIDIA H100 Tensor Core GPU-kra épülő, testre szabott GPU-klasztereit a cég szerint vezető AI-laborok és vállalatok használják összetett modellek építésére, tanítására és telepítésére.
Mit jelenthet ez a CoreWeave ügyfeleinek?
A bejelentés alapján a CoreWeave a gyorsan növekvő generatív AI-igényekhez kíván nagyobb számítási kapacitást biztosítani. A vállalat szerint az egyre nagyobb modellek komoly méretet és infrastruktúrát igényelnek, miközben a rendszer teljesítményének szűk keresztmetszeteit is kezelni kell.
Az új GH200-alapú példányok és a tervezett HGX H200-integráció a CoreWeave kínálatát bővítheti az AI- és HPC-feladatok számára. A szolgáltató célja saját megfogalmazása szerint az, hogy ügyfelei nagy teljesítményű felhőinfrastruktúrán, gyorsabban és kiszámíthatóbban fejleszthessék és telepíthessék modelljeiket.