A CoreWeave széles körben elérhetővé tette az NVIDIA HGX B200-at
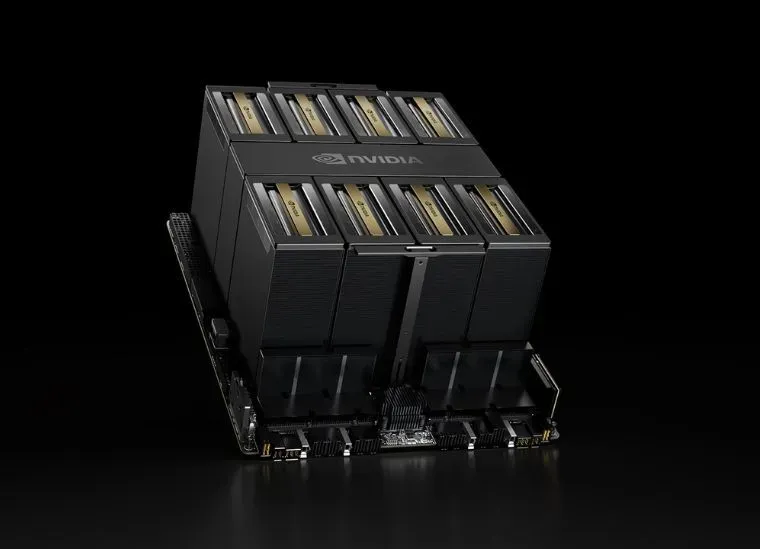
A CoreWeave általánosan elérhetővé tette az NVIDIA HGX B200-alapú példányokat felhőplatformján. A vállalat szerint az új konfigurációk a korábbi NVIDIA Hopper GPU-khoz képest GPU-nként akár kétszer gyorsabb teljesítményt kínálnak.
- A CoreWeave általánosan elérhetővé tette az NVIDIA HGX B200-alapú példányokat.
- Minden példány 8 NVIDIA B200 GPU-t és egyenként 180 GB HBM3e memóriát tartalmaz.
- A vállalat szerint a rendszer GPU-nként akár 2-szer gyorsabb a Hopper GPU-knál.
- A példányok az US-WEST-01A zónában, b200-8x azonosítóval rendelhetők.
- A SUNK, a CKS, az Observe és a Mission Control az infrastruktúra üzemeltetését támogatja.
A korlátozott bevezetést szélesebb hozzáférés követi
A CoreWeave 2026. október 22-én jelentette be az NVIDIA Blackwell-alapú infrastruktúrájának bővítését. Az NVIDIA HGX B200-alapú példányok mostantól általánosan elérhetők a vállalat felhőplatformján, így a szolgáltató szerint szélesebb kör számára nyílik hozzáférés a rendszerhez.
A CoreWeave első HGX B200-telepítése 2025 februárjában indult. Ez a környezet egy stratégiai ügyfelet támogatott több mint 10 000 NVIDIA Blackwell GPU-val, NVIDIA Quantum-2 InfiniBand hálózaton keresztül. A mostani bejelentés ezt a kezdeti telepítést egészíti ki általánosan rendelhető példányokkal.
A vállalat ezeket a rendszereket vállalati mesterségesintelligencia-munkaterhelésekhez, AI-modellek tanításához és valós idejű következtetéshez kínálja. A CoreWeave állítása szerint a HGX B200 GPU-nként akár kétszer gyorsabb az előző generációs NVIDIA Hopper GPU-knál.
Nyolc Blackwell GPU egyetlen példányban
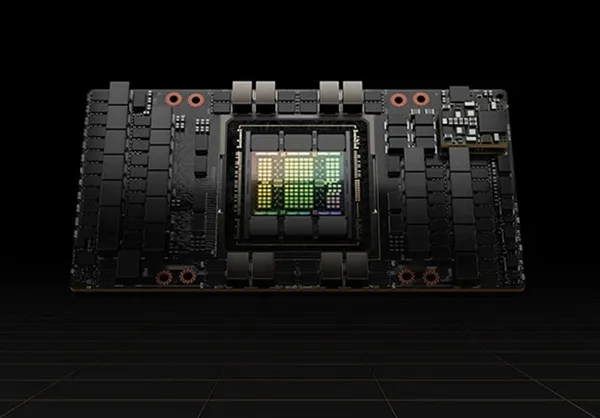
Minden CoreWeave-példány nyolc NVIDIA B200 Blackwell GPU-t tartalmaz, egyenként 180 GB HBM3e memóriával. A GPU-kat NVIDIA NVLink és NVLink Switch kapcsolja össze. A rendszerben két Intel Emerald Rapids 8562Y+ processzor, valamint 61,44 TB helyi NVMe-tárhely is található.
A hálózati kapcsolatért egy NVIDIA BlueField-3 DPU és nyolc NVIDIA ConnectX-7 InfiniBand host channel adapter felel. A példányok 400G NDR sebességű, nem blokkoló NVIDIA Quantum-2 InfiniBand hálózati szövethez kapcsolódnak. A CoreWeave ezt a felépítést veszteségmentes skálázáshoz és nagy áteresztőképességű adatátvitelhez használja.
Az NVIDIA szerint a HGX B200 a Hopper generáció technológiájára épít. A CoreWeave közlése szerint az infrastruktúra a GPT-MoE-1.8T-hez hasonló modelleken akár 15-ször gyorsabb következtetést és a Hopper-generációs H100-alapú példányokhoz képest háromszor gyorsabb tanítást is lehetővé tehet. A dedikált kitömörítő motorral a lekérdezési tesztek eredményei a vállalat szerint kétszer jobbak lehetnek a Hopper GPU-kénál.
Slurm és Kubernetes közös környezetben
A CoreWeave saját SUNK rendszerét is kínálja a B200-alapú klaszterekhez. Ez a Slurm és a Kubernetes integrációja, amely lehetővé teszi, hogy az ügyfelek ugyanazon a klaszteren tanítsanak és szolgáljanak ki nagy modelleket. A CoreWeave szerint a SUNK dinamikusan osztja meg a számítási kapacitást a munkaterhelések között, így nincs szükség külön környezetekre.
A topológiatudatos ütemezés a GPU-k közötti kapcsolatot és az adatok helyét is figyelembe veszi. A szolgáltató szerint ez javíthatja a nagy nyelvi modellek finomhangolásának és kiszolgálásának hatékonyságát. A CoreWeave Kubernetes Service, vagyis a CKS, felügyelt Kubernetes-környezetet biztosít az AI-munkaterhelésekhez.
A HGX B200-példányok közvetlenül bare metal szervereken futnak. Minden klaszter saját privát Virtual Private Cloud környezetben működik, a hálózati, biztonsági és tárolási feladatokat pedig dedikált BlueField DPU-k segítik.
Hol rendelhető meg az új példány?
Az ügyfelek az NVIDIA HGX B200-alapú példányokat a b200-8x Instance ID-val indíthatják el az US-WEST-01A rendelkezésreállási zónában. A CoreWeave Observe per GPU-s betekintést biztosít többek között a GPU XID-hibáiba, a memóriahasználatba, a GPU-kihasználtságba, a fogyasztásba és a hőmérsékletbe.
A Mission Control automatizált felügyeletet és szakértői emberi ellenőrzést kombinál. A CoreWeave szerint ez az infrastruktúra üzemeltetésének terheit csökkentheti az ügyfeleknél, miközben a vállalati szintű megbízhatóságra és ellenálló képességre összpontosít.
A bejelentés alapján a HGX B200 azoknak a vállalatoknak szól, amelyek nagy léptékű modellbetanítást, valós idejű következtetést, generatív AI-feladatokat, adatelemzést vagy nagy teljesítményű számítási munkát futtatnának. A CoreWeave a hardvert az ütemezési, megfigyelési és üzemeltetési szolgáltatásaival együtt kínálja.
CoreWeave: CoreWeave Expands its NVIDIA Blackwell Fleet with Generally Available NVIDIA HGX B200 Instances