A Deepgram 10 nyelvre bővítette orvosi beszédfelismerő modelljét
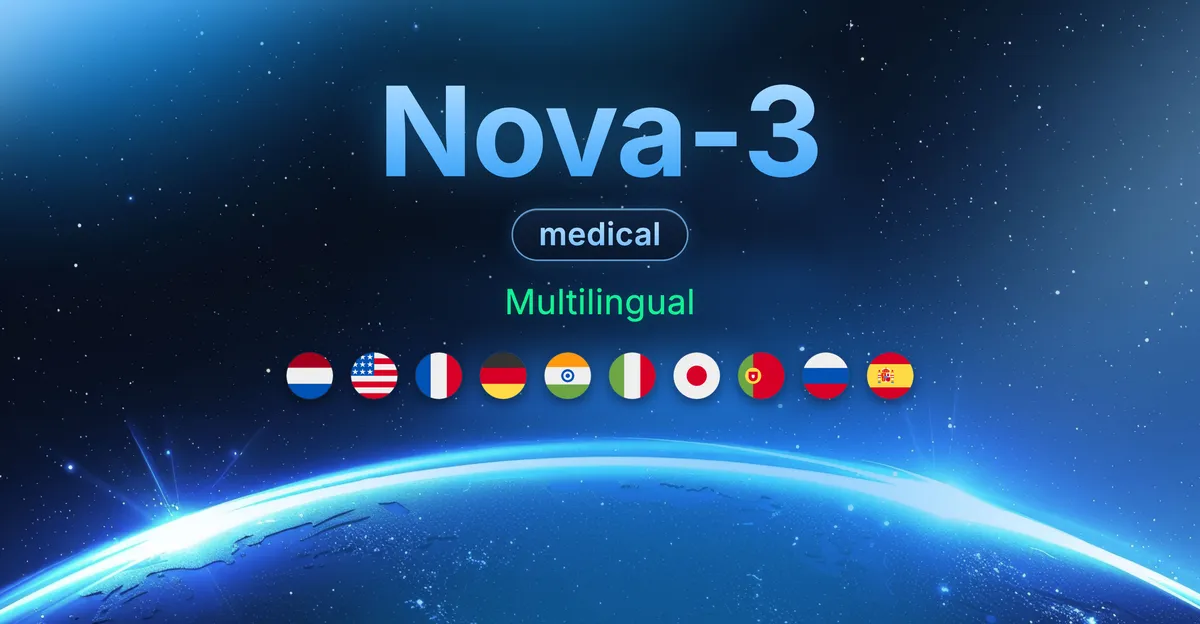
A Deepgram Nova-3 Medical Multilingual tíz nyelven kínál orvosi beszédfelismerést, köztük magyarul nem, de angolul, németül, spanyolul és hindin igen. A vállalat szerint a modell az általános többnyelvű rendszerhez képest különösen a gyógyszernevek, adagok és diagnózisok felismerésében javít.
- A Nova-3 Medical Multilingual tíz nyelven támogat orvosi beszédfelismerést.
- Kötegelt feldolgozásnál a Deepgram 4,96 százalékos átlagos WER-t mért.
- Az adagok felismerésénél 64 százalékkal kevesebb hibát jelentettek.
- A modell automatikusan kezeli a nyelvek közötti váltást.
- A szolgáltatás a Deepgram API-ján és saját üzemeltetésben is elérhető.
Tíz nyelven, automatikus nyelvváltással
A Deepgram október 7-én mutatta be a Nova-3 Medical Multilingual modellt. A rendszer a Nova-3 Medical 2025-ben elindított, orvosi beszédre specializált változatának többnyelvű kiterjesztése.
A modell holland, angol, francia, német, hindi, olasz, japán, portugál, orosz és spanyol nyelven érhető el. Kötegelt és folyamatos, valós idejű feldolgozást is támogat, továbbá automatikusan követi a beszélgetés közbeni nyelvváltást a támogatott nyelvek között. Így egy alkalmazásnak nem kell előre tudnia, milyen nyelven érkezik a hanganyag.
A Deepgram szerint az általános többnyelvű beszédfelismerés képes lehet egy beszélgetés átírására, de könnyebben hibázik azokon a részleteken, amelyekre az egészségügyi alkalmazások építenek. Ilyen lehet egy betegség neve, egy gyógyszer, egy adag, egy dátum vagy egy szám.
A fontos orvosi kifejezéseknél nagyobb a javulás
A vállalat több mint 115 órányi, tíz nyelvet lefedő, válogatott orvosi hanganyagon hasonlította össze a Nova-3 Medical Multilingualt az általános célú Nova-3 Multilingual modellel. Kötegelt átírásnál a szavankénti hibaarány, vagyis a WER, átlagosan 6,62 százalékról 4,96 százalékra csökkent, ami 25 százalékos mérséklődés. Folyamatos feldolgozásnál 8,32 százalékról 5,86 százalékra esett vissza, ez 30 százalékos javulás.
A WER minden szót azonos súllyal kezel, ezért a Deepgram az entitáshibaarányt, az EER-t is mérte. Ez olyan fontos elemek felismerését vizsgálja, mint a betegségek, gyógyszerek, adagok, dátumok, számok és nevek. Az EER kötegelt feldolgozásnál 14,46 százalékról 9,11 százalékra, folyamatos módban pedig 16,31 százalékról 9,78 százalékra csökkent.
A kötegelt tesztben az adagok felismerésénél 64, a betegségeknél 43, az orvosi folyamatoknál 41, a gyógyszereknél pedig 31 százalékkal kevesebb hibát mért a Deepgram. Az általános modellhez képest a WER nyolc nyelven kötegelt, kilenc nyelven pedig folyamatos feldolgozásnál volt jelentősen alacsonyabb. A legnagyobb kötegelt javulást orosz, spanyol és hindi nyelven jelezték, 58, 32, illetve 30 százalékot.
Egészségügyi alkalmazásokhoz és fejlesztőknek
A Deepgram a vizsgálatban más beszédfelismerő modelleket is tesztelt ugyanazon az orvosi adathalmazon. A mind a tíz nyelven értékelt modellek közül a Nova-3 Medical Multilingual érte el a legalacsonyabb átlagos kötegelt WER-t, 4,96 százalékot. Az ElevenLabs Scribe v2 Medical 5,49, az ElevenLabs Scribe v2 5,58, a Microsoft MAI 1.5 pedig 7,80 százalékot ért el. A Deepgram modellje tíz nyelvből hétben produkálta a legalacsonyabb WER-t, miközben a vállalat külön jelzi, hogy egyik modell sem volt első minden nyelven.
A szolgáltatást a cég olyan feladatokra ajánlja, mint a vizitek automatikus dokumentálása, egészségügyi hangügynökök működtetése, időpontfoglalás, receptújítás, betegfelvétel és klinikai diktálás. A folyamatos feldolgozásnál mért 5,86 százalékos WER és 9,78 százalékos EER a Deepgram szerint lehetővé teszi, hogy az alkalmazás beszélgetés közben dolgozza fel a gyógyszerneveket, adagokat és betegségeket.
A modell a Deepgram API-ján keresztül már elérhető. A fejlesztőknek a model=nova-3-medical és language=multi paramétert kell használniuk előre rögzített vagy folyamatos hanganyagoknál. A Nova-3 Medical Multilingual saját üzemeltetésű telepítésekhez is elérhető, ehhez a Deepgram ügyfélkapcsolati képviselőjénél kell igényelni a modelleket.