EvoLib: így tanulhatnak tovább az AI-modellek a saját tapasztalataikból
A Microsoft Research bemutatta az EvoLib nevű keretrendszert, amely lehetővé teszi a nagy nyelvi modellek számára, hogy következtetés közben, külső visszajelzés és helyes válaszokkal ellátott adatok nélkül tanuljanak saját tapasztalataikból. A módszer a korábbi próbálkozásokat újrahasznosítható készségekké és meglátásokká alakítja.
- Az EvoLib címkézett adatok és külső visszajelzés nélkül tanul a modell saját tapasztalataiból.
- A korábbi próbálkozásokat újrahasznosítható készségekké és reflexív meglátásokká alakítja.
- A tudáselemeket konszolidálja, finomítja és hosszú távú hasznosságuk szerint súlyozza.
- Matematikai, kódolási és hosszú távú döntési feladatokon is tesztelték.
- A Microsoft Research szerint eltérő feladatsorrend mellett is stabil teljesítményt nyújtott.
A memória önmagában még nem tanulás
A Microsoft Research szerint az AI-ügynökök számára fontos képesség a korábbi tapasztalatok tárolása és előhívása. A puszta memória azonban nem feltétlenül jelent tanulást. A korábbi beszélgetések, gondolatmenetek és cselekvési előzmények idővel hatalmas archívummá válhatnak, amelyből nehéz kiválasztani az új feladathoz releváns tudást.
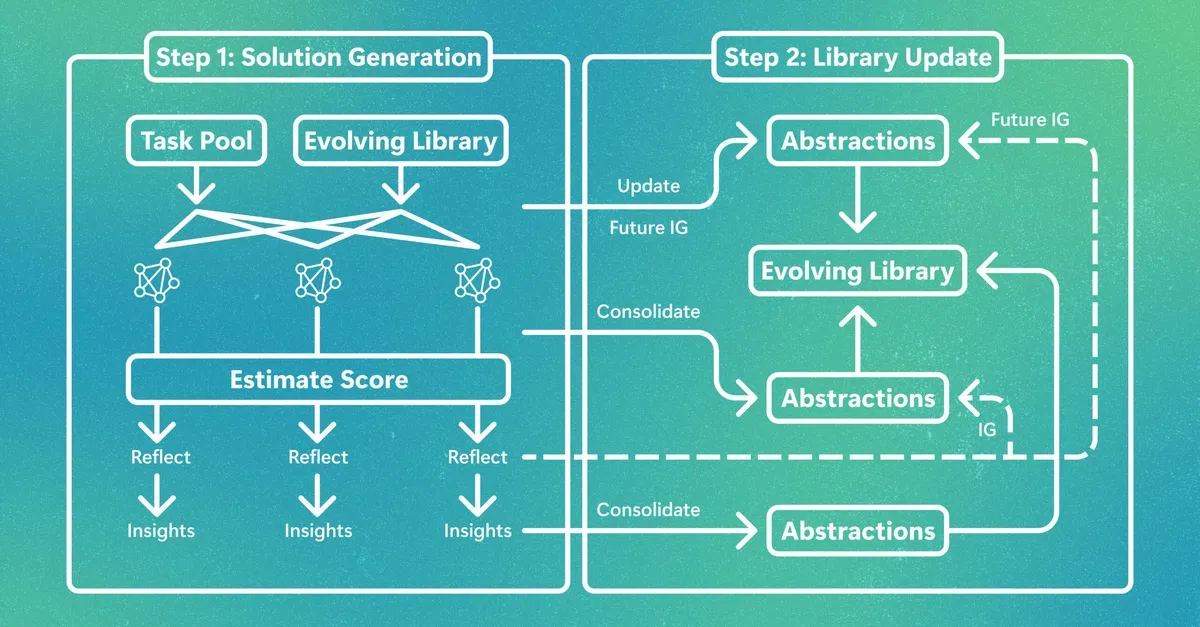
Az EvoLib más megközelítést alkalmaz. A rendszer nem egyszerűen statikus emlékként őrzi meg a nyers tapasztalatokat, hanem tudást von ki belőlük, majd ezt a tudást az új tapasztalatok érkezésével folyamatosan finomítja. Egy tudáselem lehet egy sikeres megoldásból levezetett, újrahasznosítható készség, vagy egy korábbi hibából származó reflexív meglátás.
Készségek és meglátások fejlődő könyvtára
Az EvoLib egyik mechanizmusa a konszolidáció. Amikor a rendszer új tudást nyer ki a friss tapasztalatokból, hasonló elemeket keres a könyvtárban, és megpróbálja ezeket egy általánosabb, több feladaton is használható tudássá egyesíteni. Így az egyedi tapasztalatok fokozatosan szélesebb körben alkalmazható ismeretekké válhatnak.
A keretrendszer súlyozási mechanizmust is használ. Ez nemcsak azt veszi figyelembe, hogy egy tudáselem mennyire volt hasznos az aktuális feladatban, hanem azt is, hogy mennyiben járul hozzá a jövőbeli feladatokhoz szükséges tudás létrehozásához. A Microsoft Research leírása szerint idővel azok az elemek válnak hangsúlyosabbá, amelyeknek nagyobb a hosszú távú hatásuk.
Az EvoLib használatához nincs szükség az alapul szolgáló modell frissítésére. Emiatt a Microsoft Research szerint a módszer feketedobozként működő nyelvi modelleken és API-kon keresztül elérhető AI-rendszereken is alkalmazható.
Matematikai feladatokban, kódolásban és döntési helyzetekben tesztelték
A kutatók többféle, nagy kihívást jelentő feladaton értékelték az EvoLibet. Vizsgálták matematikai gondolkodást igénylő problémák megoldásában, kódírásban, ahol hatékonysági korlátoknak kellett megfelelni, valamint olyan döntési helyzetekben, amelyekben a rendszernek fel kellett fedeznie és használnia egy környezetet hosszabb feladatok teljesítéséhez.
A Microsoft Research szerint az EvoLib mindhárom területen következetesen felülmúlta a vezető, előhíváson alapuló memória-megközelítéseket és más absztrakt memória-mechanizmusokat, miközben hatékonyabban használta a tokeneket. A módszer a tesztelés alatt rendelkezésre álló számítási kapacitást is eredményesebben alakította teljesítménynövekedéssé.
A kutatók külön azt is vizsgálták, hogy számít-e a feladatok sorrendje. Az eredmények alapján az EvoLib eltérő sorrendek mellett is stabil teljesítményt mutatott, és javított a meglévő memóriaalapú tanulási módszerekhez képest. Ez arra utal, hogy különböző típusú feladatok kevert sorozatából is képes folyamatosan tanulni, strukturált tanulási menet nélkül.
A modellfrissítés nélküli alkalmazkodás lehetősége
A Microsoft Research 2026. július 30-án közzétett beszámolója szerint az EvoLib egy olyan irányt képvisel, amelyben az AI-rendszerek a telepítés után is képesek tapasztalatot felhalmozni, finomítani és több feladaton újrahasznosítani. A hangsúly így nem pusztán a több memória tárolásán vagy a nagyobb számítási kapacitáson van, hanem azon, hogy a rendszer a tapasztalatokat általánosítható tudássá alakítsa.
A kutatók szerint ez különösen a hosszabb ideig működő és összetettebb feladatokat végző AI-ügynökök számára lehet fontos. Az EvoLib kódját és kísérleti eredményeit GitHubon is elérhetővé tették, hogy támogassák a memóriával és a tudás fejlődésével kapcsolatos további kutatásokat.
Microsoft Research: EvoLib: Turning experience into evolving knowledge