A FuriosaAI RNGD gyorsítója kevesebb energiával közelítette meg az NVIDIA GPU-kat
A FuriosaAI és az AI-infrastruktúrával foglalkozó Lablup közös tanulmánya az RNGD gyorsítókat vizsgálta a Backend.AI platformon. A Qwen3-32B modellel végzett tesztben az RNGD a referencia-rendszer teljesítményének 95 százalékát érte el, miközben 30-44 százalékkal kevesebb energiát fogyasztott.
- A tesztben négy FuriosaAI RNGD gyorsítót hasonlítottak négy NVIDIA RTX PRO 6000 Blackwell Server Edition GPU-hoz.
- Az RNGD a Qwen3-32B modellel, 256 kérésnél a referencia átbocsátásának 95 százalékát érte el.
- Az RNGD 30-44 százalékkal kevesebb energiát fogyasztott a kontrollrendszernél.
- Az egy wattra jutó átbocsátás 1,3-1,5-ször magasabb volt az RNGD-nél.
- Az RNGD a 32-es konkurenciaszintig egy másodperc alatt tartotta az első tokenig eltelt időt.
Négy RNGD gyorsítóval végeztek összehasonlítást
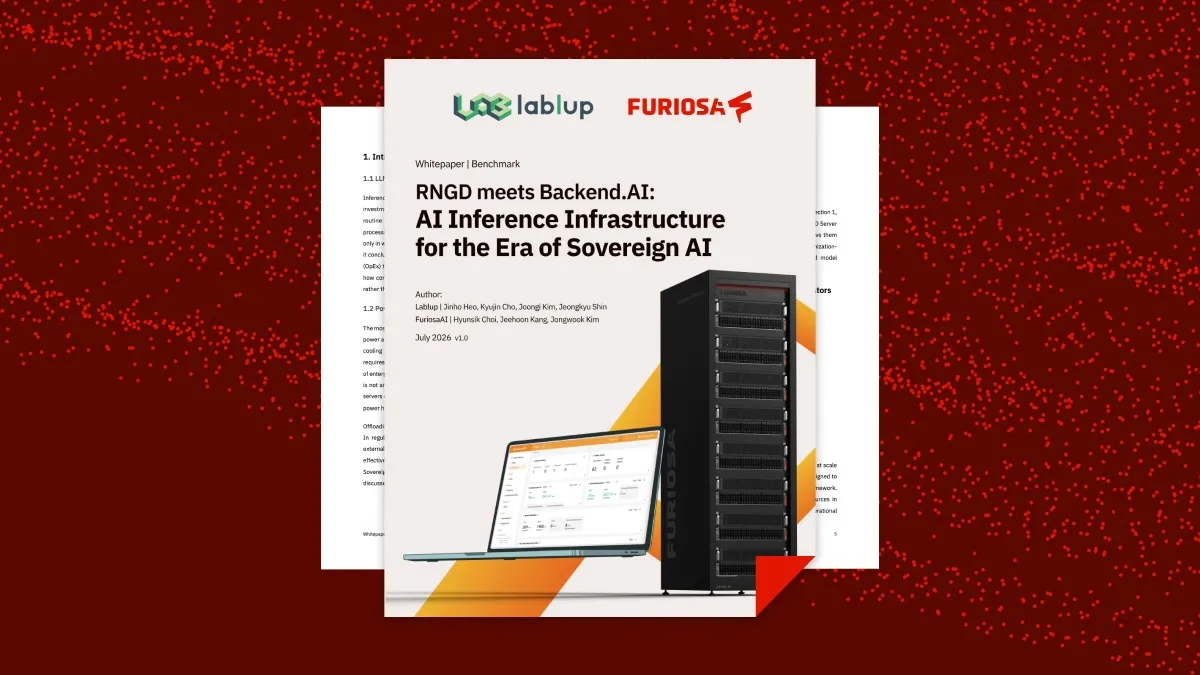
A FuriosaAI 2026. augusztus 6-án ismertette a Lablup vállalattal közösen készített tanulmányt. A „RNGD meets Backend.AI” című fehér könyv egy olyan vállalati AI-következtetési infrastruktúrát vizsgál, amelyben a FuriosaAI RNGD következtetési gyorsítója a Lablup Backend.AI vezérlési és erőforrás-kezelési platformjával működik együtt.
A mérésben négy RNGD gyorsítót vetettek össze egy olyan kontrollrendszerrel, amelyben négy NVIDIA RTX PRO 6000 Blackwell Server Edition GPU futott közvetlenül a szerveren, vagyis bare-metal környezetben. A vizsgálat a Qwen3-32B modellt használta FP8 pontosság mellett, és többek között az átbocsátást, a késleltetést, az energiahatékonyságot és a skálázhatóságot mérte.
Kisebb fogyasztás mellett közel azonos átbocsátás
A FuriosaAI közlése szerint az RNGD a legnagyobb, 256 kéréses konkurenciaszintnél a kontrollrendszer átbocsátásának 95 százalékát érte el. Ezzel párhuzamosan 30-44 százalékkal kevesebb energiát fogyasztott a vizsgált terhelés mellett.
Az összes mért konkurenciaszinten kedvezőbb volt az egy wattra jutó átbocsátás is. Az RNGD ezen a mutatón 1,3-1,5-szörös eredményt ért el a kontrollcsoporthoz képest. Ez a mérőszám azt mutatja meg, hogy a rendszer adott energiafelhasználás mellett mekkora feldolgozási teljesítményt biztosít.
A felhasználói válaszidő szintén a vizsgálat középpontjában állt. Az RNGD a 32-es konkurenciaszintig egy másodperc alatt tartotta az első tokenig eltelt időt, vagyis a Time to First Token (TTFT) értékét. A kontrollcsoportnál ugyanez az érték 2,9 másodperc fölé emelkedett.
A Backend.AI a telepítést és az üzemeltetést célozza
A tanulmány a hardveres eredmények mellett azt is bemutatja, hogyan használható együtt az RNGD és a Backend.AI a nagyobb, éles környezetben futó AI-következtetési feladatok telepítésére és kezelésére. A Backend.AI heterogén gyorsított számítási környezetek egységes platformon történő kezelésére készült.
A fehér könyv olyan üzemeltetési problémákat tárgyal, mint a léghűtés korlátai, az adatközpontok növekvő teljesítménysűrűsége és a szuverén AI megfelelőségi követelményei. Gyakorlati telepítési stratégiákat is ismertet vegyes nagy nyelvi modell alapú munkaterhelésekhez, például a modellek előfeldolgozási és dekódolási szakaszának kezeléséhez.
Ehhez a Backend.AI munkamenet-alapú végrehajtási modelljét és a Sokovan vezérlőt használja. A platform a FuriosaAI leírása szerint gyártófüggetlen, gyorsított munkaterhelések futtatására szolgál, és felhőben, illetve helyben működtetett, akár hálózattól leválasztott fürtökön is futtatható.
A jelentés a telepítési döntésekhez ad mérési adatokat
A közzétett eredmények alapján az RNGD és a Backend.AI kombinációja olyan infrastruktúra számára lehet releváns, ahol egyszerre számít az átbocsátás, a válaszidő és az energiafelhasználás. A tesztben mért 30-44 százalékos fogyasztáscsökkenés és az 1,3-1,5-szörös, wattonkénti átbocsátás a gyorsítók energiahatékony működését helyezi a középpontba.
A FuriosaAI és a Lablup a teljes mérési eredményeket, valamint a telepítési útmutatót a Backend.AI oldalán elérhető fehér könyvben tette közzé. A jelentés koreai nyelvű változata szintén rendelkezésre áll.