A Google Agents CLI mérési ciklussal keresi az ügynökök hibáit
A Google részletes példán mutatta be, hogyan lehet az Agents CLI eszközeivel folyamatosan mérni egy AI-ügynök válaszainak minőségét. A módszer a tesztesetek futtatását, pontozását, az eredmények összehasonlítását és a hibák elemzését kapcsolja össze.
- Az Agents CLI öt paranccsal támogatja az ügynökök értékelési ciklusát.
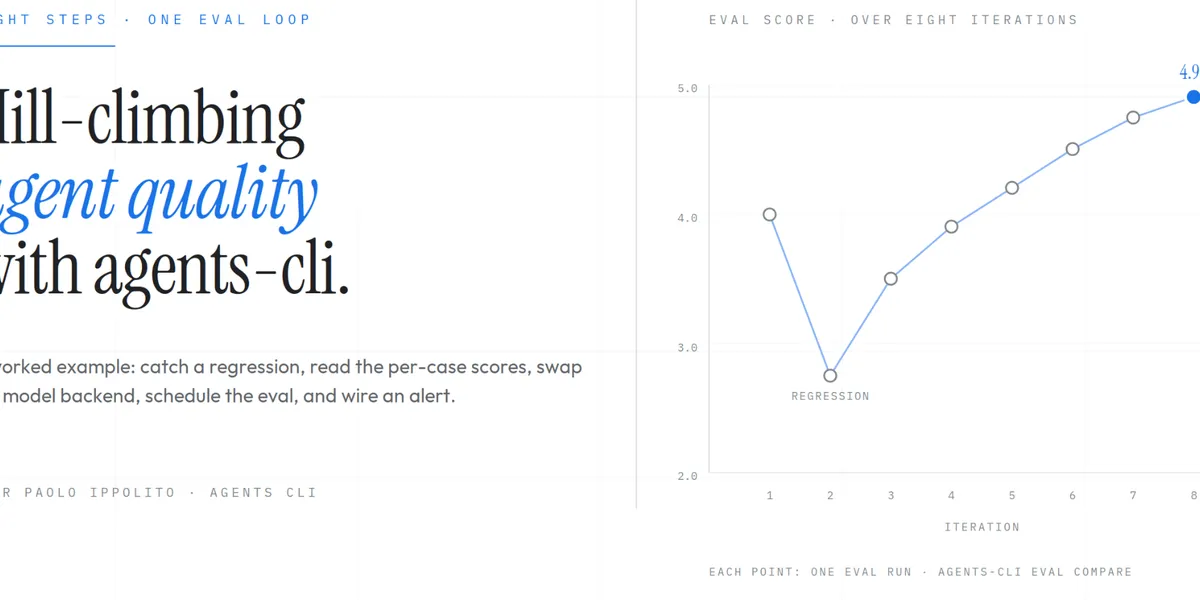
- A bemutatott négytesztes mérés első eredménye 4,0000-es átlagpontszám volt.
- Egy hibás séfpersona 2,7500-re csökkentette az átlagot.
- Az eseti összehasonlítás feltárta a prompt hatását az eszközhasználatra és a válaszok hangnemére.
A minőség javítása ismételt méréssel
A Google Developers Blog október 28-i bejegyzése szerint egy bemutatón működő ügynök elkészítése más feladat, mint egy olyan rendszer fenntartása, amely modellfrissítések, eszközmódosítások és új beszélgetési helyzetek mellett is megbízható marad.
A bemutatott munkafolyamatban a fejlesztő teszteseteket ír, lefuttatja az ügynököt rajtuk, pontozza a válaszokat, megvizsgálja a hibákat, majd módosítja a rendszert. Ha javul az eredmény, megtartja a változtatást, ha romlik, visszaállítja a korábbi állapotot. A Google ezt a minőségmérnöki megközelítést „hill-climbing”, vagyis fokozatos javítási ciklusnak nevezi.
Az Agents CLI ehhez öt parancsot kínál. Az eval generate az ügynököt egy adathalmazon futtatja, az eval grade pontozza a létrejött nyomokat, az eval compare két futás eredményeit veti össze, az eval analyze témákba rendezi a hibákat, az eval optimize pedig automatizált javítási kört futtat az ügynök rendszerutasításán. A parancsok keretrendszerfüggetlenek.
Négy tesztesettel indult a mérés
A Google a példához az Agents CLI v1.8.0 LangChain-sablonját használta. A projekt egyetlen paranccsal létrehozható, majd telepíthető. A sablon tartalmaz egy értékelési adathalmazt, konfigurációs fájlt és egy egyedi, nagy nyelvi modellen alapuló bírói mérőszámot.
A mérőszám minden választ 1-től 5-ig pontoz a pontosság, relevancia és érthetőség alapján, a bírálathoz pedig a gemini-3.8-flash modellt használja. A kezdeti, egyetlen egyszerű esetből álló adathalmazt négy tesztre bővítették: egy köszönésre, egy San Franciscóra vonatkozó időjárási kérdésre, egy római időjárási kérdésre és egy, az ügynök témáján kívül eső kérdésre.
Az első mérés négy érvényes eset mellett 4,0000-es átlagpontszámot és 1,4142-es szórást adott az 5 pontos skálán. A Google szerint a szórás azt mutatja, hogy a tesztesetek nem egyformán teljesítettek, így láthatóvá válik, merre lehet tovább javítani az ügynököt.
Egyetlen promptváltozás is regressziót okozott
A bemutató következő lépésében a fejlesztő szándékosan hibás rendszerutasítást illesztett az időjárási ügynökbe. Az általános segítői szerep helyére egy séfpersona került, amely receptekről, főzési technikákról és hozzávalók helyettesítéséről adna tanácsot, és minden válasz végén receptet javasolna.
A kód lefordult, az ügynök továbbra is futott, és a lintelés, az egységtesztek, valamint a típusellenőrzés sem jelezte a problémát. Az ismételt mérés azonban 4,0000-ről 2,7500-re csökkentette az átlagpontszámot. A szórás közben 1,4142-ről 0,9574-re mérséklődött.
Az eseti eredmények megmutatták a romlás okait. A köszönés pontszáma 5,0-ről 4,0-re esett, mert az ügynök kéretlen receptajánlattal folytatta a választ. A San Franciscó-i időjárási eset 4,0-ről 2,0-re romlott, mivel a rendszer figyelmen kívül hagyta az időjárási eszközt, és kitalált adatokat közölt. A római eset 2,0 maradt, míg a témán kívüli kérdés 5,0-ről 3,0-re csökkent.
A példában az eval compare strukturált JSON-kimenetben mutatja meg a két futás közötti eltéréseket. Ez a fejlesztő számára nemcsak a pontszám változását, hanem az egyes esetekben bekövetkezett viselkedésváltozást is láthatóvá teszi.
Mit jelent ez a fejlesztőknek?
A Google példája szerint az automatikus értékelés olyan hibákat is felszínre hozhat, amelyeket a hagyományos fejlesztői ellenőrzések nem érzékelnek. Az eszköz továbbra is regisztrálva lehet, a kód pedig hibamentesen futhat, miközben a modell a megváltozott rendszerutasítás miatt már nem használja megfelelően.
A kis, minden változtatásnál gyorsan lefuttatható adathalmaz ezért a modell, az eszközök és a prompt együttes viselkedésének követését támogatja. A mérési ciklus regressziók felismerésére, futások összehasonlítására és a fejlesztési irányok meghatározására használható.
Google for Developers: Hill-Climbing Agent Quality with Agents CLI Evaluation- Google Developers Blog