A Google felgyorsította a videógenerálást TPU-kon ritka figyelemmel
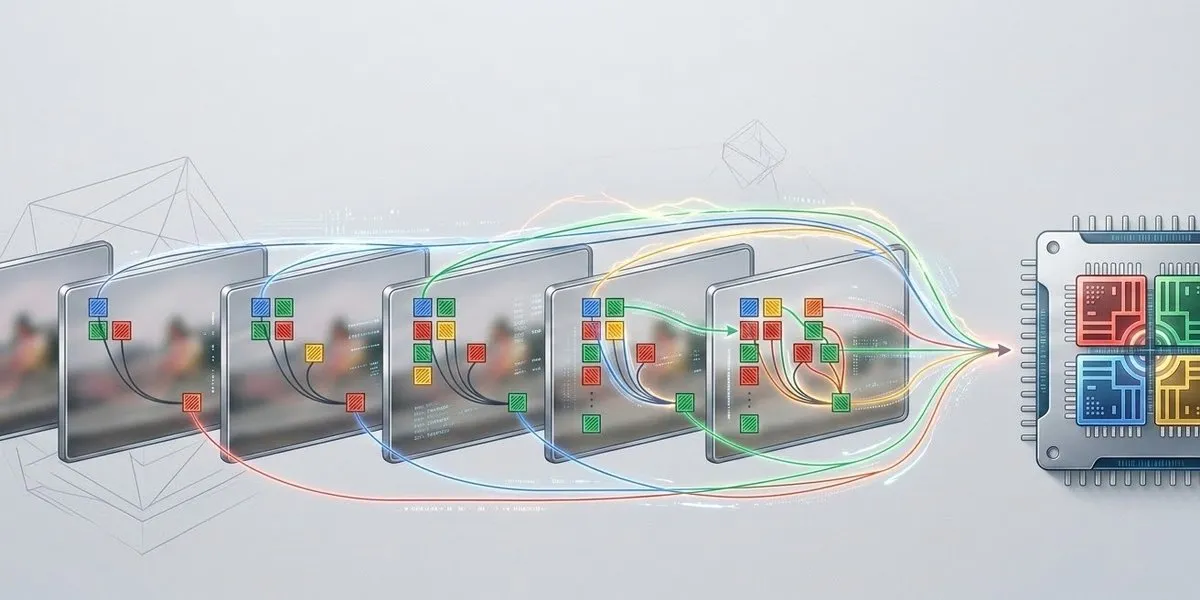
A Google mérnökei olyan ritka figyelmi eljárást valósítottak meg TPU-kra, amely a videódiffúziós modellek egyik legnagyobb késleltetési forrását célozza. Egy tesztben az optimalizált kernel 31 százalékkal gyorsabb volt a sűrű figyelmi megoldásnál.
- A videódiffúziós modellekben az önfigyelem a zajtalanítási lépések egyik fő késleltetési forrása.
- Az SVG térbeli és időbeli figyelmi maszkokkal hagyja ki a kevésbé fontos kapcsolatokat.
- Az első ritka kernel 96,37 ezredmásodperc alatt futott, lassabban a sűrű Splash megoldásnál.
- A teljes és határ menti csempék külön kezelésével 54,12 ezredmásodpercre csökkent a késleltetés.
- A Google mérése szerint ez 31 százalékkal jobb eredmény volt a sűrű Splash kernelhez képest.
A videók hosszú sorozatok feldolgozása lassítja a generálást
A Google Developers Blog szeptember 30-i bejegyzése szerint a videódiffúziós modellek futását két fő tényező lassítja: sok zajtalanítási lépésre van szükség, és minden egyes lépés költséges. A nagy videósorozatoknál az önfigyelem, vagyis a modell tokenjei közötti kapcsolatok kiszámítása, önmagában is a késleltetés egyik legnagyobb forrása lehet.
Egy 81 képkockás, 720p felbontású videó sorozathossza a Google szerint a jelenlegi, népszerű nyílt forráskódú videógeneráló modelleknél 50 ezertől 400 ezerig terjedhet. A felbontás 720p-ről 1440p-re, vagyis 2K-ra emelése négyszeresére növelheti a sorozat hosszát. Mivel a teljes figyelmi művelet költsége négyzetesen nő a sorozathosszal, annak részesedése egy transzformerréteg késleltetéséből 55,5 százalékról 88,2 százalékra emelkedhet.
A Sparse VideoGen a figyelmi fejek mintázatait használja ki
A sűrű figyelem minden lekérdezés és kulcs közötti kapcsolatot kiszámol, a ritka figyelem viszont maszkkal csak a fontosabb kapcsolatokat tartja meg. A Google által bemutatott Sparse VideoGen, röviden SVG, abból indul ki, hogy a videógeneráló modellek figyelmi fejei gyakran két típusba sorolhatók.
A térbeli fejek főként ugyanazon vagy közeli képkockák képpontfoltjaira figyelnek. Az időbeli fejek szűkebb térbeli területet követnek végig sok képkockán, így a helyi mozgások megragadására alkalmas mintázatot mutatnak. Az SVG futás közben néhány lekérdezést mintavételez, majd összeveti a sűrű, a térbeli és az időbeli figyelem kimenetét. Ezután azt a ritka maszkot választja, amelyik a legkevésbé tér el a sűrű alaptól.
Mindkét maszk teljes figyelmet tart fenn az első képkockára, amely a Google leírása szerint a jelenet globális megjelenését rögzítő figyelmi horgonyként működik. A maszk emellett helyi sávot használ a képkockák közötti kapcsolatokhoz.
A ritkaság önmagában nem garantál gyorsulást
A Google egyetlen TPU v6e eszközön, 75 600 tokennel, 10 figyelmi fejjel és 128-as fejmérettel hasonlította össze a saját JAX- és Pallas Splash Attention kernelmegoldásait. A ritka változatok a lekérdezés és kulcs közötti párok körülbelül 38,87 százalékát tartották meg. A közölt mérések kizárólag a figyelmi kernel futását vizsgálták, a fejirányítást, a tokenek átrendezését és az eszközök közötti kommunikációt nem.
Az első, egyszerű ritka megoldás a párok körülbelül 61 százalékát hagyta ki, mégis 96,37 ezredmásodperc alatt futott le, szemben a sűrű Splash 78,70 ezredmásodpercével. Ennek oka, hogy a meglátogatott számítási csempéken belül továbbra is minden egyes elemet maszkolni kellett.
A következő változat külön kezelte a teljes és a határ menti csempéket. A teljes csempék maszkolás nélkül, gyorsított útvonalon futottak, míg a pontos koordinátamaszkot csak a határ menti csempéken alkalmazták. A késleltetés így 54,12 ezredmásodpercre csökkent. Ez 44 százalékos javulás az első ritka megoldáshoz képest, és 31 százalékkal alacsonyabb érték a sűrű Splash mérésénél.
A hardveres megvalósítás dönti el a gyakorlati eredményt
A bemutatott eset azt mutatja, hogy az elméleti ritkaság és a tényleges hardveres gyorsulás között jelentős különbség lehet. A csempék három csoportba kerülnek: a teljes csempék változtatás nélkül feldolgozhatók, a határ mentiek részletes maszkolást igényelnek, az üres csempék pedig teljesen kihagyhatók.
A Google szerint a további optimalizálásban a csempeméret is fontos kompromisszumot jelent. A kisebb csempék pontosabban követhetik a maszk határát, így kevesebb csempén szükséges elemenkénti maszkolás, de a csempeméret az adatmozgatást és a számítások csoportosítását is megváltoztatja. A kutatás jelentősége ezért a TPU-kon futó videógenerálás gyakorlati gyorsításában rejlik, ahol a maszkolási módszer mellett annak hardveres végrehajtása is meghatározza a késleltetést.
Google for Developers: Accelerating Spatio-Temporal Attention for Video Diffusion on TPUs- Google Developers Blog