A Google TPU-kon gyorsítaná a videógenerálás figyelmi rétegét
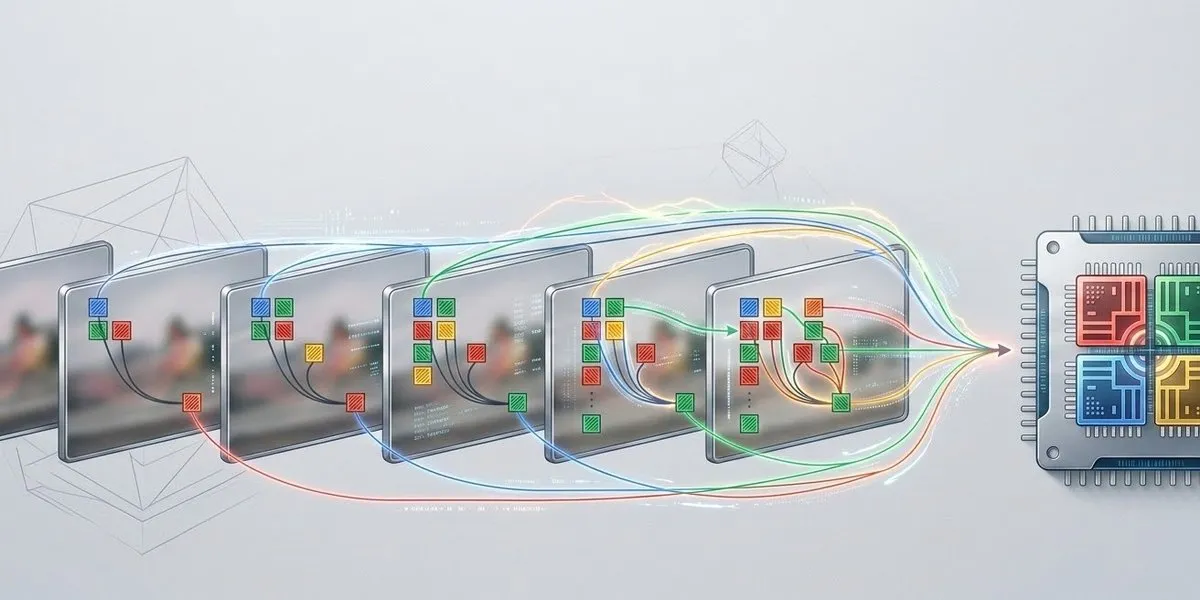
A Google mérnökei olyan ritkított figyelmi megoldást (sparse attention) mutattak be, amely a videódiffúziós modellek TPU-s futtatását gyorsíthatja. A módszer a kevésbé fontos lekérdezés és kulcs közötti kapcsolatokat hagyja ki, miközben a figyelmi mintázatot a modell működéséhez igazítja.
- A 81 képkockás, 720p-s videók szekvenciahossza 50 ezer és 400 ezer token között lehet.
- A ritkított figyelem a kevésbé fontos lekérdezés és kulcs közötti párokat hagyja ki.
- A naiv ritkított kernel 96,37 milliszekundum alatt futott, a sűrű változat 78,70 milliszekundum alatt.
- A teljes és határ menti csempék külön kezelésével 54,12 milliszekundumra csökkent a késleltetés.
- A bemutatott mérés egyetlen TPU v6e chipen, szintetikus BF16 bemenetekkel készült.
A videók feldolgozásánál a figyelem a szűk keresztmetszet
A videódiffúziós modellek működését két tényező lassítja: sok zajtalanítási lépésre van szükség, és minden egyes lépés költséges. Hosszú videószekvenciáknál az önfigyelem (self-attention) egyetlen zajtalanítási lépés késleltetésének egyik legnagyobb forrása lehet.
A Google Developers Blog szeptember 30-i bejegyzése szerint 81 képkockányi, 720p felbontású videónál a szekvencia hossza a jelenlegi, népszerű nyílt forráskódú videógeneráló modellekben 50 ezer és 400 ezer közé eshet. A 720p felbontásról 1440p-re, vagyis 2K-ra váltva a szekvencia hossza négyszeresére nőhet. Mivel a teljes figyelem számítási költsége a szekvenciahossz négyzetével skálázódik, a művelet egy transzformerblokk rétegen belüli késleltetésének részesedése 55,5 százalékról 88,2 százalékra emelkedhet.
A Sparse VideoGen a figyelmi fejeket osztályozza
A sűrű figyelem minden lekérdezés és kulcs közötti kapcsolatot kiszámol, akkor is, ha annak csekély a jelentősége. A ritkított figyelem ezzel szemben maszkkal csak a fontosabb kapcsolatokat tartja meg. A Google által bemutatott megközelítés a Sparse VideoGen, röviden SVG munkájára épít.
Az SVG szerint a figyelmi fejek gyakran térbeli vagy időbeli fejként jellemezhetők. A térbeli fejek főként ugyanazon vagy közeli képkockák képpontfoltjaira figyelnek, míg az időbeli fejek kisebb térbeli régiót követnek végig sok képkockán keresztül. Egy bemutatott példában a térbeli fej a figyelmi tömeg 94,8 százalékát szélesen osztotta el a lekérdezés képkockáján.
Az SVG futás közben profilozza a fejeket. Néhány lekérdezésnél kiszámolja a sűrű, a térbeli és az időbeli figyelem kimenetét, majd azt a ritkított maszkot választja, amelyik a legkevésbé tér el a sűrű alapértéktől. Mindkét maszk teljes figyelmet tart fenn az első képkockára, amely a globális jelenet megjelenését rögzítő figyelmi horgonyként szolgál.
A TPU-kernel kialakítása döntőnek bizonyult
A Google mérnökei JAX- és Pallas Splash Attention-kernelt hasonlítottak össze egyetlen TPU v6e chipen. A mérés szintetikus BF16 bemenetekkel, 75 600 tokennel, 10 figyelmi fejjel és 128-as fejdimenzióval zajlott. A ritkított változatok a lekérdezés és kulcs közötti párok körülbelül 38,87 százalékát tartották meg.
A kezdeti, naiv ritkított bejárás 96,37 milliszekundumos késleltetést produkált, miközben a sűrű Splash 78,70 milliszekundum alatt futott le. Ez azt jelentette, hogy a ritkítás ellenére a megoldás 22 százalékkal lassabb volt. Ennek oka, hogy a kernel a meglátogatott csempéken belül továbbra is kiszámolta a pontos maszkot.
A következő változat külön kezelte a teljes és a határ menti csempéket. A teljes csempék maszkolás nélkül, gyors útvonalon futottak, a koordinátamaszkolásra csak a határ menti csempéknél volt szükség. A késleltetés így 54,12 milliszekundumra csökkent. Ez 44 százalékos javulás volt a naiv ritkított bejáráshoz képest, és 31 százalékkal alacsonyabb érték a sűrű Splash mérésénél.
A bejegyzés szerint a csempeméret további kompromisszumokat hoz. A kisebb csempék pontosabban követhetik a maszk határát, de a csoportosítás és az adatmozgatás miatt a kevesebb határ menti munka önmagában nem garantálja a legalacsonyabb késleltetést.
Google for Developers: Accelerating Spatio-Temporal Attention for Video Diffusion on TPUs- Google Developers Blog