A Google módszere gyorsabbá teheti az összetett AI-keresést
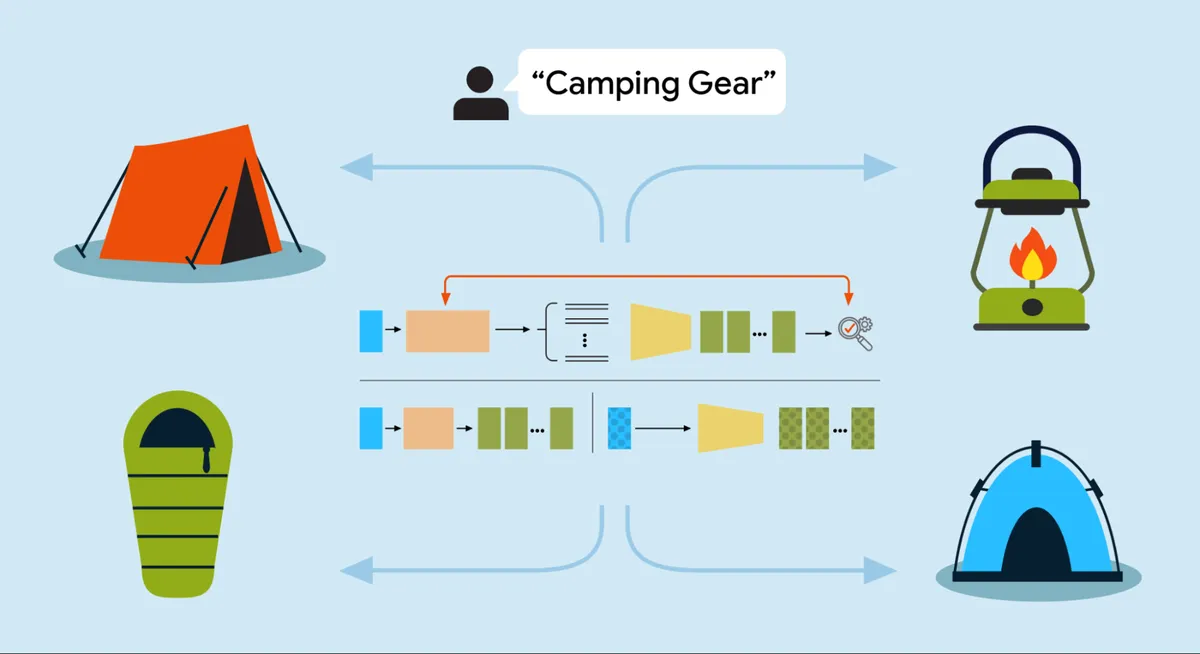
A Google Research olyan keretrendszert mutatott be, amely az összetett keresési feladatokhoz szükséges gondolkodást előre, a tanítás során végezné el. A Retrieve-for-Train egy könnyű diffúziós modellt használ, hogy a keresés pillanatában egyetlen lépésben állítson elő egymást kiegészítő részlekérdezéseket.
- A Retrieve-for-Train az inference helyett offline tanításba helyezi a keresési bontás nehéz számításait.
- Egy 53,9 millió paraméteres diffúziós modell egy menetben állít elő teljes célkészleteket.
- A jutalmazás a groundedness, a diversity és az alignment egyensúlyára épül.
- A módszer célja a változatos, egymást kiegészítő és adatbázisban visszakereshető találati készlet.
A keresőnek nem egyetlen találatra kell optimalizálnia
A modern kereső- és ajánlórendszerektől egyre gyakrabban várják el, hogy ne csak egyetlen jó találatot adjanak, hanem összefüggő találati készletet állítsanak össze. Ha valaki például kempingfelszerelésre keres, a cél nem tíz, egymáshoz hasonló négyszemélyes sátor megjelenítése, hanem egy olyan összeállítás, amelyben sátor, hálózsák, hordozható főző és fejlámpa is szerepel.
Az ilyen feladatok egyik megoldása a lekérdezés szétbontása, vagyis a query fan-out. A rendszer az általános felhasználói kérést több kapcsolódó részlekérdezésre bontja, hogy különböző érdeklődési irányokat fedjen le. A Google Research szerint ezt a munkát az általános, előre betanított nyelvi modellek nehezen végzik hatékonyan.
Miért lassú a hagyományos megközelítés?
A Google kutatói szerint a nulla példás, általános nyelvi modellek gyakran ismétlődő, egymáshoz közeli lekérdezéseket generálnak. Ezt a jelenséget paraphrastic collapse-nak nevezik. A „Bohemian festival style” kérésből például könnyen születhet a „bohemian festival fashion” és a „bohemian festival clothes”, miközben a hasznosabb irányok között rojtos dzsekik, horgolt ruhák vagy velúr csizmák is szerepelhetnének.
A másik gond az autoregresszív működés. A modell a részlekérdezéseket egymás után, tokenről tokenre állítja elő, és a Google szerint összetett bontási feladatoknál akár több száz köztes gondolkodási tokent is felhasználhat. Ez növeli a késleltetést, miközben egy keresőmezőben a másodperc alatti válaszidő fontos követelmény.
A Retrieve-for-Train háromlépcsős módszere
A Retrieve-for-Train a nehéz számításokat a felhasználói lekérdezés feldolgozása helyett egy egyszeri, offline megerősítéses tanítási folyamatba helyezi át. A rendszer először egy fan-out nyelvi modellt tanít meg arra, hogy olyan részlekérdezéseket hozzon létre, amelyek egy teljes találati készlet szintjén teljesítenek jól.
A második lépésben a rögzített fan-out modell emberi címkék nélkül, offline előállítja a lekérdezés és a célkészlet párosait. Ezután egy kompakt, 53,9 millió paraméteres diffúziós modell megtanulja, hogyan képezzen egy lekérdezés beágyazásából közvetlenül egy teljes célkészletet. A Google leírása szerint ez egyetlen, nem autoregresszív menetben történik, szöveges gondolkodási tokenek előállítása nélkül.
A jutalmazás a teljes találati készletet vizsgálja
A módszer központi eleme az összetett jutalmazás. A kutatók a Gemma3-4B és a Qwen3-4B, 4 milliárd paraméteres, nyílt forráskódú modelleket hangolták megerősítéses tanulással. A jutalom három szempontot egyensúlyoz: a groundedness azt ellenőrzi, hogy a részlekérdezések valódi, az adatbázisban visszakereshető elemekhez kapcsolódjanak, a diversity a készlet szemantikai változatosságát méri, az alignment pedig az eredeti, általános kéréshez való kötődést biztosítja.
A Google Research szerint ezek a szempontok egymást ellensúlyozzák. A kizárólag adatbázis-közelségre optimalizált modell értelmetlen, de technikailag megfelelő karakterláncokat hozhatna létre. Az igazodás hozzáadása ismétlődő átfogalmazásokhoz vezethetne, ezért van szükség a változatosságot mérő Vendi Score-ra is.
A módszert a szerzők az ICML 2026 konferenciára benyújtott, „Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion” című tanulmányukban ismertetik. A Google Research bejelentése 2026. szeptember 15-én jelent meg. A forrás két vizsgálati környezetet említ, köztük a nyílt végű absztrakt visszakeresést és a gyengén felügyelt kompozíciós visszakeresést.
Google Research: Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train