A Google új módszere hatékonyabban tanítja az MI-t eszközhasználatra
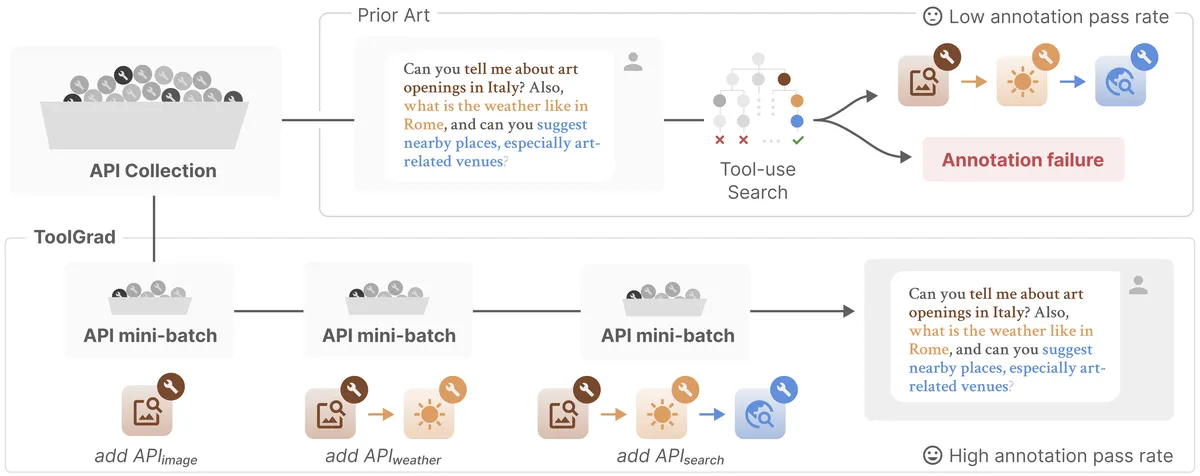
A Google Research ToolGrad nevű keretrendszere megfordítja az MI-eszközhasználati adatok előállításának megszokott sorrendjét. A rendszer előbb létrehoz egy ellenőrzött eszközhasználati láncot, és csak ezután készíti el a hozzá tartozó felhasználói kérést.
- A ToolGrad előbb generál eszközhasználati láncot, majd ehhez felhasználói kérést.
- A keretrendszer négy modulban javasolja, futtatja, kiválasztja és frissíti az API-hívásokat.
- A ToolGrad-12B 83,1-es pontszámot ért el a Berkeley Function Calling Leaderboardon.
- A Google Research szerint a módszer költséghatékonyabban készít összetett adatokat.
- A kutatók a rendszert dinamikus API-környezetekben és személyre szabott tanulásra is bővítenék.
Előbb a megoldás, utána a kérés
A nagy nyelvi modelleknek meg kell tanulniuk, hogyan használják helyesen és hatékonyan a külső eszközöket. Ilyen lehet például a Google Search használata, helyi számítógépes fájlok beolvasása vagy egy létrehozott Python-szkript futtatása. Ehhez olyan adatkészletekre van szükség, amelyek eszközhasználati láncokat és az azokhoz tartozó felhasználói kéréseket tartalmaznak.
A korábbi, lekérdezésközpontú módszerek először egy elképzelt felhasználói utasítást generáltak, majd egy ügynök próbálta megkeresni az ehhez tartozó eszközhasználati útvonalat. A Google Research szerint ez a megközelítés költséges és hatástalan lehet, mivel a rendszer próbálkozásokkal és hibákkal keresi ki a használható megoldást.
A 2026. szeptember 10-én bemutatott ToolGrad ezzel szemben előbb generálja a helyes eszközhasználati láncot, majd ehhez írja meg a felhasználói kérést. A kutatók szerint egy kész, egyértelmű megoldásból könnyebb olyan lekérdezést készíteni, amely pontosan illeszkedik az alkalmazott eszközökhöz.
Négy modul építi fel az API-munkafolyamatot
A ToolGrad négy, egymás után működő modult használ. Az API Proposer egy kiválasztott API-készletből néhány ígéretes jelöltet választ ki a munkafolyamat következő lépéséhez. Az API Executors ezeket párhuzamosan lefuttatja, és részletes végrehajtási jelentéseket készít.
Az API Selector áttekinti a jelentéseket, majd kiválasztja a legjobban teljesítő API-hívást. Ez a kiválasztás szöveges visszajelzésként, úgynevezett szöveges gradiensenként irányítja a következő lépést, és hozzáadja a hívást a munkafolyamathoz. Végül az LLM Updater módosítja a szintetikus felhasználói kérést és az MI válaszát, hogy azok megfeleljenek az új API-készletnek.
A folyamat ismétlésével egy olyan adatminta jön létre, amely felhasználói kérést, ellenőrzött API-munkafolyamatot és végső MI-választ tartalmaz. A módszer a TextGrad nevű megközelítésből veszi át a szöveges visszajelzés ötletét, amelyben egy nyelvi modell kritikája segíti a szöveges utasítások javítását.
A Gemma-modellek teljesítménye is javult
A kutatók a ToolBench több mint 16 ezer valós API-t tartalmazó adatbázisát használták. A ToolGradot a korábbi, mélységi keresést alkalmazó módszerrel hasonlították össze. A Google Research beszámolója szerint az új megközelítés összetettebb, hosszabb eszközhasználati adatokat tud létrehozni alacsonyabb generálási költség mellett, miközben magasabb az elfogadási arány.
A kutatók ToolGrad-500 néven kisebb adatkészleteket is létrehoztak, majd ezekkel Gemma-3 modelleket finomhangoltak. Az 1B, 4B és 12B paraméteres változatokból létrehozott ToolGrad-modelleket a Berkeley Function Calling Leaderboard tesztjén értékelték, amely a ToolBenchétől eltérő eszközkészletet használ.
A ToolGrad-12B 83,1-es pontszámot ért el. Ez közel volt a gemini-2.5-pro 83,2-es és a claude-4.5 Opus 82,8-es eredményéhez, miközben meghaladta a GPT-5 74,4-es pontszámát. A Google közlése szerint a finomhangolt modellek minden vizsgált méretben javultak az alapmodellekhez képest. A ToolGrad-500 adatait a gemini-2.5-flash-lite generálta, a Gemma-3-12B pedig a tesztben még ezt a tanármodellként használt rendszert is felülmúlta.
A kutatás az ügynöki rendszerek skálázását célozza
A Google Research szerint a ToolGrad adatgenerálásban közel 100 százalékos átmenési arányt ér el. A kutatók egy ábrán 99,8 százalékos pass rate-et is feltüntetnek a ToolBenchhez képest, kevesebb művelettel. A megközelítés így a drága és nehezen skálázható, próbálkozáson alapuló adat-előállítás helyett sikeres API-láncokra épít.
A kutatás következő iránya a rendszer kiterjesztése nagyobb és dinamikusabb API-környezetekre. A Google emellett azt is vizsgálná, hogyan használható a módszer folyamatos, menet közbeni tanulásra és személyre szabásra. A közlemény szerint ez alapot adhat olyan digitális ügynökök képzéséhez, amelyek összetett feladatokat képesek ellátni, és gazdaságosabban telepíthetők vállalati, illetve mindennapi használatra.
Google Research: ToolGrad: Efficient tool-use dataset generation with textual "gradients"