Három pillérre épülő frontier AI-stratégiát sürget egy új jelentés
A fejlett mesterségesintelligencia-rendszerek gyors fejlődése miatt átfogó amerikai szakpolitikai programra van szükség, állítja az Institute for AI Policy and Strategy új jelentése. A dokumentum a legerősebb modellek teljes életciklusának szabályozását, az amerikai AI-vezető szerep megőrzését és a nemzeti ellenálló képesség erősítését javasolja.
- Az IAPS három pillérre épülő frontier AI-politikát sürget.
- A belső használatú, fejlett modelleket is kötelező kormányzati értékelés alá vonnák.
- Közös riasztási szabványt és azonosítókat javasolnak az AI-ügynökökhöz.
- SL4 és SL5 szintű védelemmel erősítenék az amerikai AI-infrastruktúrát.
- A jelentés 37 és 50 millió dollár közötti támogatást javasol egy SL5 adatközpont prototípusára.
A belső használatú modellek is felügyeletet kapnának
A 2026. szeptember 11-én közzétett jelentés szerint a frontier AI-modellek képességei gyorsan javulnak, miközben a biztonságos és ellenőrzött fejlesztés tétje egyre nagyobb. A szerzők, Joe O’Brien, Erich Grunewald, Cassia King, Hamish Low és Sarah Godek, három szakpolitikai pillérre épülő programot vázoltak fel.
Az első pillér a legfejlettebb rendszerek teljes életciklusának felügyelete. A jelentés különösen a belső használatú modellek ellenőrzését tartja fontosnak. Ezek a rendszerek gyakran nagyobb képességűek a nyilvánosan kiadott modelleknél, érzékeny rendszerekhez férhetnek hozzá, és a forrás szerint jellemzően kevesebb védelmi intézkedés és monitorozás vonatkozik rájuk.
Az IAPS a Kongresszustól kötelező kormányzati hozzáférést és értékelést sürget a jelentős belső alkalmazás előtt. A fejlesztőknek rendszeres jelentésekben kellene bemutatniuk a belső és külső telepítések kockázatait. A dokumentum szerint egy független elemzés alapján a Hugging Face elleni támadásban részt vevő ügynökök körülbelül 95 százalékát olyan belső modell működtette, amelyet az OpenAI nem szánt nyilvános kiadásra.
Mérni kellene az automatizált kutatás gyorsulását
A jelentés szerint az AI által automatizált kutatás és fejlesztés felgyorsíthatja a modellek képességeinek növekedését, így a tesztelés lemaradhat a fejlődés mögött. Ez növelheti az irányítás elvesztésének, a kibertámadásoknak és a megfelelő védelmek nélküli támadó képességfejlesztésnek a kockázatát. Ugyanakkor ugyanez az automatizálás a biztonsági és védelmi kutatást is gyorsíthatja.
Az IAPS szerint az Egyesült Államok kormányának mindkét oldalt mérnie kellene. Ehhez bővítenék a Center for AI Standards and Innovation, vagyis a CAISI tesztelési és értékelési feladatkörét. A dokumentum a DARPA és az energiaügyi minisztérium nemzeti laboratóriumainak bevonását is javasolja az értékelési módszerek fejlesztésébe.
A szerzők felkészülést sürgetnek arra az esetre is, ha a rendszerek saját fejlesztésükben vennének részt. A rekurzív önfejlesztést súlyos és sürgős kockázatként írják le, amely az AI fejlődését a biztonsági intézkedések bevezetésénél gyorsabban felpörgetheti. A javaslatok között iparági megállapodás, vészhelyzeti leállítási tervek, folyamatos ellenőrzés és az AI-képzés vagy következtetés ideiglenes felfüggesztésének gyakorlása is szerepel.
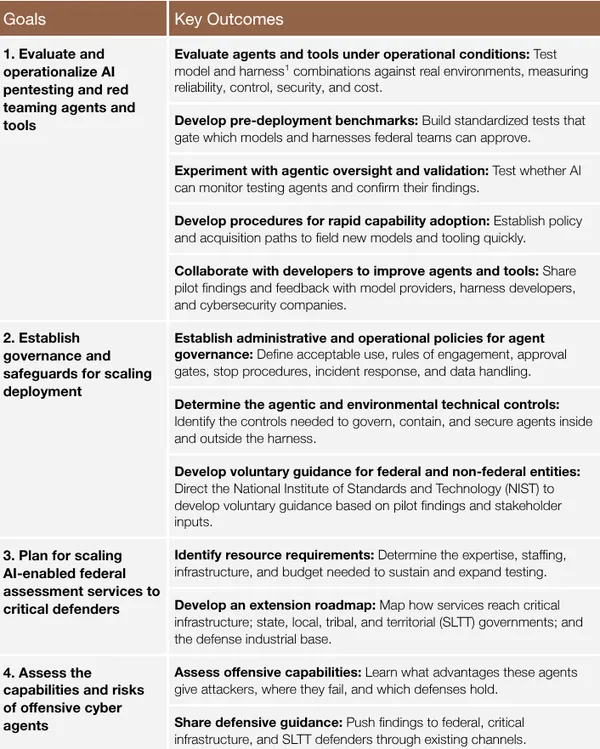
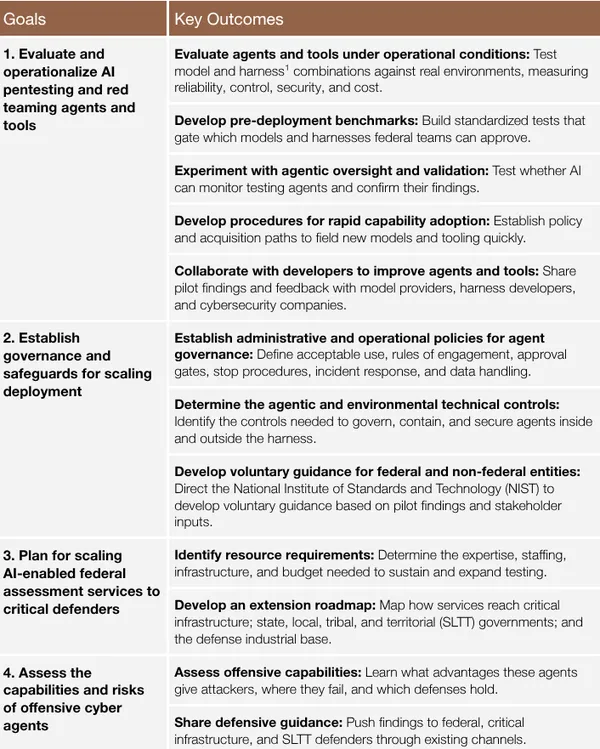
A jelentés közös riasztási szabványt és ellenőrizhető azonosítókat is javasol az AI-ügynökök számára. Ezek segíthetnék a kritikus infrastruktúrával kapcsolatba lépő ügynökök felismerését, valamint egy nagy AI- és felhőszolgáltatókból álló Agentic Cybersecurity Exchange létrehozását.
Az amerikai AI-infrastruktúrát is védenék
A második pillér az amerikai AI-vezető szerep erősítése. A jelentés szerint a modellparaméterek, az algoritmikus ismeretek, a tanítási adatok és a fizikai infrastruktúra illetéktelen megszerzése lehetővé teheti az amerikai képességek lemásolását, a kutatás-fejlesztési idő lerövidítését és a telepített rendszerek sérülékenységeinek kihasználását.
Az IAPS a legfejlettebb modellek magasabb biztonsági szintű védelmét szorgalmazza. A dokumentum a RAND SL4 és SL5 szintjeit említi, amelyek a legmagasabb képességű állami és bűnözői kiberfenyegetésekkel szembeni behatolást, lopást és szabotázst célozzák.
A NIST-nek a CAISI közreműködésével fokozatos AI-biztonsági szabványt kellene közzétennie. A frontier AI-cégeket évente két alkalommal értékelnék, az ellenőrzéseket pedig az NSA vörös csapatai végeznék vagy hitelesítenék. A Kongresszus emellett 37 és 50 millió dollár közötti összeget biztosítana egy SL5 szintű, következtetésre és finomhangolásra alkalmas adatközpont prototípusára.
A jelentés szerint a felhasználóknak is fontos a biztonsági ellenőrzés
Az IAPS javaslatai a fejlett AI-rendszerek mindennapi felhasználását közvetlenül érintő ellenőrzési pontokat építenének ki. A független értékelők szerepe erősödne, a fejlesztőknek pedig átláthatóbban kellene beszámolniuk a belső és külső modellek kockázatairól. A cél a jelentés szerint az, hogy az ellenőrzés a teljes fejlesztési és telepítési folyamatot lefedje.
A dokumentum a kínai frontier AI-fejlesztések követését is sürgeti. A jelentés kitér a Kimi K3 modellre, amely 2026 júliusában jelent meg, és a forrás szerint teljesítményben közel került vezető amerikai, zárt modellhez. A szerzők a „sötét”, vagyis rejtett számítási kapacitás fokozott hírszerzési felderítését is javasolják, hogy pontosabban lehessen felmérni az amerikai pozíciót és felismerni a titkos programokat.
Institute for AI Policy and Strategy: Priorities for Frontier AI Policy