Harvey: a generatív jutalmazási modellek segíthetik a jogászok értékelését
A Harvey olyan generatív jutalmazási modelleket, GRM-eket vizsgált, amelyek jogászok preferenciái alapján hasonlítják össze az AI-rendszerek válaszait. A vállalat első eredményei szerint ezek a modellek önálló értékelőként és a szakértők munkáját kiegészítve is használhatók.
- A Harvey 24 LAB-feladaton vizsgálta a jogászi és modellpreferenciákat.
- A jogászok az összehasonlítások 25 százalékában értettek egyet egyhangúlag.
- A GRM-ek többek között pontosság, lefedettség, érvelés és stílus alapján értékelnek.
- A GRM bevonásával a panel egyetértése 0,128-ról 0,216-ra nőtt.
- A jogászok körülbelül 64 százalékban értettek egyet a GRM-ek indoklásával.
A jogi válaszok megítélésében nincs teljes egyetértés
A Harvey szerint a jogászi ítélet az egyik legfontosabb mérce annak eldöntésére, hogy fejlődnek-e az AI-rendszerei, és elég jók-e összetett jogi problémák megoldására. A vállalat ezt gyakran egymás melletti értékelésekkel vizsgálja. Ilyenkor egy jogász ugyanarra a feladatra adott két eredményt lát, kiválasztja a számára jobbat, majd indokolja a döntését.
Az így összegyűjtött véleményekből teljesítménymutatókat készítenek. A megerősítéses tanulás emberi visszajelzésből, vagyis az RLHF során ezeket a véleményeket egy jutalmazási modell tanítására használják. A modell azt próbálja előre jelezni, hogy több lehetséges válasz közül melyik felel meg jobban az emberi preferenciáknak.
A Harvey szerint azonban az összetett jogi környezetben a jogászi értékelések sem teljesen egységesek, sem teljesen egyértelműek. A vállalat példaként azt írja, hogy a valós jogi munkában még a magas szintű szakemberek, köztük tárgyalási bírák és fellebbviteli bírák, az esetek 10-15 százalékában eltérő következtetésre jutnak.
A Kimi K3 vizsgálata megmutatta az eltéréseket
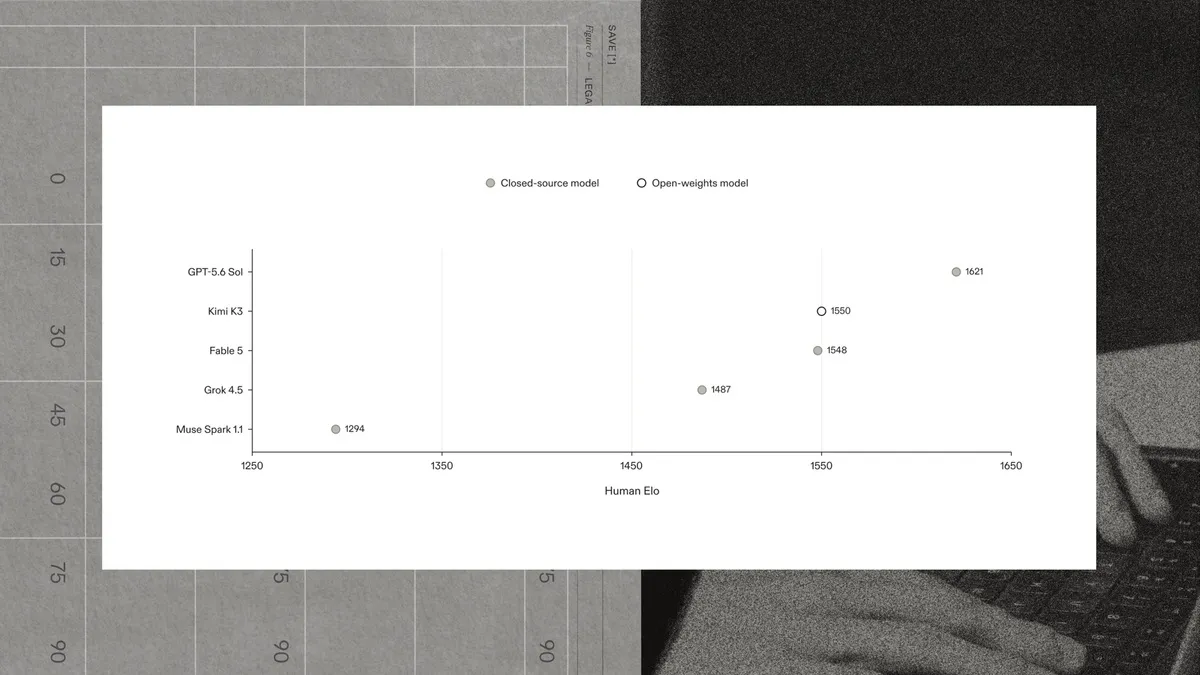
A Harvey a Snorkellel együtt végzett egy preferenciavizsgálatot annak felmérésére, hogy a Kimi K3 megfelelő alapmodell lehet-e a Harvey Tenet tanításához. A modellt négy, az adott időszakban vezetőnek számító laboratóriumi modellhez hasonlították 24 LAB-feladaton. Minden feladatot három, az érintett jogterületen dolgozó jogász értékelt.
A jogászok nagy léptékben képesek voltak teljesítménykategóriákba rendezni a modelleket, az egyes összehasonlításokban azonban jóval bizonytalanabb volt az egyetértés. A szavazások mindössze 25 százalékában értettek egyet egyhangúlag, az egyetértés Fleiss-féle kappája pedig 0,129 volt. Ha csak a három legjobb ELO-értékű modellre szűkítették a vizsgálatot, az egyhangú döntések aránya 11 százalékra csökkent, a Fleiss-féle érték pedig negatív lett.
A Harvey részletesen elemezte az írásos indoklásokat is. Az eltérések 24,3 százalékában fordult elő, hogy a jogászok különböző bizonyítékokra hivatkoztak. Többségük ugyanazokat az előnyöket és problémákat azonosította, de eltérően ítélte meg, mi számít fontosabbnak. Ilyen szempont volt például a stílus és a hallucinációk közötti mérlegelés.
A GRM-ek több szempont alapján hasonlítják össze a válaszokat
A Harvey által vizsgált GRM-ek olyan ügynöki, nagy nyelvi modellre épülő értékelők, amelyek két kimenetet hasonlítanak össze. Először elolvassák a válaszokat, majd összeállítják az összevetés szempontjait, pontozzák a jelölteket, végül feljegyzik az eredményhez vezető indoklást.
A vállalat ezt a folyamatot két elemmel egészítette ki. A GRM-ek alügynököket használhatnak a tények ellenőrzésére az eredeti környezetben, például a bemeneti dokumentumokban és MCP-kben, vagy az interneten. Emellett előre meghatározott tengelyekhez kapcsolják az értékelési szempontokat.
Ezek a tengelyek az állítások pontossága és a hallucinációk hiánya, a releváns pontok lefedettsége, a tények ellenőrizhetősége, az elemzés és ítélet minősége, a feladathoz és a felhasználói utasításokhoz való igazodás, a formázás és bemutatás, valamint a szöveg minősége és olvashatósága. Az egyes szempontoknál a modell -1 és 1 közötti értékkel jelzi, hogy az első vagy a második választ részesíti-e előnyben.
A szakértő és a modell együtt pontosabb képet adhat
A Harvey Applied Legal Research csapatának tagjai úgy hangolták a GRM-eket, hogy nagy vonalakban azt írják le, mire figyelhet egy jogász a felsorolt hét tengelyen. A vállalat szerint a modellek nagyrészt visszaadták a korábbi preferenciavizsgálat emberi rangsorát, és határozottabban különítették el a modelleket ugyanabban az irányban, mint a jogászok.
Ha a GRM-et a három jogász szavazata mellé adták, a panel egyetértése 0,128-ról 0,216-ra nőtt. Ha egy véletlenszerűen kiválasztott jogász helyére került, a nyers panel-egyetértés 44,7 százalékról 59,2 százalékra emelkedett.
A közös értékelés ugyanakkor korlátokat is feltárt. A jogászok és a GRM-ek általában egyetértettek abban, mely szempontok relevánsak, és melyik válasz a jobb. A modell magyarázatával a jogászok csak körülbelül 64 százalékban értettek egyet. A Harvey szerint a GRM-ek időnként fontos hallucinációkat vagy hibákat is feláldoztak más előnyökért, illetve győztest hirdettek két egyaránt rossz válasz között, miközben az emberi értékelők döntetlent adtak volna.
Az eredmények alapján a Harvey a GRM-eket a jogi szakértők kiegészítőjeként kezeli. A modellek elvégezhetik a válaszok áttekintésének, az összehasonlítási pontok azonosításának és az első ajánlás elkészítésének munkáját, miközben a szakértők a vitás és nagyobb jelentőségű ítéletekre összpontosíthatnak.
Harvey: Augmenting Human Preference in Complex Domains | Harvey