Az IBM szerint a modellválasztás valójában rendszerszintű optimalizálás
A modellútválasztás összetettebb a feladatok nehézsége alapján működő osztályozásnál, állítja az IBM Research Hugging Face-en megjelent elemzése. A költséget, a minőséget és a késleltetést egyszerre figyelembe vevő megközelítéssel többféle működési pont választható.
- A Claude Sonnet 4.6 79, a GPT-4.1 155 dollárba került 417 feladaton.
- A gyorsítótárazás jelentősen módosíthatja a modellek tényleges költségét.
- A routernek a költséget, a minőséget, a késleltetést és a megbízhatóságot együtt kell kezelnie.
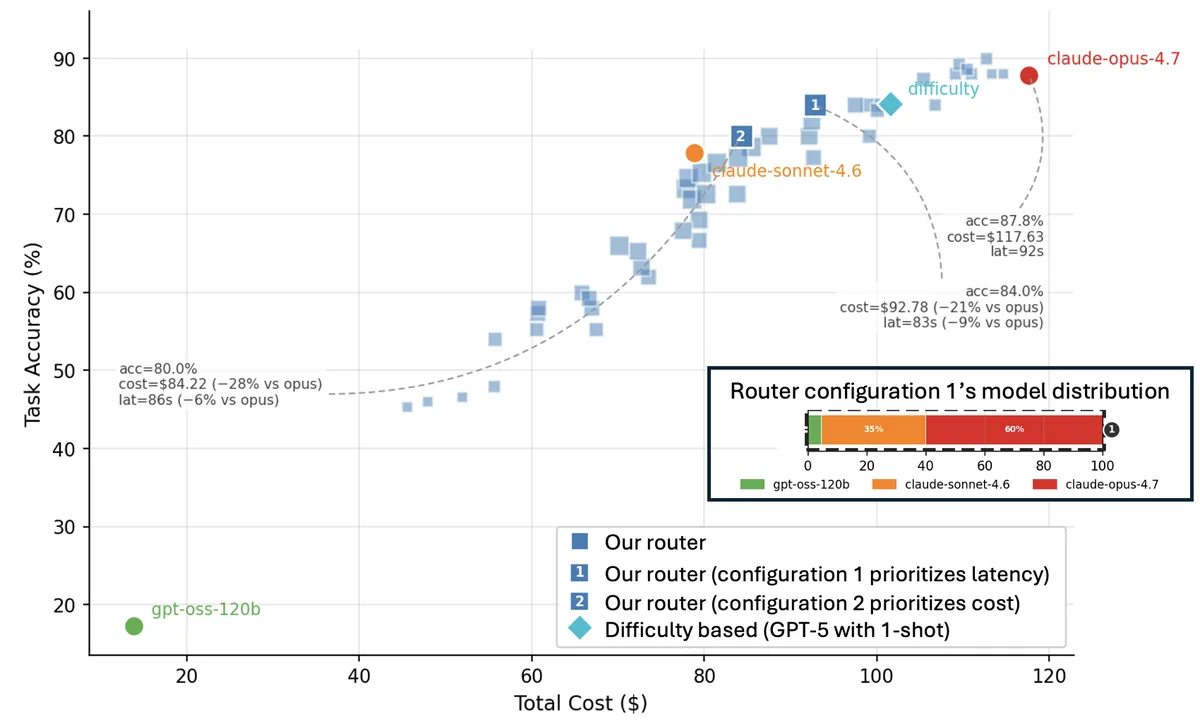
- A késleltetésre optimalizált konfiguráció 84 százalékos pontosságot ért el 93 dollárért.
- Az optimalizálás feladatonként nagyjából 6 ezredmásodpercet és 2 kilobájt memóriát igényelt.
A listaár önmagában félrevezető lehet
Az IBM Research szerzői, Yara Rizk, Eyal Shnarch, Jason Tsay és Merve Unuvar július 15-én publikálták elemzésüket. A kiindulópont az a gyakori elképzelés, hogy az egyszerű kéréseket olcsóbb modellekhez, az összetettebb feladatokat pedig drágább vagy specializált modellekhez kell irányítani. Az ilyen rendszereket sokszor osztályozási problémaként kezelik, az IBM tapasztalata szerint azonban ez gyorsan rendszerszintű optimalizálási feladattá válik.
Az AppWorld Test Challenge 417 feladatán, ugyanazzal a CodeAct-ügynökkel, a Claude Sonnet 4.6 teljes költsége 79 dollár, feladatonként 0,19 dollár volt. A GPT-4.1 ezzel szemben 155 dollárba került, feladatonként 0,37 dollárba, vagyis csaknem kétszer annyiba. Ez annak ellenére történt, hogy a GPT-4.1 bemeneti és kimeneti tokenára is alacsonyabb volt, miközben a Sonnet nagyjából háromszor annyi gondolkodási lépést tett meg.
A magyarázat az IBM szerint a gyorsítótárazás. Az ügynöki munkafolyamatok gyakran ugyanazokat a nagy kontextusrészleteket használják több lépésben, a Sonnet alacsonyabb gyorsítótár-olvasási ára pedig ebben a környezetben jelentősen csökkentette a tényleges költséget. A router ezért nem támaszkodhat kizárólag az árlistákra.
A feladat nehézsége és a válaszidő sem elég önmagában
A nehézség alapján történő útválasztás két okból is problémás lehet. Egy szerződés összefoglalása egyszerű kérésnek tűnhet, közben dokumentum-visszakeresést, megfelelőségi ellenőrzést, eszközhasználatot és több finomítási kört is igényelhet. Egy technikai kérdést viszont egy kisebb, specializált modell is hatékonyan kezelhet. A tényleges nehézség sokszor csak a végrehajtás közben derül ki.
A routereknek közben egyszerre kell mérlegelniük a költséget, a minőséget, a késleltetést és a megbízhatóságot. Vállalati környezetben ehhez megfelelőségi előírások, adatlokalizációs szabályok, adatvédelmi korlátozások és jóváhagyott modell-listák is társulhatnak. Emiatt az ideálisnak tűnő modellhez vezető út nem mindig megengedett.
A felhasználói válaszidőt sem kizárólag a modell mérete határozza meg. A router saját többletterhelése, a futtatáshoz használt hardver, a gyorsítótár állapota és a végpont terheltsége egyaránt számít. A feladatonkénti egyszeri döntés kevés többletet okoz, a végrehajtás minden lépésében történő útválasztás viszont növeli a késleltetést és az üzemeltetési összetettséget.
Több működési pont közül lehet választani
Az IBM Research ezért olyan routert épített, amely nem azt próbálja eldönteni, melyik modell a legjobb egy adott feladatra. Az algoritmus a költséget, a minőséget és a késleltetést egyszerre optimalizálja, miközben a szerzők szerint elég könnyű marad ahhoz, hogy ne váljon szűk keresztmetszetté.
Az AppWorld Test Challenge CodeAct-ügynökével végzett mérésben a router különböző konfigurációi költség és pontosság közötti frontot rajzoltak ki. A késleltetésre optimalizált első konfiguráció 84 százalékos pontosságot ért el 93 dolláros költség és 83 másodperces idő mellett. Ez az Opus önálló futtatásához képest 21 százalékos költségcsökkenést és 9 százalékos késleltetéscsökkenést jelentett, 4 százalékpontos pontosságvesztéssel.
A második konfiguráció ennél is alacsonyabb költséget célzott. Az IBM szerint a hagyományos, nehézség-alapú router hasonló pontossági tartományban maradt, de magasabb költséggel, és nem tárta fel a lehetséges kompromisszumok teljes tartományát. Maga az optimalizálás feladatonként nagyjából 6 ezredmásodpercet és 2 kilobájt memóriát igényelt.
Az elemzés tanulsága a vállalati ügynöki rendszerek fejlesztői számára, hogy a modellválasztást a gyorsítótárazással, az infrastruktúra állapotával, a munkaterheléssel és az irányítási korlátokkal együtt kell kezelni. Az IBM Research további technikai részleteket ígér egy későbbi bejegyzésben.
Hugging Face: Model Routing Is Simple. Until It Isn’t.