Az Owkin szerint a K Pro megbízhatóbban ismétli meg a biológiai elemzéseket, mint a Claude
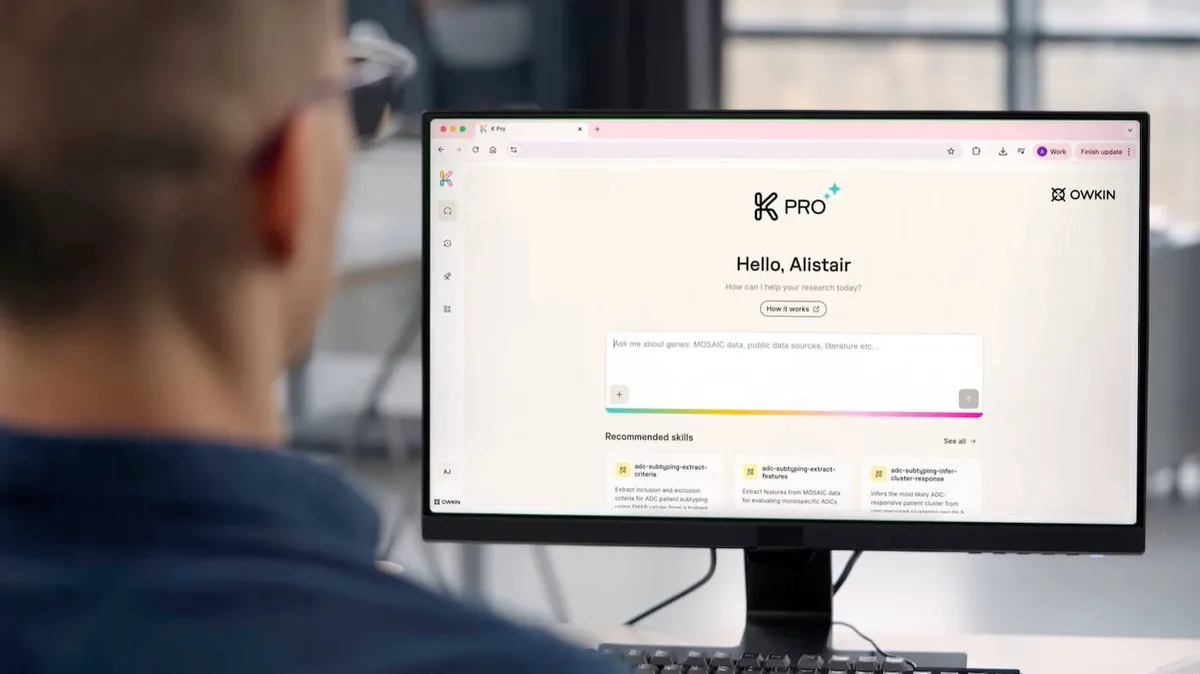
Az Owkin összehasonlítása szerint a K Pro ugyanarra a tudományos kérdésre ismételten nagyobb eséllyel elemzi ugyanazokat a betegeket, mint a Claude. A cég szerint ebben a nyelvi modell mellett működő, biológiai kutatásra szabott eszközrendszernek van döntő szerepe.
- Az Owkin szerint a K Pro 90, a Claude 58 esetben választotta ugyanazokat a betegeket 100 ismétlésből.
- A teszt tíz onkológiai felhasználási esetet és nyolc TCGA-kohorsz adatait vizsgálta.
- A K Pro 46 esetben reprodukálta a publikált eredményt 50 futásból.
- A Claude és a K Pro BioMisteryBench-eredménye 56, illetve 58 pont volt.
- Az Owkin szerint az irányítási réteg az ismételhetőség és a nyomon követhetőség miatt fontos a gyógyszeripari kutatásban.
A különbséget az Owkin szerint a működési réteg adja
Az Owkin szeptember 4-én közzétett bejegyzése a K Pro és a Claude összehasonlítását mutatja be. A cég szerint a két rendszer mögött összehasonlítható, élvonalbeli nyelvi modell áll, a különbség pedig az úgynevezett harness, vagyis a modell és az adatok között működő irányítási és eszközréteg.
A K Pro biogyógyszeripari kutatás-fejlesztésre készült ügynöki mesterségesintelligencia-platform. Az Owkin leírása szerint célterületei közé tartozik a célpontfelfedezés, a transzlációs elemzés és a számításos biológusok napi munkája. A platformot számításos biológusok, biostatisztikusok, gépi tanulási kutatók és klinikai tudósok fejlesztették, az Owkin pedig több mint egy évtizednyi, nagy gyógyszergyártókkal folytatott együttműködésről ír.
A cég szerint a Claude általános célú működési réteget használ, míg a K Pro irányítása és célzott eszközei a biológiai elemzések menetét rögzítik. Ez meghatározhatja például, mely betegek kerülnek be az elemzésbe, milyen számítás történik, és hogyan jelenik meg az eredmény.
A tesztben a K Pro gyakrabban jutott ugyanahhoz a kohorszhoz
Az Owkin tíz, onkológiai szakirodalomból származó felhasználási esetet vizsgált nyolc TCGA-kohorszban. A példák között szerepelt betegek szétválasztása egy gén kifejeződése alapján, a daganatos és a szomszédos normál szövet összehasonlítása, mutációs gócpontok feltérképezése és betegek csoportosítása génpanelek alapján.
Minden kérdést ötször futtattak le három feltétel mellett. Az elsőben a Claude-nak magának kellett megtalálnia a TCGA-adatokat. A másodikban ugyanazt a modellt az Owkin által előkészített nyilvános adatokkal használták. A harmadikban a K Pro ugyanazt a modell- és adatcsomagot kapta, kiegészítve saját irányítási rétegével és célzott eszközeivel. A három feltételben azonos kérdéseket, azonos homokozót és összevethető költést alkalmaztak, összesen 150 elemzésben.
Az egymást követő futások közül a nyers Claude 51, a feldolgozott adatokkal használt Claude 58, a K Pro pedig 90 esetben választotta ugyanazt a kohorszt 100-ból. Az öt futás során ugyanazt a kohorszt a Claude 2, a feldolgozott adatokkal használt változat 3, a K Pro 8 esetben tartotta meg a tíz felhasználási esetből.
A publikált eredmény reprodukálásában rendre 40, 43 és 46 siker született 50 futásból, ami 80, 86 és 92 százalékot jelentett. Mind az öt futás helyességét a három változat közül rendre 6, 7 és 8 esetben sikerült elérni.
A pontosság mellett az ismételhetőség is számít
Az Owkin egyik részletes példája a TCGA gyomor-adenokarcinómájában vizsgálta, hogy a MUC16-mutációval rendelkező és az ilyen mutációval nem rendelkező betegek között eltér-e a tumor mutációs terhelése, illetve van-e kapcsolat a mutációs státusz és a nyirokcsomó-áttét között.
Mind a 15 futást helyesnek ítélték, és mindhárom feltétel ugyanarra a következtetésre jutott: a mutáns csoport tumor mutációs terhelése magasabb, a nyirokcsomó-érintettséggel viszont nincs szignifikáns kapcsolat. Az Owkin szerint az eltérő részletek mégis megmutatták az ismételhetőség problémáját. A nyers Claude egyik futása 198 beteg részleges adataival dolgozott, miközben a többi futás 431 beteget használt. A feldolgozott adatokkal végzett futásokban pedig a mutáció definíciója és a klinikai táblával végzett összekapcsolás változott.
Az Owkin szerint a gyógyszeripari kutatásban az eredmény akkor használható igazán, ha egy kolléga a következő héten újrafuttatva ugyanahhoz a betegcsoporthoz és ugyanahhoz az elemzési menethez jut. A vállalat összehasonlításában a Claude 56, a K Pro 58 pontot ért el az Anthropic BioMisteryBench benchmarkján, azokra a feladatokra pedig, amelyekre nem hangolták külön a K Pro-t. Az Owkin ebből azt a következtetést vonja le, hogy a célzott működési réteg a pontosság feláldozása nélkül javíthatja a reprodukálhatóságot és az eredmények védhetőségét.
Owkin: How does K Pro compare to Claude?