Három rétegben méri az Owkin a tudományos AI-ügynök megbízhatóságát
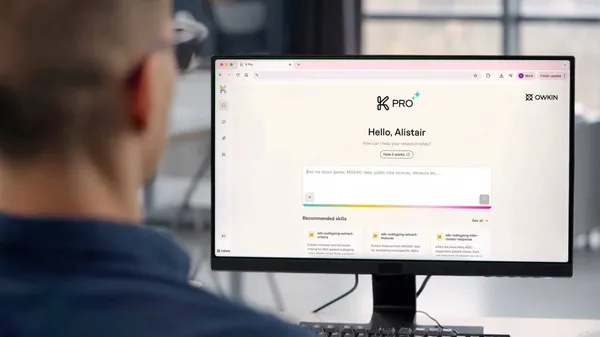
Az Owkin háromszintű értékelési rendszert dolgozott ki K Pro nevű, biomedicinális kutatást segítő AI-ügynökéhez. A módszer az egyes eszközhívásokat, a teljes munkafolyamatot és a végső választ is vizsgálja.
- Az Owkin három rétegben értékeli a K Pro AI-ügynököt.
- A pass@k a legalább egy sikeres, a pass^k a minden próbálkozásban sikeres működést méri.
- A rendszer az eszközhívásokat és azok paramétereit is automatikusan ellenőrzi.
- Külön vizsgálják, hogy az ügynök a megfelelő lépéseket és sorrendet követte-e.
- Nyitott feladatoknál nyelvi modell és szakértők is értékelhetik a válasz minőségét.
Miért nem elég a hagyományos modelltesztelés?
Az Owkin július 6-i bejegyzése szerint a hagyományos gépi tanulási értékelés jellemzően egy bemenetet és egy helyesnek tekintett kimenetet hasonlít össze. Ez akkor működik jól, ha a modell rögzített bemenetre egyetlen, meghatározott választ ad.
Az AI-ügynökök működése ennél összetettebb. Egyetlen kérdés több eszközhívást, köztes döntést és eltérő kimenetet eredményezhet. Ugyanaz a kérdés több futtatás során különböző útvonalon vezethet helyes válaszhoz, ezért az egyetlen futásból számított pontosság nem írja le megfelelően a rendszer képességeit.
Az Owkin ezt a különbséget megbízhatatlansági keretnek nevezi. Ez a különbség aközött, amire a rendszer legalább egyszer képes, és aközött, amit minden alkalommal megbízhatóan végrehajt. A pass@k azt méri, hogy a rendszer k próbálkozásból legalább egyszer helyesen válaszol-e, a pass^k pedig azt, hogy mind a k próbálkozás sikeres-e.
A vállalat példája szerint ha a K Pro tízből kilencszer sikerrel válaszol, az elfogadható lehet hipotézisek létrehozásánál, ahol a kutató áttekinti az eredményt. Egy klinikai döntéstámogató munkafolyamatban ugyanilyen arány már tízből egy hibát jelentene. Az elfogadható megbízhatatlansági keretet ezért a feladat kockázata határozza meg.
Első réteg: az egyes eszközhívások ellenőrzése
Az első értékelési réteg minden eszközhívást önálló egységként vizsgál. Két kérdésre keresi a választ: az ügynök a megfelelő eszközt hívta-e meg, és helyes paramétereket adott-e át.
A megfelelő eszköz kiválasztása viszonylag egyértelműen ellenőrizhető. Nehezebb megállapítani, hogy az ügynök pontosan értelmezte-e a felhasználó szándékát, majd ezt megfelelően strukturált lekérdezéssé alakította-e. Ha például egy felhasználó egy adott betegcsoportban alkalmazott rákgyógyszerre kérdez rá, a rendszernek a megfelelő betegséget és kezelési fázist is át kell adnia a kereséshez.
Az Owkin szerint minden fejlesztői módosítás magában hordozza annak kockázatát, hogy a rendszer egy korábban jól teljesített feladatban romlik. A K Pro értékelési rendszere ezért naponta több száz reprezentatív kérdést küld az AI-nak, majd az elvárt eszközhívások és paraméterek alapján ellenőrzi az eredményeket. A minimális teljesítménykövetelmények automatikusan érvényesíthetők, így a korábbi, akár hetekig tartó kézi tesztelés folyamatos visszacsatolássá válik.
Második és harmadik réteg: a helyes út és a tudományos válasz
A második réteg azt vizsgálja, hogy az ügynök a rendelkezésére álló eszközök mellett a megfelelő lépéssorozatot követte-e. Minden tesztkérdéshez elvárt útvonalat rendelnek, például a klinikai vizsgálatok adatainak lekérését, szűrését, majd ábra készítését. Egyes feladatoknál szigorúan meghatározott sorrendre van szükség, más esetekben elegendő, ha minden szükséges lépés megtörténik.
Ez a réteg azt is ellenőrzi, hogy a kötelező eszközt valóban meghívták-e, illetve a szükségtelen eszközöket elkerülték-e. Az Owkin szerint egy rosszul megválasztott eszköz nem feltétlenül okoz látványos rendszerhibát. Az ügynök ilyenkor akár magabiztos, jól formázott, de kitalált választ is adhat. Ilyen eset lehet, ha egy gyógyszercélpontról szóló szakirodalmi összefoglalónál a rendszer megkerüli az irodalomkeresést, és kizárólag az emlékezetére támaszkodik.
A harmadik réteg már azt méri, hogy az ügynök teljesítette-e a felhasználó szándékát. Az egyértelmű, egyetlen helyes választ igénylő kérdéseknél ez a válasz és az ismert igazság összevetésével történhet. Nyitottabb feladatoknál egy második nyelvi modell, az úgynevezett LLM-as-judge értékeli a generált és az elvárt válasz jelentésének egyezését. A bonyolultabb feladatoknál külön pontozhatják a tényszerűséget, a teljességet és az általános minőséget, a legösszetettebb esetekben pedig szakértők vizsgálják a választ.
A K Pro benchmarkfeladatai többek között biomedicinális adatbázisokból történő tényszerű információkinyerést, publikált szakirodalom szintézisét, több omikai adat elemzését, gyógyszerkutatást és genomikai feladatokat fednek le. A felhasználók számára ez azt jelenti, hogy a rendszer értékelése nem áll meg a végső válasz formai ellenőrzésénél. Az Owkin megközelítése az eszközhasználatot, a döntési útvonalat és a tudományos tartalmat együtt kezeli, ami a vállalat szerint a fejlesztés és a kiadások megbízhatóságát is támogatja.
Owkin: A Practical Map of Evaluation for Agentic Systems