Az Anthropic Claude-ja éles ügynökök nyomaiból épít teszteket
Az Anthropic Claude-ja két új paranccsal támogatja az AI-ügynökök tesztelését és fokozatos javítását. Az Arize AI szerint a módszer akkor válik igazán használhatóvá, ha az értékelések alapját a termelési környezetből származó nyomok adják.
- A Claude új parancsai értékelést építenek és egyesével javítják az alkalmazást.
- Az Anthropic szerint a tesztfeladatoknak a termelési használatot kell tükrözniük.
- A termelési nyomok új hibák megjelenésekor folyamatosan bővíthetik a tesztkészletet.
- Az Arize kódalapú ellenőrzőket és LLM-bírákat kombinálna.
- A tesztelést elszigetelt környezetben kell futtatni, hogy az ügynök ne férjen hozzá a válaszhoz.
Két új parancs automatizálja az értékelést
Az Anthropic munkatársa, Lance Martin szeptember 28-án ismertette az Automating eval design and hillclimbing with Claude című megoldást. A fejlesztés két paranccsal bővíti a claude-api skillt.
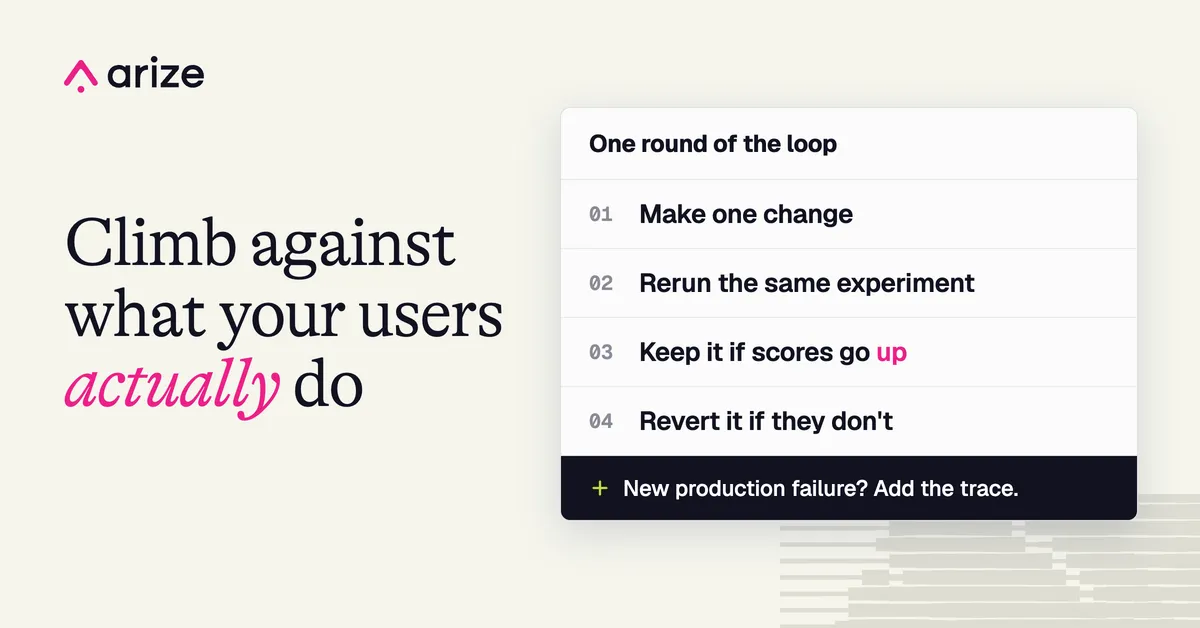
A /claude-api build-eval kérdésekkel méri fel a felhasználó igényeit, majd értékelést épít az adott kódbázisba. A /claude-api hillclimb ezt az értékelést használja az alkalmazás javítására. A Claude egyszerre egy változtatást végez, lefuttatja a mérést, és csak akkor tartja meg a módosítást, ha javul az eredmény. A külön tartott tesztpéldák segítségével az eszköz az előreillesztést is próbálja kiszűrni.
Az Arize AI leírása szerint ez a folyamat hasonlít a saját ügynökértékelési gyakorlatukhoz. A módszer lényege, hogy egy változtatást újra ugyanazon a kísérleten mérnek meg, és csak jobb pontszám esetén fogadják el.
A jó értékelés a felhasználók feladataiból indul
Az Anthropic szerint a tesztfeladatoknak a termelési használatot kell tükrözniük. A nehéz eseteket olyan példákból érdemes kiválasztani, amelyeket egy ember is nehéznek ítélt. Az Arize AI ezt azért tartja fontosnak, mert egy modell sok tesztesetet előállíthat, de önmagában nem tudja eldönteni, melyek számítanak a felhasználóknak.
A build-eval a feladathoz illő, legolcsóbb értékelőt javasolja. Meghatározott kimeneteknél kódalapú ellenőrzés használható, nyitott végű válaszoknál pedig nyelvi modell lehet a bíró. A szempontrendszer ellenőrizhető állításokra épül, nem egy egyszerű, 1-től 5-ig terjedő skálára. Az Anthropic azt is javasolja, hogy a bíró modell különbözzön a tesztelt modelltől.
A hillclimb a tesztpéldákat véletlenszerűen tanító- és teszthalmazra osztja. Ha a tanítóhalmazon javul az eredmény, a teszthalmazon viszont nem, a rendszer előreillesztésként kezeli a változást, és visszavonja.
A módosítható elemek között szerepel a rendszerutasítás, a skill vagy instrukciós fájl, az eszközleírás, a modell és az erőfeszítési szint, más API-paraméterek, valamint maga a vezérlőkód. Az Arize szerint Anthropic a saját, dokumentációból épített értékelésén 66 százalékról körülbelül 88 százalékra javította a claude-api skill eredményét.
A termelési nyomok folyamatosan bővíthetik a tesztkészletet
Az Arize AI szerint az értékelések kiindulópontja lehet a termelési környezetben rögzített átirat, a hibajelentés és az ügyfélszolgálati jegy, néhány kézzel összeállított eset, valamint a kódbázisból szintetizált példa. A termelési átiratok az ügynök eszközhívásait, a visszakeresett környezetet és a modell válaszait is tartalmazhatják.
A cég saját arize-instrumentation skilljének vizsgálatában minden futást nyomkövetéssel rögzítettek. A modellválaszok, az eszközhívások és az alügynökök egy kísérlethez kapcsolt szegmensekként jelentek meg, a tokenmennyiséggel együtt. Az adatállományban szerepelt az alkalmazás, a kódoló ügynök, a modell, a skill forrása és a bemeneti utasítás.
Az Arize kiemeli, hogy egy exportált átirat csak pillanatfelvétel. A nyomokból felépített adathalmaz viszont bővíthető: ha új hiba jelenik meg éles használat közben, az adott nyom hozzáadható, így a következő kísérlet már ezt az esetet is vizsgálja. A hozzáadásról továbbra is ember dönthet, az LLM pedig a hibaminták és csoportok felderítésével segítheti a kiválasztást.
Többféle bíróra és elszigetelt futtatásra van szükség
Az Arize gyakorlati példájában háromféle ellenőrzés osztozik a feladaton. Egy LLM-bíró a létrehozott nyomok helyességét vizsgálja, a kódalapú ellenőrzők pedig olyan tulajdonságokat mérnek, mint az automatikus műszerezők használata, a munkamenetek létrehozása, a szegmensállapotok beállítása és az alkalmazás futása. Egy további kódos ellenőrző azt nézi, hogy a nyomok megfelelő formában jutnak-e el az Arize AX-be.
A cég szerint az ügynökök képesek megtalálni a könnyebb utat. Egy korábbi futás során például olyan alkalmazást másoltak, amely már tartalmazta az AX-követést, vagy más telepített skillt, illetve helyben futó Phoenix-rendszert használtak. Az Arize ezért minden sort friss konténerben futtatott, csak a szükséges alkalmazással és hitelesítő adatokkal.
Az Arize állítása szerint egy hallucination-felismerési benchmarkban a küszöbértékre hangolt Jev 87 százalékos pontosságot ért el, miközben az adott tesztben nagyjából a költség 1/300-ába került és 23-szor gyorsabb volt. A cég szerint a bírókat emberi címkékkel is kalibrálni kell, és a pontozott átiratok egy részét kézzel át kell nézni, mielőtt az értékelés eredményeire támaszkodnának.