A LangChain szerint a jobb ügynökhöz elég volt a körítésen javítani
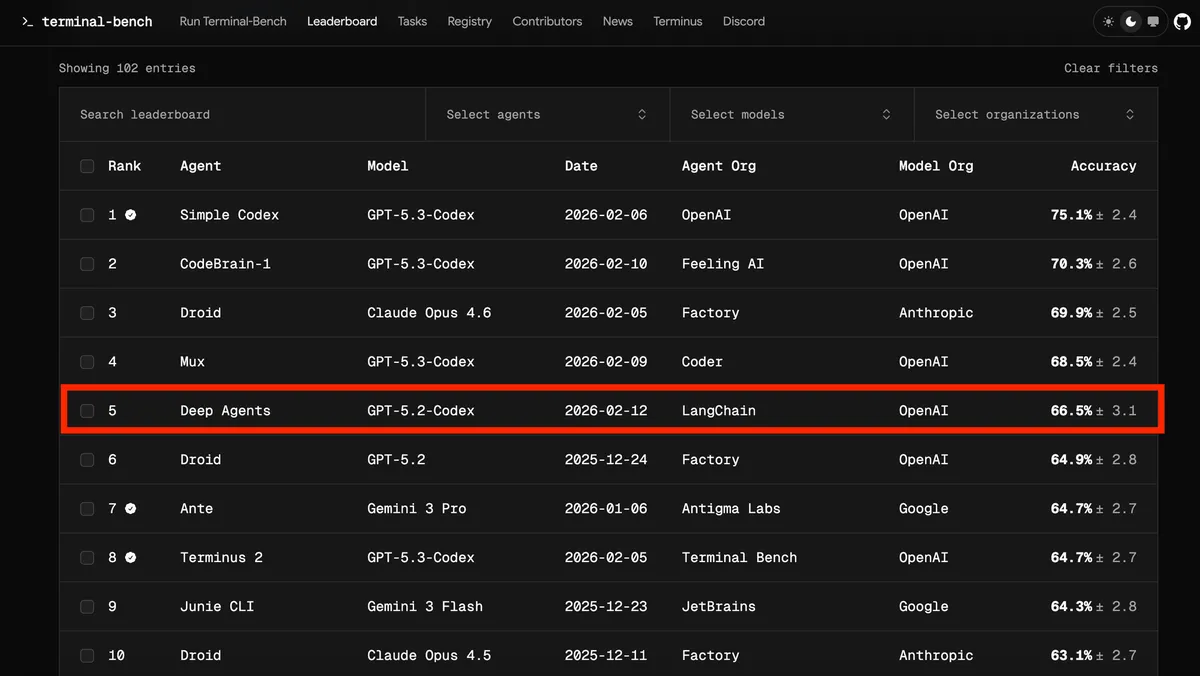
A LangChain kódoló ügynöke 52,8 százalékról 66,5 százalékra javult a Terminal Bench 2.0 benchmarkon, miközben a mögötte használt GPT-5.2-Codex modell változatlan maradt. A vállalat szerint a fejlődést az ügynök köré épített eszközök, utasítások és ellenőrzési folyamatok hozták.
- A deepagents-cli eredménye 52,8 százalékról 66,5 százalékra nőtt.
- A kísérletben végig GPT-5.2-Codex modellt használtak.
- A fejlesztésekhez nyomelemzést, önellenőrzést és köztes rétegeket alkalmaztak.
- A Terminal Bench 2.0 összesen 89 kódolási feladatot tartalmaz.
- A gondolkodási erőforrások elosztása az időtúllépések miatt is számított.
A modell maradt, a működési környezet változott
A LangChain február 17-én ismertetett kísérletében a deepagents-cli nevű kódoló ügynök teljesítményét javította. A vállalat 13,7 százalékpontos növekedést mért a Terminal Bench 2.0 teszten, 52,8 százalékról 66,5 százalékra. A kísérletben végig a GPT-5.2-Codex modellt használták, így a változásokat kizárólag az úgynevezett harness, vagyis a modell köré épített működési rendszer módosításának tulajdonítják.
A Terminal Bench 2.0 olyan benchmark, amely ügynöki kódolási képességeket vizsgál. A teszt 89 feladatot tartalmaz többek között gépi tanulási, hibakeresési és biológiai témákban. A futtatásokat a Harbor hangolja össze, a feladatokhoz pedig Daytona sandboxokat indít. Az ügynök minden műveletét a LangSmith tárolja, a rendszer emellett késleltetést, tokenszámot és költséget is mér.
A nyomkövetésből konkrét fejlesztések születtek
A LangChain a futások nyomainak elemzésével kereste a hibák okait. Az elemzést Agent Skillként ismételhetővé tették: a rendszer lekéri a LangSmithben tárolt nyomokat, párhuzamosan több hibaanalizáló ügynököt indít, majd egy fő ügynök összesíti a megállapításokat és javaslatokat. Ezek alapján célzottan módosítják a rendszert.
Az elemzés olyan problémákat tárt fel, mint a hibás érvelés, a feladatutasítások figyelmen kívül hagyása, a tesztelés és ellenőrzés kihagyása, illetve az időkeret túllépése. A vállalat szerint az automatizált nyomelemzés gyorsabbá tette a kísérletezést, és órákat takarított meg. A módszerhez emberi ellenőrzés is kapcsolódhat, főként annak kiszűrésére, ha egy módosítás túlságosan egyetlen feladatra illeszkedik, és más feladatokon visszaesést okoz.
A rendszerutasításokat úgy alakították át, hogy az ügynök először olvassa el a feladatot, térképezze fel a kódbázist, majd készítsen tervet. Ezután meg kell valósítania a tervet, teszteket kell írnia, ha azok hiányoznak, és a sikeres, valamint a szélső eseteket is ellenőriznie kell. A tesztek futtatása után a teljes kimenetet össze kell vetnie a feladatspecifikációval, majd javítania kell a feltárt hibákat.
Ellenőrzés, környezeti kontextus és erőforrás-kezelés
A LangChain egy PreCompletionChecklistMiddleware nevű köztes réteget is bevezetett. Ez az ügynök kilépése előtt emlékezteti a rendszert, hogy a feladatspecifikáció alapján még végezzen ellenőrzést. Egy másik köztes réteg a munkakönyvtárat és a kapcsolódó könyvtárakat térképezi fel, valamint megkeresi a rendelkezésre álló eszközöket, például a Python-telepítéseket.
Az ügynök környezeti korlátairól is több információt kap. A rendszer hangsúlyozza, hogy a megadott fájlútvonalakat pontosan kell követni, a megoldásokat programozott tesztekkel mérik, és a szélső eseteket is kezelni kell. Időkerethez kötött feladatoknál figyelmeztetéseket kap, amelyek a munka lezárására és az ellenőrzés megkezdésére ösztönzik.
A LoopDetectionMiddleware a fájlonkénti szerkesztések számát követi. Ha az ügynök túl sokszor módosítja ugyanazt a fájlt, arra kaphat felszólítást, hogy gondolja újra a megközelítését. A LangChain ezt a jelenlegi modellek problémáira adott tervezési heurisztikának tekinti, amelyre a fejlettebb modellek mellett később kevésbé lehet szükség.
A vállalat a gondolkodási erőforrások elosztását is vizsgálta. A GPT-5.2-Codex négy módot kínál: low, medium, high és xhigh. Az xhigh használata minden feladaton 53,9 százalékos eredményt hozott, részben az időtúllépések miatt, míg a high 63,6 százalékot ért el. A tervezéshez és az ellenőrzéshez több számítási kapacitást rendelő, xhigh-high-xhigh felosztással végül 66,5 százalékos eredményt mértek.
LangChain: Improving Deep Agents with harness engineering