Memóriakorlátot kap a megosztott GPU a CUDA 13.4-ben
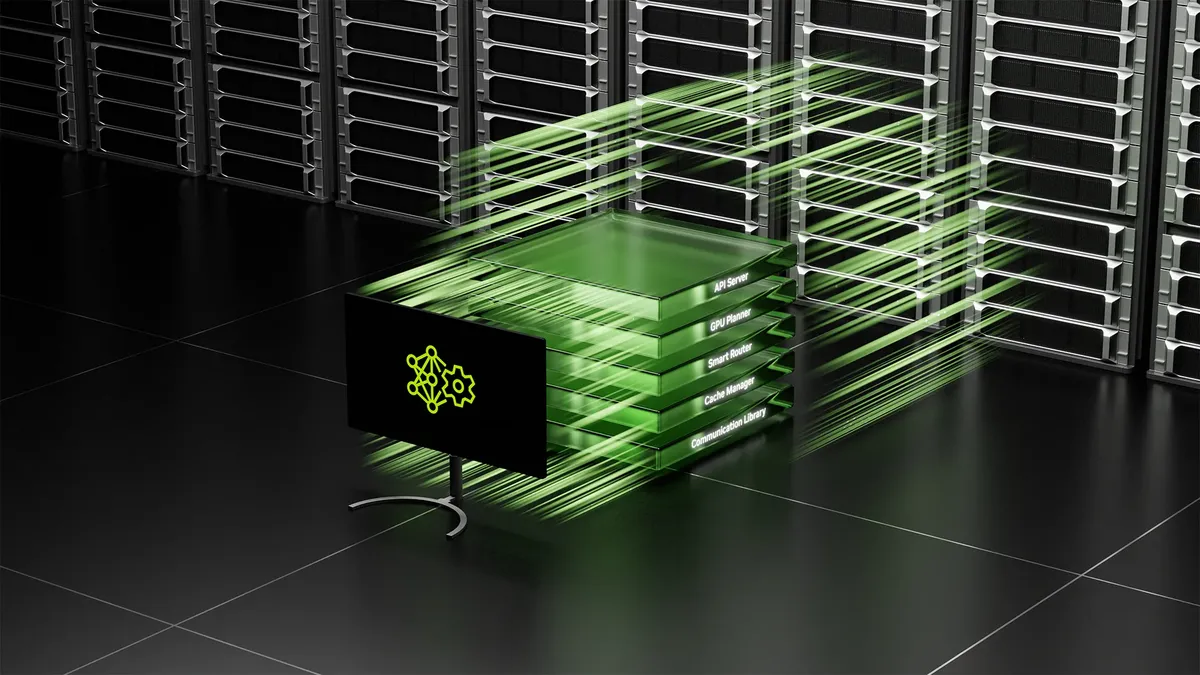
Az NVIDIA CUDA 13.4 memóriakorlátot biztosít a Kubernetesben megosztott GPU-khoz. Az új, nyílt forráskódú GPU Fractioning Operator és a KAI Scheduler együtt workloadszerűen szabályozza a memória- és számítási erőforrásokat.
- A CUDA 13.4 memóriakeretet vezet be a megosztott GPU-khoz.
- A GPU Fractioning Operator node-onként alkalmazza a korlátokat.
- A munkaterhelések pontos vagy burstölhető memóriaértéket kérhetnek.
- A KAI Scheduler v0.18.0 NvFractions módja támogatja a rendszert.
- A számítás time-slicing vagy sm-sharing módban osztható meg.
Memóriakeret és kétféle számításmegosztás
Az NVIDIA fejlesztői blogján 2026. október 27-én bemutatott megoldás olyan AI-munkaterheléseket céloz, amelyeknek csak a GPU egy részére van szükségük. Ilyenkor egy teljes GPU hozzárendelése kihasználatlan kapacitást hagyhat, a megosztás pedig több munkaterhelés kiszolgálását teszi lehetővé ugyanazon az infrastruktúrán.
A CUDA 13.4 olyan memóriakeretet vezet be, amely az alkalmazások számára átlátható. A munkaterhelés pontos memóriaértéket kérhet, amely fölé az allokáció nem mehet. Emellett megadható egy garantált minimum és egy olyan maximum is, amelyig a folyamat akkor terjeszkedhet, ha van szabad memória. Ha a maximumot nem adják meg, az megegyezik a kéréssel.
A számításmegosztás két módban működhet. Az alapértelmezett time-slicing esetén a munkaterhelések felváltva használják a teljes GPU-t. Az sm-sharing párhuzamos működést biztosít, ilyenkor a GPU streaming multiprocesszorai oszlanak meg a feladatok között. Ha minden munkaterhelés aktív, mindegyik nagyjából a számítási kapacitás egyenlő részét kapja, ha valamelyik leáll, a felszabaduló kapacitást a többiek használhatják.
A GPU Fractioning Operator végzi a node-oldali szabályozást
A CUDA önmagában biztosítja a memóriakorlátozás képességét, a Kubernetesnek azonban szüksége van egy node-on futó komponensre, amely beállítja és felügyeli a szükséges szolgáltatásokat. Ezt a szerepet az NVIDIA GPU Operator mellett működő, nyílt forráskódú GPU Fractioning Operator tölti be. A projekt a KAI Scheduler GitHub-szervezetében található.
Az operator minden GPU-csomóponton beállítja és futtatja az NVIDIA Multi-Process Service-t, alkalmazza az egyes konténerek memória- és számítási módját, valamint a teljes GPU helyett frakciónként méri a használatot. A scheduler kiválasztja a munkaterheléshez szükséges GPU-kat, majd konténerenkénti Pod-annotációkban rögzíti a memóriaigényt, a korlátot, a számítási módot és a hozzárendelt eszközöket.
A megoldás nem kizárólag a KAI Schedulerrel használható. Bármely Kubernetes-scheduler érvényesítheti a GPU-frakciókat, ha képes ezeket az annotációkat létrehozni. A scheduler feladata marad annak kiválasztása, hogy melyik GPU-n van elegendő szabad memória, továbbá nem helyezhet eltérő számítási módot használó munkaterheléseket ugyanarra a GPU-ra.
A KAI Scheduler v0.18.0-val kapcsolódik a rendszerhez
A KAI Scheduler v0.18.0 verziója az NvFractions nevű GPU-megosztási módot vezeti be. A scheduler kiválasztja, hogy az egyes munkaterhelések melyik GPU melyik részét kapják, és létrehozza az operator által értelmezett annotációkat. Az NvFractions a KAI telepítésekor Helm-beállítással engedélyezhető, a GPU Fractioning Operator pedig függőségként települ.
A felhasználók abszolút memóriaértéket vagy a GPU egy részét megadó gpu-fraction értéket állíthatnak be. Opcionálisan burstkorlát is kérhető, a számítási mód pedig konténerenként lehet time-slicing vagy sm-sharing. Ha több GPU-ra van szükség, a gpu-fraction-num-devices annotációval adható meg az eszközök száma. A memóriaigény ilyenkor minden hozzárendelt GPU-ra külön érvényes.
A felhasználók számára ez kiszámíthatóbb GPU-megosztást jelenthet Kubernetes-környezetben: a munkaterhelések garantált memóriaigényt és választható maximális keretet kaphatnak, miközben a számítási kapacitás időben vagy párhuzamosan osztható meg. A megoldás részletes telepítési és konfigurációs útmutatója a GPU Fractioning Operator, valamint a KAI Scheduler dokumentációjában érhető el.
NVIDIA Developer: Memory-Enforced GPU Sharing in Kubernetes with NVIDIA CUDA 13.4