NVIDIA CUDA Rust: két út Rustban írt GPU-kernelekhez
Az NVIDIA 2026. szeptember 8-án bejelentette, hogy erősebben épít a natív Rust-alapú GPU-programozásra. A CUDA Rust két fejlesztési irányt kínál: a SIMT-modellt követő cuda-oxide-ot és a Tile-alapú cutile-rs-t.
- Az NVIDIA 2026. szeptember 8-án jelentette be a CUDA Rust irányát.
- A cuda-oxide SIMT-stílusú Rust GPU-kerneleket fordít PTX-re.
- A cutile-rs Tile-alapú GPU-programozást kínál stabil Rust 1.89+ mellett.
- Mindkét projekt fordítási időben érvényesített memória-biztonsági megoldásokat használ.
- Az NVIDIA interoperabilitást tervez CUDA Rust, CUDA C++ és CUDA Python között.
Rust a GPU-kernel szintjén
Az NVIDIA fejlesztői blogja szerint a CUDA C++ és a CUDA Python már érett, vállalati szintű eszköztárak, a vállalat pedig 2027-ben és azt követően is bővíteni és érlelni tervezi a CUDA Rustot. A cél az, hogy a fejlesztők ne csak Rustból indíthassanak GPU-kerneleket, hanem magukat a kerneleket is Rustban írhassák meg, natívan PTX-re fordítva.
A bejegyzés ezt azzal indokolja, hogy az AI rendszerszintű rétege, például az inference engine-ek, a kiszolgáló infrastruktúra, a driverek és az agent runtime-ok gyorsan változnak, és egyre több ilyen komponens készül Rustban. Az NVIDIA példaként említi, hogy a Nova Linux driver Rustban íródik, az NVIDIA Dynamo Rust-magra épül, az NVTX-hez pedig vannak Rust-kötések.
cuda-oxide: SIMT Rustban
A két út közül a cuda-oxide a hagyományos SIMT-modellhez kapcsolódik, amelyet a CUDA C++ vagy a numba-cuda használói már ismerhetnek. Ebben a modellben a fejlesztő azt írja le, mit csináljon egy szál, majd ezrek indulnak el belőle.
A cuda-oxide egy egyedi rustc codegen backend. A forrás szerint a #[kernel] függvényeket Rust MIR-en, a közösségi Pliron IR keretrendszeren és LLVM IR-en keresztül PTX-re fordítja, miközben a többi kódot a standard backend kezeli. A használatához Linux, compute capability 8.0 vagy újabb GPU, CUDA toolkit 12.x vagy újabb verzió, clang a libclang headerekkel, valamint rögzített nightly toolchain szükséges.
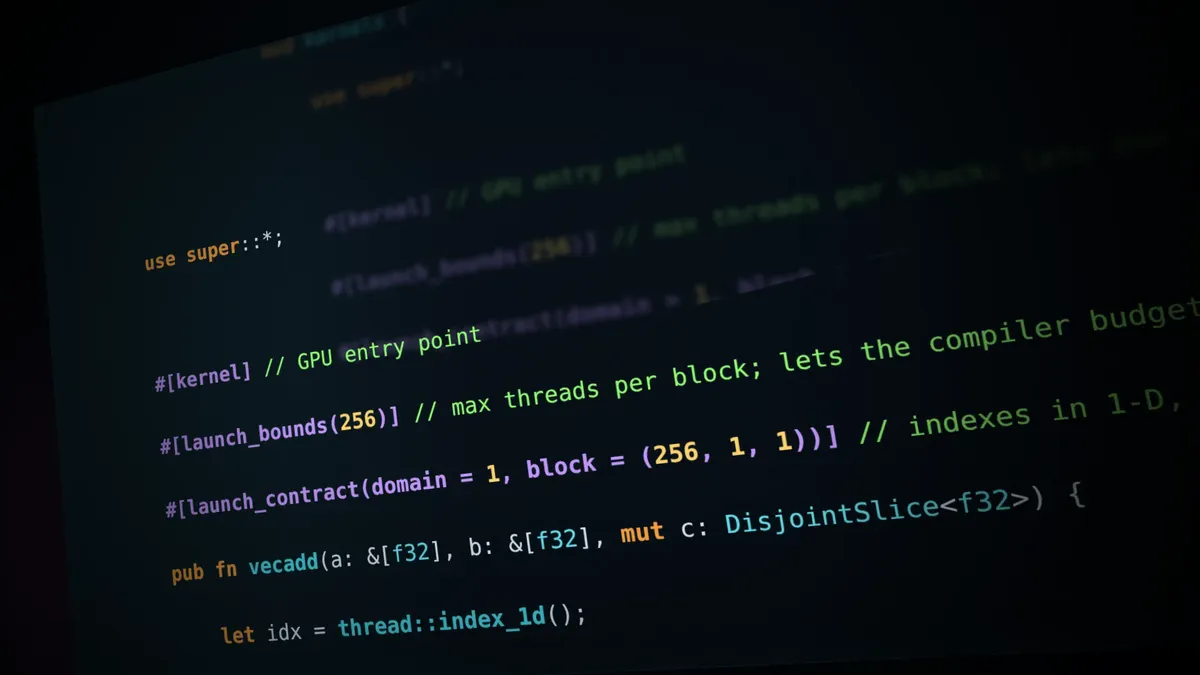
Az NVIDIA példája egy 1 024 elemes lebegőpontos vektorösszeadást mutat. A cuda-oxide esetében a host- és device-kód egy fájlban él, egy paranccsal építhető, és nincs szükség külön kernel crate-re. Az első cargo oxide run a codegen backendet is lefordítja, ezért a forrás szerint hosszabb ideig tarthat, későbbi futásoknál a cache újrahasznosul.
A memóriahelyességhez a cuda-oxide a DisjointSlice típust és launch contractokat használ. A DisjointSlice minden szálnak kizárólagos hozzáférést ad a saját eleméhez, a thread::index_1d() pedig nem puszta egész számot, hanem index típust ad vissza. A launch_contract deklarálja, hogy a kernel egydimenziós indexeléssel és 256 szálas blokkokkal dolgozik, a prepare_vecadd pedig ellenőrzi a LaunchConfig1D-t a deklaráció és az aktuális eszközkorlátok alapján.
cutile-rs: magasabb szintű Tile-modell
A másik irány a cutile-rs, amely a forrás szerint egy szinttel magasabban dolgozik. Itt a fejlesztő csempéken, vagyis adatrészleteken végez műveleteket, és a fordító dönti el, hány valós GPU-szál hajtja végre az adott logikai munkát.
Az NVIDIA leírása alapján a Tile-modell C++ és Python felületen is elérhető, a Rust-változat pedig stabil Rust 1.89+ környezetben fut CUDA 13.3-mal, egyedi LLVM nélkül. A cutile-rs a CUDA Tile IR JIT-fordítására épít, és a fordító kezeli a szálak leképezését, valamint a memóriakiosztást.
A forrás szerint a cutile-rs a tensorok particionálásával és a tulajdonlási szabályokkal garantál kizárólagos hozzáférést. A projekt crates.io-n is megjelent, és már használják a HuggingFace Grout inference engine-jében, valamint a mistral.rs-ben. A cuda-oxide ezzel szemben korai alpha állapotban van.
Mit jelent ez a fejlesztőknek
Az NVIDIA azt javasolja, hogy aki választani készül, először a Tile-modellt próbálja meg. Ennek oka a forrás szerint az, hogy a fordító dönti el, a tile-ok hogyan képeződnek le az egyes architektúrákra, így a forráskód nem rögzít architektúraspecifikus döntéseket. A SIMT akkor lehet célszerű, ha a fejlesztőnek részletes kontrollra van szüksége, vagy maga akarja kezelni a memóriát és a szálakat.
A vállalat azt is közölte, hogy inter-language interoperabilitást tervez a CUDA Rust, a CUDA C++ és a CUDA Python között. Ez azt jelenti, hogy a választott frontend a tervek szerint nem zárná ki a fejlesztőket a többi ökoszisztémából.
NVIDIA Developer: Introducing CUDA Rust: Two Tracks for Writing GPU Kernels