NVIDIA Groq 3 LPX: 3431 token/másodperc 100K kontextus mellett
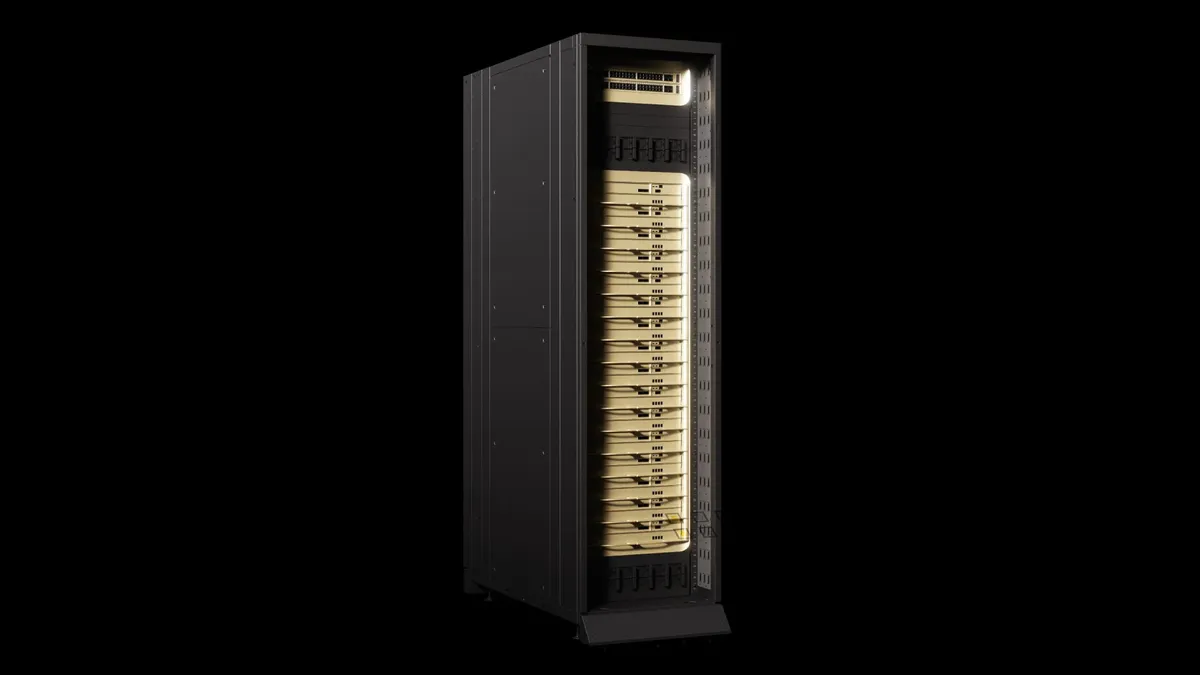
Az NVIDIA 2026. augusztus 24-én ismertette a Groq 3 LPX inference gyorsítót, amelyet a Vera Rubin platform interaktív AI-kiszolgálásához szán. A cég szerint az Artificial Analysis 100K kontextusos tesztjében a Gemma 4 31B modellen 3431 kimeneti token/másodperc medián sebességet mértek.
- Az NVIDIA 2026. augusztus 24-én mutatta be a Groq 3 LPX szerepét a Vera Rubin platformon.
- Az Artificial Analysis 3431 kimeneti token/másodperc medián sebességet mért Gemma 4 31B modellen, 100K kontextus mellett.
- A Groq 3 LPX determinisztikus végrehajtási modellt és fordító által ütemezett C2C kommunikációt használ.
- A rendszer 256 LP30 LPU-t, összesen 128 GB SRAM-alapú memóriát és chipenként 96 darab 112 Gbps C2C kapcsolatot említ.
- A SPEED-Bench kódolási benchmarkon a közölt medián érték 4767 kimeneti token/másodperc volt Gemma 4 modellel.
Harmadik fél mérte a Groq 3 LPX teljesítményét
Az NVIDIA Developer blogján megjelent bejegyzés szerint a Groq 3 LPX az NVIDIA Vera Rubin platform interaktív AI-inference gyorsítója. A platform központi elemeként a vállalat a Vera Rubin NVL72-t nevezi meg, amelyet a cég állítása szerint a legszélesebb AI-terhelési körre, kis és nagy modellekre, nyílt és zárt modellekre terveztek nagy áteresztőképesség és interaktivitás mellett.
A közleményben az NVIDIA az első külső teljesítménytesztként hivatkozik az Artificial Analysis mérésére. A tesztben a Gemma 4 31B modellt futtatták Groq 3 LPX rendszeren, 100K kontextus mellett. A mért medián sebesség 3431 kimeneti token/másodperc volt.
Az NVIDIA szerint a Groq 3 LPX és a Vera Rubin NVL72 együtt olyan többügynökös rendszerek kiszolgálását célozza, amelyek 2T+ paraméteres modellekre, hosszú kontextusra és magas interaktivitásra épülnek. A vállalat példaként olyan konfigurációkat említ, mint a prefill és decode szétválasztása, az attention és FFN szétválasztása, valamint a külső drafterrel végzett spekulatív dekódolás.
Miért nehéz a gyors válasz hosszú kontextussal
Az NVIDIA magyarázata szerint az ügynökös AI-munkamenetek több fordulóból állnak. Minden forduló végén az ügynök kimenete hozzáadódik a következő fordulók bemeneteként használt, folyamatosan növekvő kontextushoz. A cég szerint ez teljes ügynökös munkamenetekben több százezer tokenig nőhet, különösen akkor, ha a folyamat több száz fordulón túl tart.
A hosszú kontextus azért fontos a bejegyzés szerint, mert a feladat későbbi szakaszaiban az ügynöknek újra és újra fel kell dolgoznia mindazt, amit addig megtanult. Ha a kontextus korlátozott, az ügynök csak az előzmények egy részét veheti figyelembe.
A nagy sebességű kiszolgálás technikai kihívását az NVIDIA úgy írja le, hogy felhasználónként több mint 3000 token/másodperces kiszolgálás és 100K bemeneti tokenhez tartozó KV cache kezelése külön rendszertervezési problémát jelent. A tenzorpárhuzamosság nagy gyorsulást adhat, de magas interaktivitásnál nagyon kicsi kötegméretekre van szükség, ahol a koordináció fix költsége könnyen felemésztheti a párhuzamosítás nyereségét.
Fordító által ütemezett kommunikáció a chipek között
A Groq 3 LPX egyik kulcseleme az NVIDIA szerint a determinisztikus végrehajtási modell. Ebben a fordító előre látja az egyes számítási egységeket a 256 LP30 local processing unit, vagyis LPU mindegyikében, a chipekben összesen rendelkezésre álló 128 GB SRAM-alapú memóriát, valamint a chipenkénti 96 C2C kapcsolatot, amelyek egyenként 112 Gbps sebességgel működnek.
A bejegyzés szerint ez lehetővé teszi, hogy a rendszer a munka elindítása előtt, órajelig lebontva készítsen ütemtervet arról, hogyan fusson a terhelés. Az NVIDIA szerint ez különösen a magas interaktivitásnál fontos, mert csökkenti a valós idejű adatátviteli döntések szükségességét: a fordító előre megtervezheti, mikor melyik adat melyik C2C kapcsolaton mozogjon.
A cég leírása alapján az LPU-k akkor küldhetik az adatot, amikor az elkészül, és akkor fogyaszthatják el, amikor megérkezik. A kapcsolatok pont-pont jellegűek az LPU-párok között, az egyes LPU-k pedig útválasztóként és processzorként is működhetnek, így az adat szükség esetén más LPU-kon keresztül is eljuthat a célhoz.
A másik fontos elem a számítás és a kommunikáció finom szemcsézettségű átfedése. Az NVIDIA szerint az LPX fordítója 320 bájtos vektorok szintjén ütemezi a számítási és kommunikációs egységeken futó munkát. A mátrixszorzások pontszorzatok sorozataként kezelhetők, ezért a fordító az egyes LPU-kra 320 oszlopnyi kimeneti mátrix kiszámítását ütemezheti, majd ezek az oszlopok azonnal továbbíthatók a C2C kapcsolatokon.
Mit jelent ez a felhasználóknak és a piacnak
A bejegyzés üzenete az, hogy a hosszú kontextus és a gyors, interaktív válasz együtt válik kulcskérdéssé az ügynökös AI-rendszereknél. Ha egy munkamenet során a kontextus folyamatosan nő, a felhasználói élményt nem csak a modell képességei, hanem a teljes kiszolgálórendszer késleltetése és kommunikációs hatékonysága is meghatározza.
Az NVIDIA saját adatai szerint a SPEED-Bench kódolási benchmarkon, Gemma 4 modellel a rendszer 4767 kimeneti token/másodperc medián sebességet és 5520 token/másodperces P80 értéket ért el. A vállalat ezt annak példájaként mutatja be, hogy a Groq 3 LPX a Vera Rubin NVL72-vel együtt a magas interaktivitású kiszolgálási szinteket célozza.
A felhasználók szempontjából a forrás alapján a fő ígéret az, hogy a hosszabb, több fordulós AI-folyamatokban is gyorsabb reakcióidő maradhat elérhető. A szolgáltatók és AI-gyárak számára a hangsúly azon van, hogy a Vera Rubin platform Groq 3 LPX-szel bővítve a hosszú kontextusú, kis kötegméretű inference terhelésekhez kínál külön gyorsítást.
NVIDIA Developer: How NVIDIA Groq 3 LPX Unlocks Ultrafast Interactivity at Long Context on NVIDIA Vera Rubin