Az NVIDIA teljes gyártásba vitte a Groq 3 LPX rendszert
Az NVIDIA 2026. augusztus 24-én jelentette be, hogy teljes gyártásban van a Vera Rubin rack-szintű rendszerhez kapcsolódó NVIDIA Groq 3 LPX. A vállalat a Hot Chips konferencián mutatja be, hogyan építené egybe a számítást, a hálózatot és a következtetésgyorsítást az AI factory infrastruktúrákban.
- Az NVIDIA szerint teljes gyártásban van a Groq 3 LPX.
- A rendszer egy Artificial Analysis benchmarkban 3 400 kimeneti tokent ért el másodpercenként Gemma 4 31B modellen.
- A Nebius az első AI cloud, amely adoptálja az NVIDIA Groq 3 LPX-et.
- A CoreWeave éles üzemben telepítette a Spectrum-X Multiplane-t.
- A SpaceXAI NVIDIA Vera CPU-kra építené következő generációs agentic AI rendszerét.
A Vera Rubin mellé érkezik a gyors token-generálás
Az NVIDIA közlése szerint az AI-következtetés következő szakaszát nem egyetlen chip, hálózat vagy rendszer határozza meg, hanem az, hogyan működnek együtt az AI factory minden rétegében az összetevők. Ennek részeként a vállalat a Vera Rubin NVL72 platformot egészíti ki a Groq 3 LPX rendszerrel, amelyet agentic rendszerek gyors token-generálására szán.
A bejelentés szerint az NVIDIA Groq 3 LPX teljes gyártásban van. Egy Artificial Analysis benchmarkban, amely a nyílt forrású, agentic felhasználásra szánt Gemma 4 31B modellt futtatta, a rendszer 3 400 kimeneti tokent ért el másodpercenként 100 000 tokenes hosszú kontextusú használati esetekben. Az NVIDIA szerint ez négyszer gyorsabb volt, mint a legközelebbi alternatív platform.
A vállalat azzal indokolja a fejlesztést, hogy az AI egyre inkább a tanításról a következtetés, az érvelés és az agentic működés felé tolódik. Az ilyen rendszerek több tokent generálnak, jóval nagyobb kontextusablakokat dolgoznak fel, és egyre gyakrabban működnek együtt más AI-rendszerekkel összetett feladatok megoldásán.
Az NVIDIA a teljes rendszert tervezi össze
A cég a Palo Altóban tartott Hot Chips konferencián azt emeli ki, amit extreme codesign néven ír le. Ez az NVIDIA értelmezésében azt jelenti, hogy a számítási elemeket, a hálózatot és a következtetésgyorsítást egységes rendszerként tervezik meg.
A Vera Rubin a hosszabb sorozatokon dolgozó agentek következtetésének gyorsítására készült, a Spectrum-X Ethernet a nagy adatáramlások hatékony mozgatását célozza az AI factory környezetekben, a Groq 3 LPX pedig az ultragyors token-generálásra épül. Az NVIDIA szerint ezek együtt a kontextusfeldolgozástól a kommunikáción át a generálásig optimalizálják az AI-folyamat különböző szakaszait.
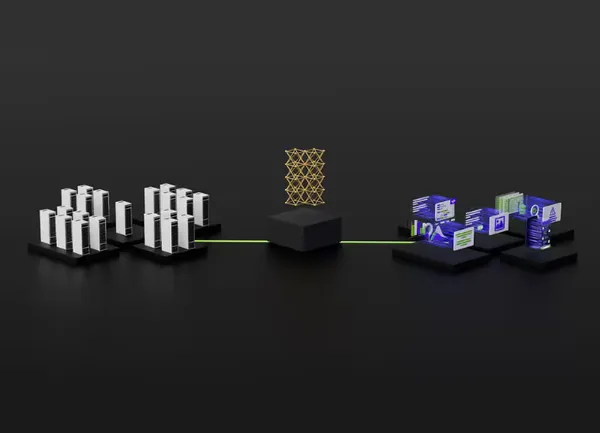
A Groq 3 LPX-t a Vera Rubin NVL72 mellé tervezték alacsony késleltetésű következtetési architektúraként. Az NVIDIA közlése szerint a Rubin GPU-k a nagy léptékű kontextusfeldolgozást végzik, míg az LPX a késleltetésérzékeny dekódolási feladatokat gyorsítja. A vállalat szerint ez kiszámíthatóbb token-generálást, reagálóképesebb agent-interakciókat és hatékonyabb infrastruktúra-használatot eredményezhet.
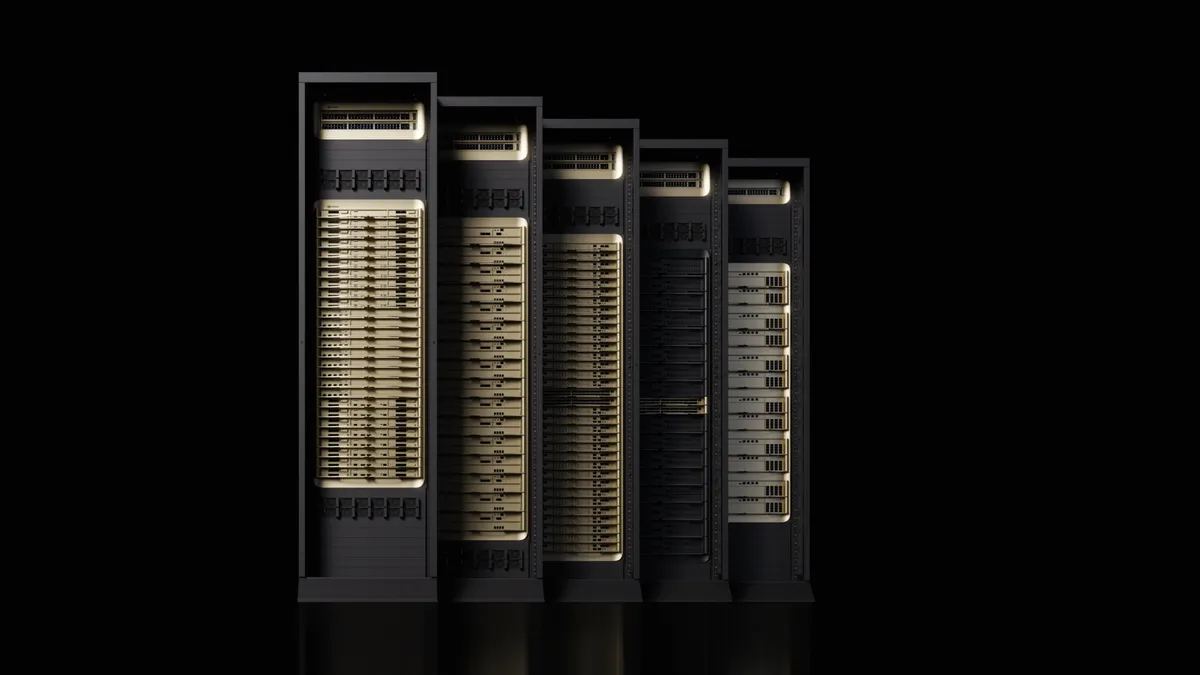
A forrás szerint egy rack-szintű NVIDIA Groq 3 LPX telepítés 256 LP30 gyorsítót tartalmazhat, amelyeket közvetlen chip-chip kapcsolatok kötnek össze. Az NVIDIA ezt modern AI factory környezetekhez tervezett következtetési motorként írja le.
Nebius, CoreWeave és SpaceXAI is szerepel a bejelentésben
Az NVIDIA szerint világszerte iparági partnerek veszik át a Vera Rubin platform megoldásait. A Nebius az első AI cloud, amely adoptálja az NVIDIA Groq 3 LPX-et. A vállalat közlése szerint a Groq 3 LPX hozzáadása a NVIDIA Vera Rubin NVL72-höz a Nebius Token Factoryben a következtetési teljesítmény növelését célozza, hogy a fejlesztők interaktív agenteket, kódoló rendszereket és más valós idejű AI-élményeket építhessenek nagy léptékben.
A CoreWeave a bejelentés szerint éles üzemben telepítette a Spectrum-X Multiplane-t. Ez több párhuzamos kapcsolón keresztül köti össze az NVIDIA Vera Rubin rackeket, nagy sávszélességű, lapos és veszteségmentes AI-hálózatokat biztosítva.
A SpaceXAI azt jelentette be, hogy az NVIDIA Vera CPU-k fogják hajtani a következő generációs agentic AI rendszerét. A forrás szerint a SpaceXAI a jövőbeli AI-architektúráját az NVIDIA Vera Rubin köré tervezi építeni és skálázni, a földi adatközpontoktól az orbitális műholdakig. A vállalat NVIDIA Vera CPU-k telepítését tervezi olyan, CPU-igényes agentic AI feladatokra, mint az orkestráció, az eszközhasználat, a kódfuttatás, az adatfeldolgozás és a szimuláció.
A hálózat is az AI factory része
Az NVIDIA a Spectrum-X Multiplane-t is kiemelte, amely a hardveresen gyorsított Spectrum-X Ethernet architektúra része. A vállalat szerint az AI factory rendszerek növekedésével a hálózat a teljesítmény egyik kulcselemévé válik.
A Spectrum-X Ethernetet végponttól végpontig AI-ra optimalizált Ethernet platformként írja le a cég. A rendszer NVIDIA Spectrum-X Ethernet switcheket, SuperNIC-eket és szoftvert kombinál, azzal a céllal, hogy javítsa az Ethernet-alapú AI-infrastruktúrák teljesítményét és hatékonyságát AI factory és felhős környezetekben.
Az NVIDIA állítása szerint a platform 1,6-szor jobb AI-hálózati teljesítményt nyújt az általános Ethernethez képest, miközben konzisztens és kiszámítható működést biztosít több-bérlős környezetekben. A Multiplane megközelítés a forrás szerint azt célozza, hogy a klaszterek növelésekor ne kelljen újabb hálózati szintet hozzáadni, ami késleltetést, kiszámíthatatlan lassulást, valamint magasabb kábelezési, optikai és energiaigényt hozna.
Mit jelent ez a felhasználóknak és a piacnak?
Az NVIDIA bejelentése alapján a vállalat az agentic AI terhelések kiszolgálását tekinti a következtetési infrastruktúra egyik fő irányának. Ezeknél a rendszereknél a késleltetés azért válik különösen fontossá, mert az agentek egyesével generálják a válasz tokenjeit, miközben eszközöket használnak, más rendszerekkel kommunikálnak és hosszú munkafolyamatokat hajtanak végre.
A Groq 3 LPX, a Vera Rubin NVL72 és a Spectrum-X Multiplane együtt olyan infrastruktúrát céloz, amely nagy kontextusablakok mellett is gyors és kiszámítható következtetést ad. A fejlesztők és szolgáltatók számára ez a forrás szerint interaktívabb agentic alkalmazások, kódoló rendszerek és valós idejű AI-élmények építését támogathatja.
A bejelentés piaci üzenete az, hogy az AI-szolgáltatások versenye egyre inkább a tokenek gyors, nagy léptékű és gazdaságos kiszolgálásáról szól. Az NVIDIA ezt token factory szemléletként írja le, ahol a teljesítmény, az áteresztőképesség, az intelligencia integritása és a gazdasági hatékonyság egyszerre számít.