NVIDIA NeMo Switchyard: modellválasztó réteg AI-ügynökökhöz
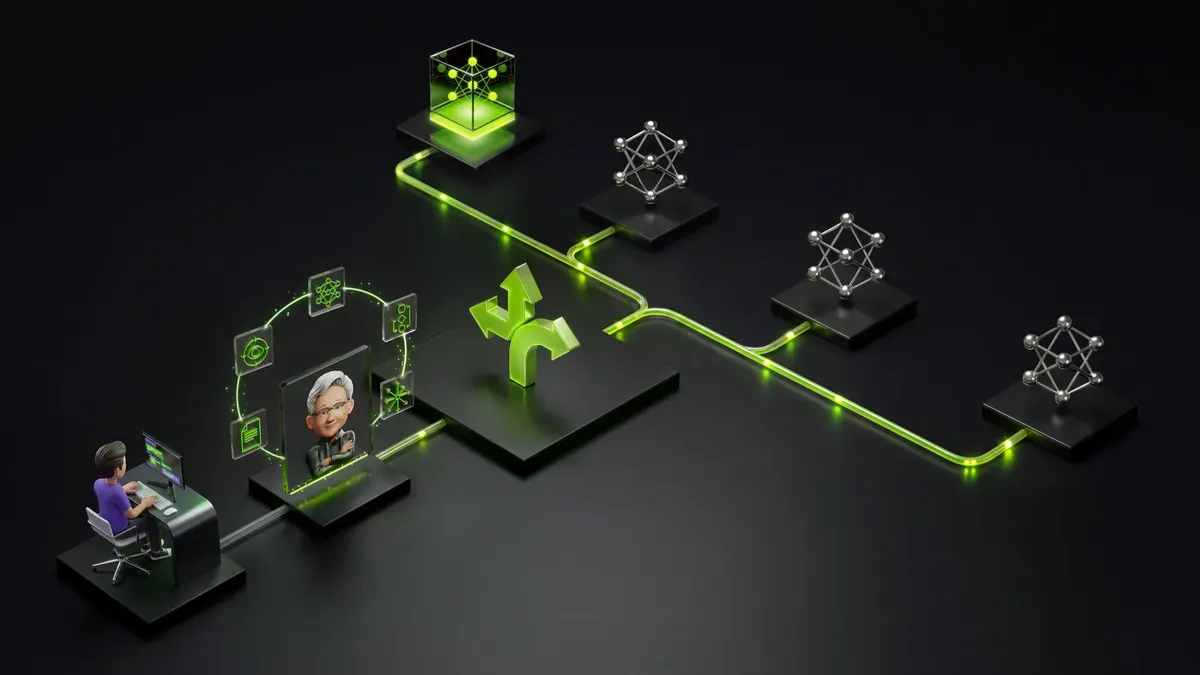
Az NVIDIA Developer 2026. augusztus 11-én ismertette a NeMo Switchyard működését, amely AI-ügynökök feladatait irányítja különböző specializált és frontier modellek között. A cél, hogy a fejlesztők egyetlen modell helyett feladatonként választhassanak megfelelő modellt.
- A NeMo Switchyard AI-ügynökök feladatait irányítja több modell között.
- A NeMo switchyard-libsy szolgáltatófüggetlen SDK-ként választja el a routinglogikát a modellvégpontoktól.
- A rendszer hangolás nélküli és hangolható útvonalválasztókat is támogat.
- A LangChain benchmarkja 74% költségcsökkenést jelzett az escalation routerrel.
- A partneri integrációk között szerepel a LangChain, Kong, Boomi, Cognition, Ramp, Cadence és Siemens.
Miért kell több modell között útvonalat választani?
Az NVIDIA szerint egy AI-ügynök építése nem ér véget egyetlen modell kiválasztásával. Egy ügynöki feladat egyik lépése lehet osztályozás, a következő következtetés, majd jöhetnek rutinszerű követő műveletek, amelyekhez kisebb modell is elegendő lehet.
A vállalat példája szerint ha minden kérést a legnagyobb modell kap, az növelheti a költséget és a késleltetést. Ha viszont minden kérést kisebb modellre küldenek, a bonyolultabb feladatok minősége romolhat. A modellútvonal-választás erre ad megoldást: a rendszer a specializált és frontier modellek között osztja szét a munkát, az adott feladathoz illő választással.
A NeMo Switchyard futásidőben értékeli a kérést és a rendelkezésre álló kontextust, majd a feladat követelményei, korlátai és szabályai alapján küldi tovább a munkát. Az NVIDIA megfogalmazása szerint a több modellből álló rendszer bizonyos terheléseknél javíthatja a pontosságot és csökkentheti a költséget ahhoz képest, mintha minden kérés a legerősebb modellhez kerülne.
Szolgáltatófüggetlen réteg a modellek felett
A NeMo Switchyard alapja a NeMo switchyard-libsy, egy szolgáltatófüggetlen SDK. Ez reprezentálja a kéréseket, meghatározza a rendszerben elérhető modelleket, és kezeli a kiválasztott modell meghívását.
A forrás szerint minden modellcél szemantikus nevet kap, miközben a mögötte lévő kliens ezt a nevet a szolgáltatói végponthoz és a modellazonosítóhoz rendeli. Ez szétválasztja az útvonalválasztási logikát a konkrét szolgáltatótól. Így egy csapat frissíthet egy modellt, áthelyezheti másik végpontra, vagy másik szolgáltatót használhat anélkül, hogy az útvonalválasztási integrációt módosítaná.
A NeMo Switchyard képes útvonalválasztási állapotot vinni egy ügynök munkamenetén belül, ha ezt a szabályzat megköveteli. Megőrizhet korábbi körökből származó információkat is, például eszközeredményeket vagy affinitási döntést, és ezt későbbi döntésekhez felhasználható kontextusként adhatja tovább.
A NeMo Switchyard szerver referenciamegoldásként közös API-kon keresztül teszi elérhetővé az útvonalválasztást, egy LLM-átjáró szimulálására. OpenAI, Anthropic és Responses API kéréseket fogad, ezeket belső NeMo Switchyard formátumra alakítja, majd a várt válaszformátumban adja vissza. Emellett rögzíti a kiválasztott modellt, a döntés indoklását, a tokenhasználatot, a késleltetést és a hívások kimenetelét.
Hangolás nélküli és tanítható útvonalválasztók
A NeMo Switchyard többféle útvonalválasztási megközelítést támogat. Az NVIDIA két fő csoportot emel ki: hangolás nélküli és hangolható útvonalválasztókat.
A hangolás nélküli megoldások közé tartozik az LLM classifier, a stage router és az escalation router. Az LLM classifier egy LLM-et használ bíróként a jelölt LLM kiválasztásához, majd munkamenet-affinitást tart fenn a kiválasztott modellel a későbbi fordulókban. Ennek célja, hogy a rendszer ne osztályozza újra ismételten azt a munkát, amely az ügynök feladatmegoldási folyamatában érdemben nem változott.
A forrás a hangolható megoldások között a prefill routereket említi, amelyek terhelési adatokból tanulnak, és azt próbálják előre jelezni, milyen valószínűséggel jár sikerrel egy modell az adott feladaton.
Az útvonalválasztási döntésekhez a rendszer többféle jelet használhat. Ilyen lehet a modell képessége, a költségprofil, a késleltetés, a rendszerterhelés, az ügynökspecifikus hibák, a kérés témája vagy becsült nehézsége, valamint a modellállapotokból származó információk.
Mérések és partneri integrációk
Az NVIDIA által közölt összefoglaló szerint a LangChain benchmarkja 74% költségcsökkenést mutatott az escalation router használatával a Nemotron 3.5 Lightning és a Claude Opus 4.8 között. A Cognition Devin Desktop esetében a staged routing a forrás szerint közel frontier szintű kódolási teljesítményt ért el 28% alacsonyabb költséggel.
A NeMo Switchyard útvonalválasztását partnerek is integrálják meglévő ügynöki eszközökbe, átjárókba és vállalati munkafolyamatokba. A forrás a LangChain, Kong, Boomi, Cognition, Nous Research, Ramp, Cadence és Siemens nevét sorolja fel.
A felhasználók és a fejlesztői csapatok szempontjából a bejelentés lényege, hogy az ügynöki rendszerekben a modellválasztás külön kezelhető réteggé válhat. Ez megkönnyítheti a különböző modellek kombinálását, a szolgáltatói végpontoktól való függetlenítést, valamint a költség, késleltetés és minőség közötti döntések ellenőrizhetőbb kezelését.
NVIDIA Developer: Route AI Agent Workloads Across Models with NVIDIA NeMo Switchyard