Az NVIDIA QAD-vel készítette el a Nemotron 3.5 Lightning NVFP4 modellt
Az NVIDIA Developer augusztus 17-én ismertette, hogyan készült a Nemotron 3.5 Lightning NVFP4 checkpoint az NVIDIA Model Optimizer és kvantálást figyelembe vevő desztilláció segítségével. A cég szerint a modell a 66 GB-os teljes pontosságú változatról 22 GB-ra csökkent, miközben akár 4-szer gyorsabb áteresztést kínál.
- A Nemotron 3.5 Lightning NVFP4 checkpoint 66 GB-ról 22 GB-ra csökkent az NVIDIA szerint.
- A cég akár 4-szer gyorsabb áteresztést állít az NVFP4 változatnál.
- A QAD a BF16 tanármodellt használja a kvantált tanulómodell javítására.
- Köztes checkpointokon a QAD 96.33 százalékról 99.72 százalékra, illetve 95.84 százalékról 98.53 százalékra javította a medián visszanyerést.
- A végső NVFP4 checkpointnál a QAD javította a Terminal-Bench v2.1 és a SWE-Bench Multilingual eredményeket.
A cél: kisebb memóriaigény, nagyobb áteresztés
Az NVIDIA bejegyzése szerint a Nemotron modellek nyílt családja lehetőséget ad a fejlesztőknek arra, hogy késleltetés, sebesség, memória és számítási igény alapján válasszanak modellt. A Nemotron 3.5 Lightning NVFP4 checkpoint ennek egyik példája: a vállalat állítása szerint sok súly 4 bites kvantálásával 66 GB-ról 22 GB-ra tömörítették a teljes pontosságú checkpointot, miközben akár 4-szer gyorsabb áteresztést értek el.
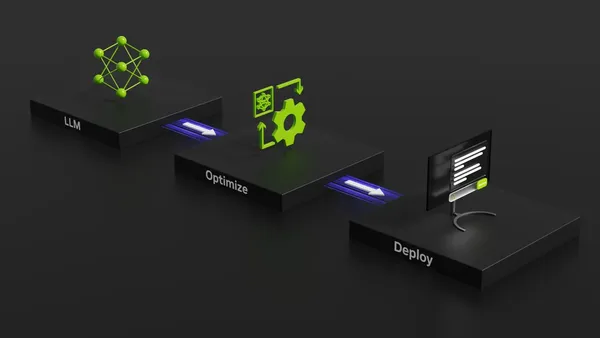
Az NVIDIA szerint az NVFP4-re tömörítéshez gyakran elegendő az utólagos kvantálás, vagyis a post-training quantization, röviden PTQ. A bejegyzés azonban azt írja, hogy szorosabb memóriahatárok és nagyobb áteresztés esetén agresszívebb kvantálásra van szükség. Erre használta a cég a quantization-aware distillation, röviden QAD módszert.
A QAD célja, hogy visszanyerje azt a pontosságot, amely az agresszív kvantálás során elveszhet. Az NVIDIA szerint a módszerrel készült NVFP4 checkpoint kevesebb memóriát használ, nagyobb áteresztést ad, és közben megőrzi a modell minőségét.
Így működik a QAD a Nemotron 3.5 Lightningnél
A bejegyzésben ismertetett eljárás két szakaszból áll. Először a teljes pontosságú modellből PTQ-val készül kvantált tanulómodell. A Nemotron 3.5 Lightning esetében a BF16 teljes pontosságú modell a tanár, a PTQ-val W4A16-NVFP4 formára kvantált változat pedig a tanuló.
A második szakaszban a befagyasztott BF16 tanármodellt desztillálják a kvantált tanulóba. Az NVIDIA leírása szerint ehhez KL-divergencia veszteséget használnak, amely a tanár és a tanuló logitjait hasonlítja össze. A tanuló minden előrehaladási lépése szimulált kvantáláson megy át, így a modell a tanítás során találkozik azzal a kvantálási zajjal, amelyet következtetéskor is kezelnie kell.
A cég szerint ez azért fontos, mert a tanuló nem csak a következő token előrejelzését tanulja, hanem a tanármodell viselkedéséhez igazodik. A folyamat célja, hogy agresszív kvantálás mellett is magas minőséget tartson meg.
A PTQ-receptek és a skálázási stratégia szerepe
Az NVIDIA több PTQ-receptet próbált ki a tanulómodell előállításához. Ezek abban különböztek, hogyan kalibrálják a súlyokat, és milyen agresszíven kvantálják a Mamba-projekciókat, valamint a KV cache-t. A választás a későbbi tanításra is hatott: a maximum alapján kalibrált receptek dinamikus skálás QAD-hez, az MSE-alapú receptek befagyasztott skálás QAD-hez vezettek.
Néhány beállítás minden receptben közös volt. A bejegyzés szerint mindegyik W4A16 formára kvantálta az lm_head réteget, amit az NVIDIA faithful lm_head néven említ, miközben az attention projection rétegek BF16 formátumban maradtak. A kalibráció 1,000 mintát használt, és egyetlen NVIDIA DGX B300 rendszeren futott.
Az NVIDIA öt PTQ-receptre koncentrált, és mindegyiknél 8k és 128k közötti szekvenciahosszal végzett kalibrációt. A cég szerint korábbi kísérletek alapján a hosszabb szekvenciahossz jobb PTQ-eredményt adhat. A bejegyzésben azt írják, hogy a four_over_six recepten a 32K szekvenciahossz adta a legjobb PTQ-eredményt, ezért minden QAD-kísérletet a 32K kalibrációjú four_over_six checkpointon végeztek.
A vállalat szerint a four_over_six W4A16 Mamba linears beállítással adta a legjobb kompromisszumot a pontosságromlás és a következtetési teljesítmény növekedése között. A legagresszívebb változat a K és V elemeket NVFP4, vagyis W4A4 formára vitte, miközben a QK és az attn dot V batched matrix multiplication műveletek BF16-ban maradtak, a Q pedig kvantálatlan volt.
Mit mutattak a mérések
Az NVIDIA azt írja, hogy csak PTQ használatakor jellemzően 99 százalék feletti medián pontosság-visszanyerést céloznak. QAD mellett viszont 95 és 99 százalék közötti medián pontosság-visszanyerés is cél lehet a PTQ-szakasz után, mert a QAD a következő lépésben javítja az eredményt. A cég szerint ez teret ad agresszívebb beállításoknak, például annak, hogy a Mamba linear rétegek W4A16 formát kapjanak a biztonságosabb FP8 helyett.
A köztes checkpointokon a QAD az NVIDIA összefoglalója szerint azonos, 21.19 GB-os memóriaigény mellett 96.33 százalékról 99.72 százalékra, illetve 95.84 százalékról 98.53 százalékra emelte a medián pontosság-visszanyerést. A végső NVFP4 checkpoint konzervatívabb kvantálási receptet használ, amelynél a PTQ önmagában 99.24 százalékos medián visszanyerést ér el.
A bejegyzés szerint a QAD még ebben a konzervatívabb végső beállításban is javította a fontos agentic benchmarkokat, köztük a Terminal-Bench v2.1 és a SWE-Bench Multilingual eredményeit.
Mit jelent ez a fejlesztőknek
A hír fő üzenete a fejlesztők számára az, hogy az NVIDIA szerint az agresszívebb kvantálás nem feltétlenül jár együtt tartós minőségvesztéssel, ha a PTQ után QAD-t is alkalmaznak. A módszer lehetővé teszi kisebb checkpointok és nagyobb áteresztés célzását úgy, hogy a pontosság egy részét a desztilláció visszahozza.
Az NVIDIA a következő lépések között a megatron_lm_qad.yaml launcher kipróbálását javasolja a teljes QAD-folyamat futtatásához, valamint a Model Optimizer QAD-dokumentáció áttekintését. A vállalat azt is írja, hogy a végső NVFP4 checkpoint letölthető a Hugging Face-ről telepítéshez és kiértékeléshez.
NVIDIA Developer: Developing Nemotron 3.5 Lightning NVFP4 with QAD Using NVIDIA Model Optimizer