Ötszörös agentikus áteresztést ért el a vLLM a DeepSeek-V4.1-Flash-sel
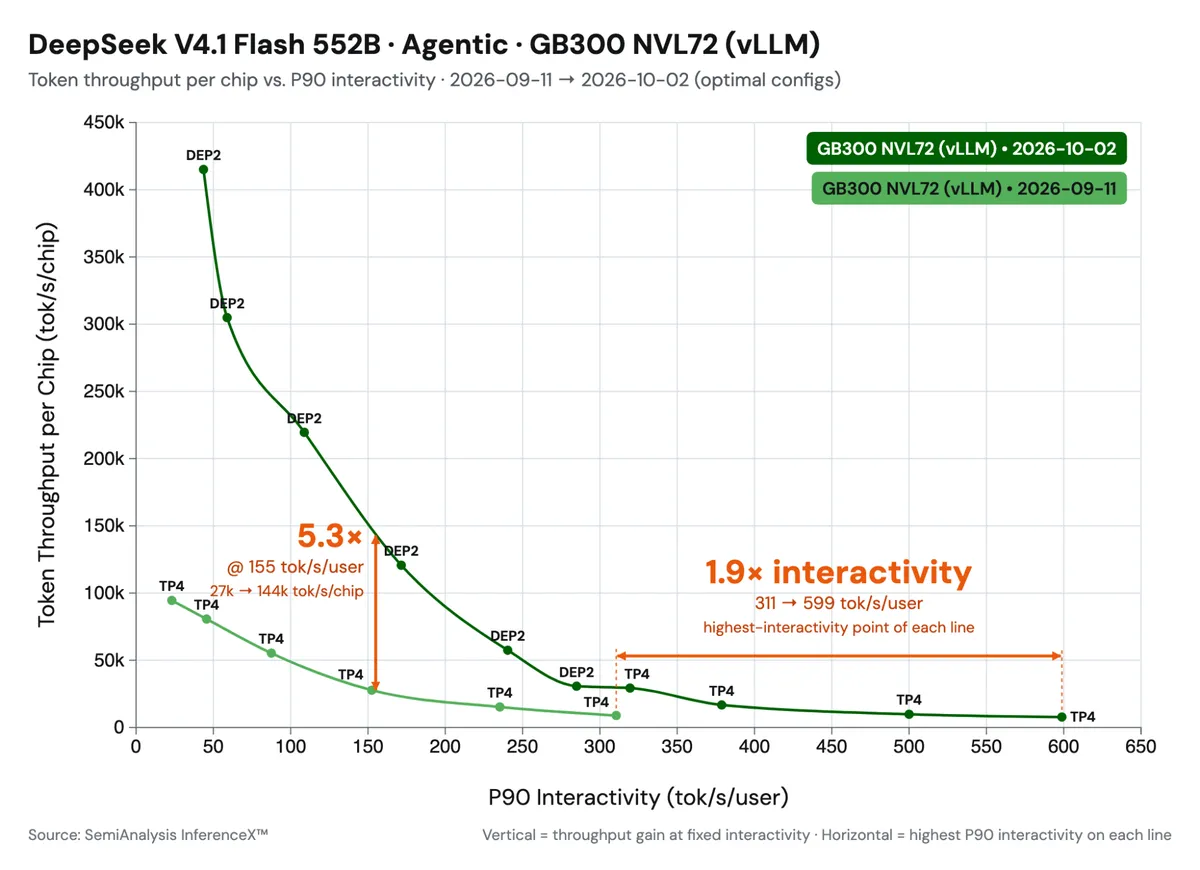
A vLLM és az Inferact optimalizációival akár 5,3-szoros áteresztést értek el a DeepSeek-V4.1-Flash esetében egy 150 TPS-es korláton. Alacsony konkurenciánál a modell 1,9-szer gyorsabban fut, mint a kiinduló változat.
- A vLLM és az Inferact 5,3-szoros áteresztést ért el 150 TPS-es korlátnál.
- Alacsony konkurenciánál 1,9-szeres gyorsulást mértek.
- A SWA bounded replay 30 és 40 százalék közötti előfeldolgozási gyorsulást hozott CUDA Graphs használatával.
- A modell globális KV-lábnyoma 890 bájt tokenenként.
- A vLLM szerint a GSM8K és GPQA pontossága érdemben nem változott.
Három hét alatt jelentős gyorsulás
A vLLM október 7-i bejegyzése szerint a DeepSeek-V4.1-Flash megjelenését követő három hétben az Inferact és a vLLM közössége több szinten optimalizálta a modellt. A SemiAnalysis AgentX agentikus kiszolgálási tesztjén a fejlesztők 5,3-szoros áteresztésjavulást mértek 150 TPS-es korlátozás mellett.
Alacsony konkurenciánál 1,9-szeres gyorsulást értek el. A vLLM szerint az eredményhez a CUDA Graphs használata, a DeepSeek által kiadott új kernelek integrációja, valamint a fennmaradó műveletek összevonása és párhuzamosítása is hozzájárult.
A fejlesztések között szerepel a MegaAttention, a Mega-mHC, a Mega-Gate és a DeepSelect integrációja. A készítők az mHC oldalsó CUDA-streamjeit is párhuzamosították, továbbá az all-reduce műveletet az előtte és utána futó műveletekkel egyetlen kernelbe vonták össze.
Kevesebb memória, rövidebb előfeldolgozás
A DeepSeek-V4.1-Flash egyik fontos jellemzője a causal encoder-decoder, vagyis CED architektúra. A modell dekódolás közben tokenenként 16 milliárd paramétert aktivál, az előfeldolgozás során viszont 8 milliárdot.
A modell a kulcs-érték gyorsítótár, vagyis KV cache méretét is több technikával csökkenti. A Compressed Sparse Attention 2, az FP4 formátumú KV cache és a rétegek közötti KV-cache-megosztás együtt a globális KV-lábnyomot 890 bájtra csökkenti tokenenként.
A modell kétféle KV cache-t használ. A globális cache tömörített, a rétegek között megosztott és FP4 formátumban tárolt. A csúszóablakos, SWA cache ezzel szemben tömörítetlen FP8 formátumú, és mind a 40 rétegben az utolsó 128 pozíciót fedi le.
A vLLM alapértelmezés szerint bekapcsolta az úgynevezett SWA bounded replay megoldást. A rendszer gyorsítótárazás helyett egy találat esetén újraszámolja az utolsó 128 tokent, az ablakot pedig a visszajátszás kezdeténél levágja. Ez nem bitpontos újraszámítás, a DeepSeek jelentése szerint azonban csak elhanyagolható minőségveszteséggel jár.
A CUDA Graphs rövid promptoknál különösen fontos
A CED architektúrában a 20. réteg számítja a dekóder globális KV-ját, amelyet a 21. és 39. réteg közötti rétegek újrahasznosítanak. A vLLM ezért minden tokenen futtatja a 20. réteget, a 21. és 39. réteg közötti részt viszont csak az egyes kérések utolsó 128 tokenjén.
Hosszú promptoknál ezzel a modell csaknem felének előfeldolgozása kihagyható. A lecsökkentett munkamennyiség miatt a kernelindítások költsége válik meghatározóvá, ezért a vLLM külön CUDA Graphs-felvételeket használ a teljes és a csonkolt rétegcsoportokra.
A vLLM mérései szerint a dekóderoldali visszajátszás CUDA Graphs használatával 30 és 40 százalék közötti mértékben csökkenti az előfeldolgozás számítási idejét. Rövid promptoknál a kernelindítási költség különösen fontos. CUDA Graphs nélkül a módszer 1K tokennél DEP2-n akár 12 százalékkal lassabb is lehet az alapváltozatnál.
A vLLM a GSM8K és a GPQA teszteken is ellenőrizte a pontosságot. A közlés szerint nem találtak érdemi különbséget, az eltérések körülbelül 1,5 standard hibán belül maradtak.
Új és összevont kernelek a kisebb késleltetésért
A DeepSeek a DeepSeek-V4.1-Flash mellett több új kernelt is közzétett három saját repositoryban. A vLLM több ilyen, nyílt forráskódú komponenst integrált. A Mega-mHC az mHC-lánc több lépését egy kernelbe vonja össze, és NVIDIA GB200-on 1,14 és 1,51-szer gyorsabb a korábbi TileLang-alapú megoldásnál.
A Mega-Gate egyetlen kernelbe egyesíti a MoE-router kapumátrix-szorzását, a szakértők pontozását, a bias műveletet és a top-k kiválasztását. Ez közepes kötegméretnél 1,18 és 1,31-szeres kernelgyorsulást eredményez.
A ritka MQA-logitokhoz használt megoldás csak a kiválasztott jelölteket pontozza. NVIDIA GB300-on rétegenként 8K tokennél 1,2-szeres, 512K tokennél 14 és 23-szoros gyorsulást mértek. A teljes dekódolás 4 darab NVIDIA GB300-on 3 és 6 százalék között javult.
A MegaAttention az NVFP4 formátumú tömörített KV-val dolgozik, amely 45 százalékkal kisebb a korábbi FP8-as cache-nél. A vLLM emellett egy alacsony késleltetésű, összevont WO-A útvonalat is készített, amely kis dekódolási kötegeknél akár 2,1-szeres gyorsulást és 6, 7 százalékkal alacsonyabb tokenek közötti késleltetést hozhat.