10 milliárd dokumentumos vektorkeresési benchmarkot adott ki a Qdrant
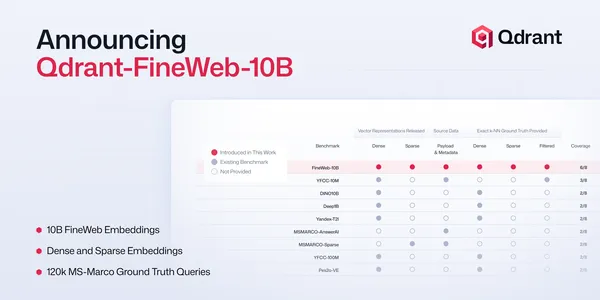
A Qdrant kiadta a Qdrant-Fineweb-10B nevű nyilvános adatkészletet, amely 10 milliárd FineWeb-dokumentum vektorágyazásait és 120 ezer lekérdezés pontos eredményeit tartalmazza. A benchmark célja, hogy a fejlesztők a milliárdos méretű adathalmazokhoz közelebb álló környezetben mérhessék a vektorkereső rendszerek pontosságát.
- A Qdrant-Fineweb-10B 10 milliárd FineWeb-dokumentumot tartalmaz.
- Az adatkészlethez 120 ezer lekérdezés és pontos referenciaeredmények tartoznak.
- A dokumentumokhoz sűrű és ritka vektorok készültek.
- A teljes korpusz feldolgozása körülbelül öt napig tartott.
- A projekt mintegy 500 ezer fájlt és 25 terabájtnyi adatot eredményezett.
Nagyobb léptékű tesztelést tesz lehetővé
A Vultr szeptember 1-jei közleménye szerint a Qdrant-Fineweb-10B olyan nyilvános benchmark-adatkészlet, amellyel a fejlesztők megvizsgálhatják, hogyan változik a keresés minősége, amikor az adatbázis mérete több milliárd rekordra nő. A csomag 10 milliárd, a FineWebből származó dokumentumot tartalmaz.
Minden dokumentumhoz sűrű és ritka vektorok (dense és sparse vectors) készültek. Az adatkészlet emellett 120 ezer lekérdezést, valamint ezek pontos, úgynevezett ground-truth eredményeit is magában foglalja. Az eredmények legfeljebb 1000 találatig állnak rendelkezésre.
Ez lehetőséget ad a csapatoknak arra, hogy azonos, nagyméretű adatkészleten hasonlítsák össze a különböző vektorkeresési beállításokat, és mérjék a találatok visszakeresési pontosságát.
A teljes korpusz feldolgozása körülbelül öt napig tartott
A Qdrant a Vultr felhős infrastruktúráját használta a FineWeb korpusz feldolgozásához. A dokumentumok vektorágyazásai az Alibaba gte-multilingual-base modelljével készültek, minden rekordhoz sűrű és ritka vektorokkal.
A feladatnál a GPU-k teljesítménye önmagában nem volt elegendő. Az adatokat elő kellett készíteni, majd megfelelő sebességgel el kellett juttatni a grafikus processzorokhoz. A munkafolyamatban CPU-s dolgozók párhuzamosan végezték a tokenizálást, mielőtt az adatok a GPU-khoz kerültek.
A Vultr közlése szerint ez a megközelítés körülbelül 19 ezer sor feldolgozását tette lehetővé másodpercenként és csomópontonként. A teljes, 10 milliárd dokumentumból álló korpusz feldolgozása körülbelül öt nap alatt fejeződött be. Az eredmény mintegy 500 ezer fájlt és 25 terabájtnyi adatot tett ki.
A létrejött vektorágyazásokat a Vultr Object Storage ideiglenesen tárolta, amíg a Qdrant le nem töltötte őket a projekt következő szakaszához.
RAG-rendszerek és AI-ügynökök fejlesztéséhez is használható
A vektorkeresés többek között a visszakereséssel kiegészített szöveggenerálást, vagyis a RAG-alkalmazásokat, a szemantikus keresést, az ajánlórendszereket és az AI-ügynököket szolgálja ki. A közlemény szerint a kisebb vagy véletlenszerűen létrehozott adatkészletek nem feltétlenül viselkednek úgy, mint az éles környezetek adatai.
Az adatmennyiség növekedésével változhatnak a memóriaigények, az indexek felépítéséhez szükséges idő, a felosztás, vagyis a sharding működése, valamint a visszakeresés pontossága. A Qdrant-Fineweb-10B ezeket a körülményeket nagyobb léptékben teszi vizsgálhatóvá, és sűrű, ritka, illetve szűrt keresésekhez is tartalmaz adatokat és pontos referenciaeredményeket.
André Zayarni, a Qdrant vezérigazgatója és társalapítója szerint az adatkészlet elkészítése olyan méretű feldolgozást igényelt, ahol az infrastruktúra és a végrehajtás egyaránt fontos. A Qdrant vezetője hozzátette, hogy a Vultr számítási és tárolási kapacitást, valamint gyakorlati támogatást biztosított a projekthez.
Kevin Cochrane, a Vultr marketingigazgatója szerint 10 milliárd dokumentum feldolgozásához a GPU-knak, a CPU-knak, a tárolásnak és az adatfeldolgozási folyamatnak együtt kell hatékonyan működnie. A projekt így a fejlesztők és kutatók számára olyan benchmarkot kínál, amely a forrás szerint közelebb áll a gyártási környezetek méretéhez.