A Qdrant 10 milliárd vektoros benchmarkot és nyílt eszközöket ad ki
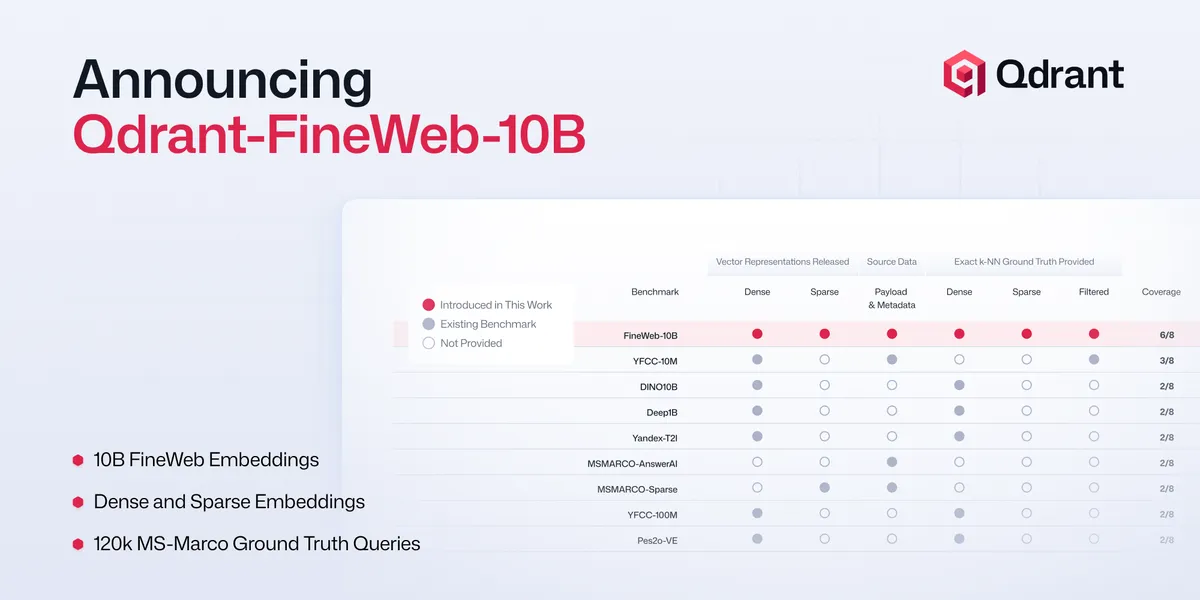
A Qdrant bemutatta a Qdrant-FineWeb-10B nevű, 10 milliárd vektort tartalmazó nyílt benchmarkot, valamint a hozzá készített Supernova keretrendszert. A vállalat szerint az eszközök reprodukálhatóbbá teszik a nagy léptékű vektorkereső rendszerek összehasonlítását.
- A Qdrant-FineWeb-10B 10,07 milliárd sűrű és 10,07 milliárd ritka vektort tartalmaz.
- A benchmark 24,47 terabájtnyi vektoradatot és 28,66 terabájt forrásszöveget, illetve metaadatot foglal magában.
- A Qdrant a teljes vektortéren pontos top-1000 igazságkészletet számított GPU-kon.
- A Supernova nyílt forráskódú keretrendszerként támogatja a generálást, betöltést és kiértékelést.
- A csomaghoz a PubMed-Multi-Vector és a Coyo-Vector-Embeddings adatkészlet is csatlakozik.
A Qdrant szerint a régi benchmarkok nem elég életszerűek
A Qdrant szeptember 1-jei bejelentése szerint a vállalatok vektorkeresési rendszerei ma már milliárdnyi vektorral és másodpercenként több ezer kéréssel dolgoznak, miközben a faroklatenciának 50 ezredmásodperc alatt kell maradnia. A vállalat úgy látja, hogy ehhez képest sok benchmark szintetikus adatokat használ, a lekérdezéseket elrejti, vagy fizetős, zárt szolgáltatásokra épít.
A Qdrant szerint egy 90 százalékos recall@10 érték egy szintetikus RAG-teszten nem feltétlenül elegendő olyan e-kereskedelmi vagy piactéri rendszerekben, amelyek több mint 1000 találatot adnak tovább egy második szakaszban működő újrarangsorolónak. A vállalat által megcélzott kutatási feltételek között legalább 95 százalékos visszahívás, nagy találati mélység, magas áteresztőképesség és 100 ezredmásodperc alatti p99 késleltetés szerepel.
10 milliárd vektor egy nyílt adatkészletben
A Qdrant a Vultr közreműködésével készítette el a Qdrant-FineWeb-10B adatkészletet a Hugging Face FineWeb korpuszára támaszkodva, a gte-multilingual-base modell használatával. A részletes leírás szerint az adatkészlet 10,07 milliárd sűrű és 10,07 milliárd ritka vektort, 24,47 terabájtnyi vektoradatot, valamint 28,66 terabájt forrásszöveget és metaadatot tartalmaz.
A készítők GPU-gyorsított hardveren számították ki a teljes 10 milliárd vektoros tér pontos, legközelebbi 1000 szomszédját. A bejelentés egyik része 120 000 sűrű, ritka és szűrt lekérdezést említ, a részletes FineWeb-10B leírás viszont 100 000 lekérdezésről beszél. A Qdrant mindkét helyen több mint egy kvadrillió távolságszámítást ír le.
A csomag mellett két további nyílt adatkészlet is megjelent. A PubMed-Multi-Vector a hibrid keresést vizsgálja sűrű, ritka és ColBERT-stílusú többvektoros reprezentációkkal, összesen több mint 8,37 milliárd többvektoros tokenen és csaknem 35 terabájtnyi adaton. A Coyo-Vector-Embeddings multimodális kereséshez használja a Qwen3-VL-Embedding-2B modellt, 2048 dimenziós reprezentációkkal.
A Supernova a teljes benchmarkfolyamatot lefedi
A Qdrant nem csak statikus adatkészleteket tett közzé. A Supernova ingyenes, teljesen nyílt forráskódú keretrendszer, amellyel a közösség saját infrastruktúráján generálhat, előkészíthet, ellenőrizhet és mérhet internetes léptékű adatkészleteket.
A rendszer négy fő szakaszt automatizál: a beágyazások létrehozását, a nyers erővel végzett pontos igazságkészlet-számítást, az adatbázis betöltését és a kiértékelést. A nova-embed különböző beágyazási és tárhelyháttereket egységesít, a nova-bf GPU-n számítja a pontos szomszédokat, a nova-load a párhuzamos betöltést, a nova-storm pedig a keresési terhelést méri.
A keretrendszer Qdrant, Milvus és Elasticsearch háttérrendszerekkel is használható. A nova-storm többek között a lekérdezések másodpercenkénti számát, a p50, p95 és p99 késleltetést, a felépítési időt és a recallt követi. A SkyPilotra épülő nova-dist AWS, GCP, Azure, Kubernetes és Slurm HPC környezetben kezeli a fürtök létrehozását, az ütemezést és a hibakezelést.