Qdrant
A Qdrant Constella modelljeivel újraágyazás nélkül váltható a keresőmodell
A Qdrant bemutatta a Constella kutatási előzetesét, amely lehetővé teszi, hogy ugyanazon dokumentumvektorok mellett változtassák a lekérdezésekhez használt…
A Qdrant Constella modelljei újrabeágyazás nélkül cserélhetők
A Qdrant bemutatta a Constella kutatási előzetesét, amely lehetővé teszi, hogy ugyanabban a vektoradatbázisban a lekérdezésekhez használt modellt újrabeágyazás nélkül…
Rustban írták újra a cross-encoder inferenciát, de nem mindenhol lett gyorsabb
A Qdrant Rustban írta újra a cross-encoder modellek futtatását, majd Python-alapú könyvtárakkal hasonlította össze. A cross-encode-rs kis modellen csak mérsékelten…
Olcsó módszerrel csökkentené a többnyelvű RAG nyelvi torzítását a Qdrant
A többnyelvű RAG-rendszerek gyakran a kérdés nyelvén keresnek választ akkor is, ha egy másik nyelvű dokumentum relevánsabb lenne. A Qdrant egy friss kutatás alapján a…
10 milliárd dokumentumos vektorkeresési benchmarkot adott ki a Qdrant
A Qdrant kiadta a Qdrant-Fineweb-10B nevű nyilvános adatkészletet, amely 10 milliárd FineWeb-dokumentum vektorágyazásait és 120 ezer lekérdezés pontos eredményeit…
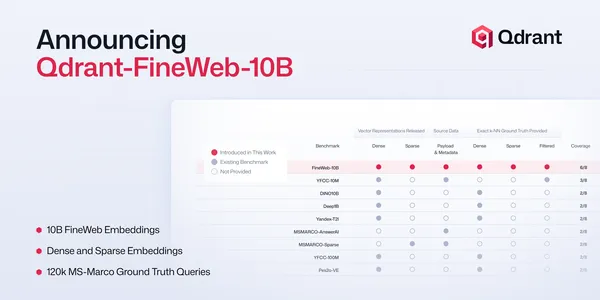
A Qdrant 10 milliárd vektoros benchmarkot és nyílt eszközöket ad ki
A Qdrant bemutatta a Qdrant-FineWeb-10B nevű, 10 milliárd vektort tartalmazó nyílt benchmarkot, valamint a hozzá készített Supernova keretrendszert. A vállalat szerint…
A Qdrant és a LangChain a termelési használatra hangolja a vektorkeresést
A Qdrant és a LangChain együtt olyan RAG-alapú alkalmazások fejlesztését támogatja, amelyek a prototípus után is skálázhatók maradnak. A megoldás középpontjában a…
A Qdrant öt méréssel tenné kiszámíthatóbbá a vektoros keresést
A Qdrant öt nyilvános adathalmazon vizsgálta, hogyan érdemes hangolni a vektoros keresés beállításait. A vállalat szerint a mérések segítenek eldönteni, hogy a…
A Qdrant és a Minima 2,92-szer több sikeres RAG-feladatot ért el
A Qdrant és a Minima közös tesztjében 2,92-szeresére nőtt a sikeres, ügynökalapú RAG-feladatok száma GPU-óránként. A rendszer a keresést és a Qwen3.6-27B futtatását is…
A Bayer 135 millió vektorral épített vállalati keresőt
A Bayer belső myGenAssist platformja havonta több mint 1,5 millió üzenetet dolgoz fel, miközben több mint 450 ezer feltöltött dokumentumot kezel. A gyógyszeripari és…
A Qdrant szerint a vektorkeresés szűrését menet közben kell kezelni
A metaadatszűrés a vektorkeresésben jelentősen ronthatja a találatok minőségét, miközben a lekérdezés gyorsnak és hibátlannak tűnik. A Qdrant ezért nem egyszerűen elő-…
Qdrant 1.19: kilencszer kisebb tárolás és új memóriahangolás
Megjelent a Qdrant 1.19.0, amely új, 4 bites vektortárolási formátumot, egységes memóriaosztályokat és több szűrési fejlesztést hoz. A kiadás a Web UI kezelését és a…