A Qdrant öt méréssel tenné kiszámíthatóbbá a vektoros keresést
A Qdrant öt nyilvános adathalmazon vizsgálta, hogyan érdemes hangolni a vektoros keresés beállításait. A vállalat szerint a mérések segítenek eldönteni, hogy a visszakeresés, a rangsorolás, a reranker vagy éppen a memóriahasználat okozza-e a problémát.
- A Qdrant öt nyilvános adathalmazon vizsgálta a vektoros keresés hangolását.
- A hét gyűjteményszintű beállítás hibája hibaüzenet nélkül is ronthatja a találatokat.
- A jelöltek számának növelése javíthatja a visszakeresést, de a rangsorolás továbbra is elrejtheti a releváns dokumentumokat.
- A k=61 érték 480 lekérdezésből 202 esetben változtatta meg az első helyezett dokumentumot egy adathalmazon.
- A kvantálásnál a memóriahiány 4,3 ezredmásodpercről 43,4 ezredmásodpercre növelte ugyanazon lekérdezés idejét.
A beállítások önmagukban nem árulják el, mi romlott el
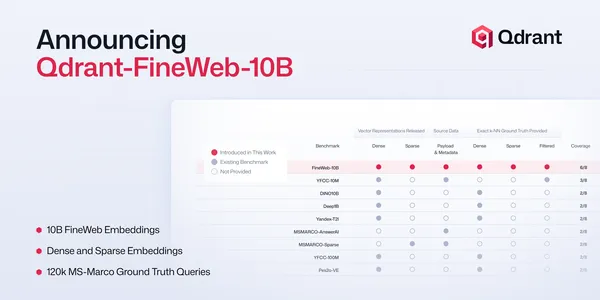
A Qdrant augusztus 24-én öt cikkből álló sorozatot tett közzé a vektoros keresés hangolásáról. A vizsgálatok öt nyilvános adathalmazon készültek, amelyek 5183 és 4,6 millió dokumentum közötti méretűek voltak.
A sorozat egy olyan keresési útvonalat vizsgál, amelyben egy sűrű és egy ritka, vagyis sparse vektoros lekérdezés jelölteket gyűjt, a fúzió egyetlen rangsorba rendezi ezeket, majd egy opcionális újrarangsoroló modell, vagy reranker, átrendezi a lista elejét.
A Qdrant szerint hét gyűjteményszintű beállítás csendben korlátozhatja a keresés minőségét. Például, ha egy sparse vektor nem használja az IDF-módosítót, a ritka szavak nem kapnak nagyobb súlyt a gyakoriaknál. Ha a BM25 átlagos dokumentumhossza az alapértelmezett értéken marad, a rendszer minden dokumentum hosszát hibásan ítélheti meg. Egyik esetben sem feltétlenül jelenik meg hibaüzenet.
A címkézett lekérdezések száma szintén számít. A Qdrant futtatásaiban 25 címkézett lekérdezés nem volt elegendő, mert a mérési zaj nagyobb volt, mint a fúzió hangolásával elért javulás.
Előbb azt kell kideríteni, hol veszik el a relevancia
A vállalat különválasztja azt az esetet, amikor a keresés nem találja meg a megfelelő dokumentumot, attól, amikor megtalálja, de túl hátra sorolja. A jelöltek számának 10-ről 500-ra emelése legfeljebb 0,28-cal javította az elérhető legjobb pontszámot. A felhasználók által látott pontszám ugyanakkor legfeljebb 0,01-gyel változott, mert a rangsorolás sok esetben elrejtette a már megtalált releváns dokumentumokat.
Az egyik gyakran állított paraméter, a hnsw_ef, a végső pontszámot legfeljebb 0,0022-vel módosította a vizsgálatokban. A Qdrant ezért olyan ellenőrzést javasol, amely még a drágább javítások előtt megmutatja, hogy a visszakeresés vagy a rangsorolás a szűk keresztmetszet.
Hibrid keresésnél a reciprok rangfúzió k paramétere határozza meg, mennyire számítanak az egyes listák legelőkelőbb helyezettjei. A Qdrant alapértelmezett k=2 értékéről az eredeti tanulmányban szereplő k=61-re váltás az egyik adathalmazon 480 lekérdezésből 202 esetben megváltoztatta az első helyezett dokumentumot. A vállalat másik fúziós módszere, a DBSF, nem használ paramétereket, és az öt adathalmazból háromnál jobb eredményt ért el az alapértelmezett RRF-nél.
A reranker és a memória ára is mérhető
A Qdrant szerint a reranker bevezetése előtt érdemes a fúziót hangolni. A négy vizsgált reranker közül a legjobb mind az öt adathalmazon felülmúlta a Qdrant alapértelmezett fúzióját. A hangolt fúzióhoz képest azonban a javulás nagy része eltűnt, és az egyik összehasonlításban a reranker rosszabb eredményt adott. A modell minden jelöltre külön előreirányítást végez, ezért minden lekérdezésnél késleltetést okoz.
A kvantálás a vektorok tömörített másolatát memóriában tartja, majd az eredetik újbóli beolvasásával korrigálja a tömörítés hibáját. Amíg az eredetik elférnek a memóriában, ez a művelet a Qdrant szerint csaknem ingyenes. Amikor azonban lemezről kell olvasni, ugyanaz a lekérdezés 4,3 ezredmásodpercről 43,4 ezredmásodpercre lassult. A visszaskálázás kikapcsolása közben a sűrű keresési szakasz a valódi legközelebbi szomszédoknak csak hatból tízét találta meg.
Az öt cikk ezért problémánként ad kiindulópontot: a gyűjtemény alapbeállításainak ellenőrzését, a jelöltmélység mérését, a hibrid keresés fúziójának hangolását, a reranker költségének vizsgálatát, valamint a memóriahatár elérésének mérését. Ha több probléma is fennáll, a Qdrant először a címkézett lekérdezéskészlet felépítését javasolja, mert a további ellenőrzések erre támaszkodnak.
Qdrant: How to Tune Vector Search Without Guessing