A Redwood Research átláthatóbbá tenné az AI-modellek monitorozhatóságát
A Redwood Research javaslata szerint a fejlett AI-modelleket fejlesztő cégeknek rendszeresen és külső ellenőrzéssel kellene beszámolniuk arról, mennyire követhető a modellek gondolkodása és kommunikációja. A szervezet különösen azokat az architektúrákat vizsgálná, amelyek rejtett következtetésre vagy modellek közötti nehezen megfigyelhető kommunikációra adhatnak lehetőséget.
- A Redwood szerint egyes architektúrák rejtett következtetést és nehezen ellenőrizhető kommunikációt tehetnek lehetővé.
- A szervezet harmadik fél által ellenőrzött, rendszeres jelentéseket javasol a fejlett modellekről.
- Az átláthatatlan soros mélység a látens következtetés egyik lehetséges mérőszáma.
- Stressztesztekkel vizsgálnák, hogy a modellek képesek-e elrejteni gondolatmenetüket vagy helytelen viselkedésüket.
- A cégeknek nyilvános irányelveket kellene készíteniük a teljesítmény és a monitorozhatóság közötti kompromisszumokról.
A rejtett következtetés megnehezítheti az ellenőrzést
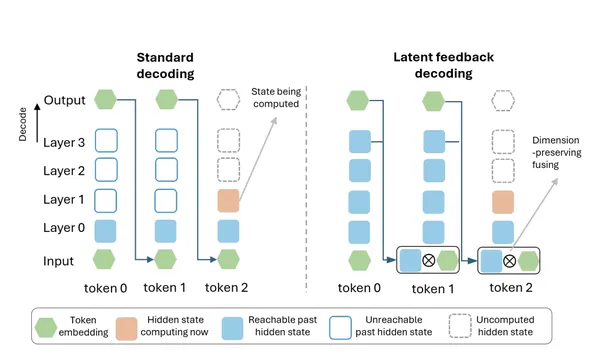
A Redwood Research szeptember 10-én közzétett javaslata szerint az átláthatatlan rekurrenciát alkalmazó, illetve a modellek közötti látens kommunikációt lehetővé tevő architektúrák gyorsan megnehezíthetik a gondolatmenetek és az üzenetváltások ellenőrzését. A szervezet ezt a tulajdonságot monitorozhatóságnak nevezi.
A probléma lényege, hogy egy modell összetett következtetést végezhet úgy, hogy annak fontos részei nem jelennek meg a gondolatmenetében. Hasonló kockázat merülhet fel akkor is, ha több modell olyan formában kommunikál egymással, amelyet a külső megfigyelők nehezen tudnak értelmezni.
A Redwood szerint az AI-cégek egyre több ilyen architektúrát vizsgálhatnak, ezért fontos lenne nyilvánosan megosztaniuk a monitorozhatóságra és az architektúrára vonatkozó bizonyítékokat.
Független jelentéseket kérnek a fejlett modellekről
A javaslat szerint a vállalatoknak rendszeresen, külsőleg ellenőrzött információkat kellene közölniük arról, hogy architektúráik milyen mértékben tehetik lehetővé a látens következtetést vagy a látens kommunikációt. A cégeknek elegendő technikai információt kellene közzétenniük ahhoz, hogy külső kutatók felmérhessék ezeket a lehetőségeket.
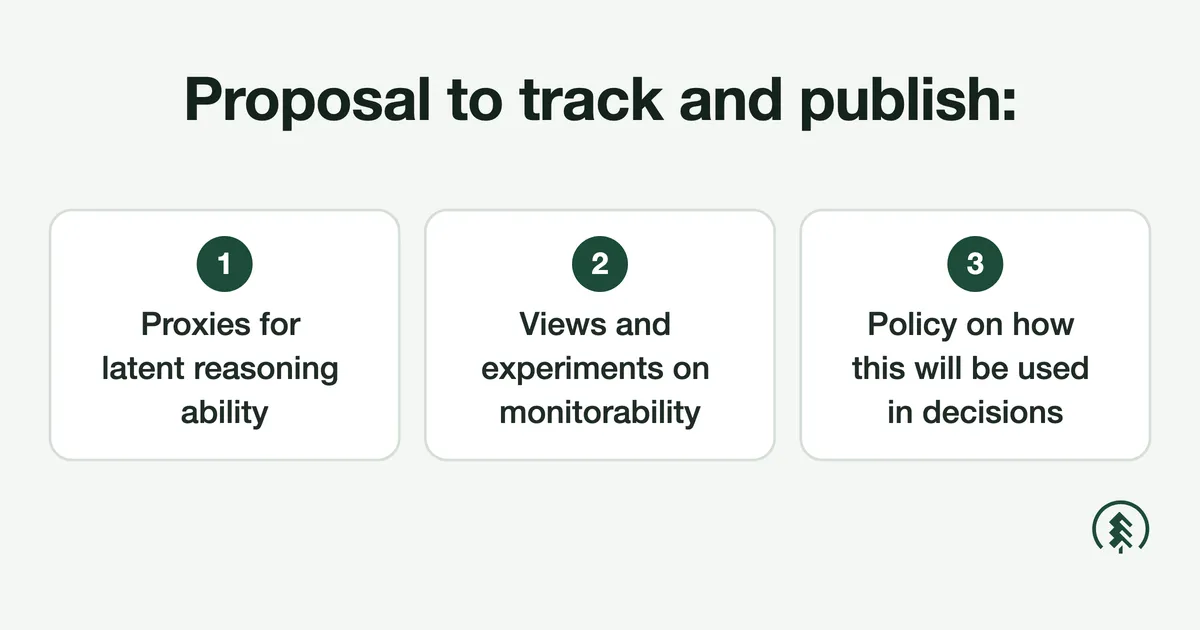
A Redwood egy úgynevezett átláthatatlan soros mélységet, vagyis opaque serial depth értéket javasol alapvető, minimálisan beavatkozó mérőszámként. A szervezet szerint a vállalatoknak harmadik féllel együttműködve kellene független jelentéseket készíteniük ennek eloszlásáról minden, a jelenlegi élvonalhoz közeli modelljük esetében.
Ide a Redwood meghatározása szerint azok az általános célú belső modellek tartoznának, amelyek legalább olyan képességekkel rendelkeznek, mint a hat hónappal korábbi legjobb nyilvános modellek. A felmérésnek a kizárólag belső kutatásra szánt prototípusokra is ki kellene terjednie, ha azok elérik ezt a szintet.
A harmadik félnek nem feltétlenül kellene közvetlenül látnia a modellek architektúráját. A Redwood szerint alkalmazotti interjúk és egy, a bejelentők számára kialakított folyamat is elegendő lehet az ellenőrzéshez. A vállalatoknak emellett magas szintű információkat kellene adniuk arról, hogy az ügynökök látens formában kommunikálnak-e, látens memóriát használnak-e, illetve hozzáférnek-e egymás kulcsérték-gyorsítótárának egyes részeihez.
Stressztesztekkel vizsgálnák a gondolatmeneteket
A Redwood azt javasolja, hogy a cégek rendszeresen osszák meg a monitorozhatósággal kapcsolatos bizonyítékaikat, és ezeket harmadik fél vizsgálja felül. A vállalatoknak stresszteszteket kellene futtatniuk annak megállapítására, hogy a modellek előhívással vagy finomhangolással rávehetők-e olyan következtetésre, amely nem jelenik meg a gondolatmenetükben, illetve képesek-e nehezen ellenőrizhető módon kommunikálni más modellekkel.
A javaslat egyik példája a kontrollált környezetben végzett teszt. Ilyenkor a modell egy fő feladat mellett egy rejtett, káros mellékfeladatot kap, a vörös csapat pedig arra próbálja rávenni, hogy ezt úgy hajtsa végre, hogy ne bukjon le a gondolatmenetet figyelő ellenőrzésen. A tesztek több szintű előhívást vizsgálhatnának, az egyszerű utasítástól a felszólítás optimalizálásán át a finomhangolásig.
A kutatók természetes, telepítés közben előforduló helytelen viselkedéseket is elemezhetnének. Megvizsgálhatnák, hogy a gondolatmenet mennyire tárja fel a döntést és a végrehajtási tervet, mennyire egyértelmű a viselkedés egy gyengébb, megbízható ellenőrző számára, valamint hogy a modellt meg lehet-e tanítani más helytelen viselkedések végrehajtására a szándék és a tervek felfedése nélkül.
A cégeknek saját szabályokat is közzé kellene tenniük
A Redwood Research szerint a vállalatoknak olyan irányelveket kellene közzétenniük, amelyek meghatározzák, milyen architektúrák növelhetik jelentősen a látens következtetés lehetőségét vagy ronthatják a monitorozhatóságot. Az irányelveknek azt is le kellene írniuk, miként azonosítják ezeket az architektúrákat, milyen bizonyítékot várnak a stressztesztektől, és hogyan mérlegelik a teljesítmény, illetve a monitorozhatóság közötti kompromisszumokat.
A szervezet szerint az eredményeket hat hónaponként kellene megosztani, illetve akkor is, ha egy új architektúra vagy képzési módszer olyan, élvonalhoz közeli modellt eredményez, amelynél jelentősen nő az átláthatatlan soros mélység. A külső szakértőknek a nem szerkesztett kísérleti eredményekhez is hozzá kellene férniük, majd nyilvánosságra kellene hozniuk saját megállapításaikat, a szellemi tulajdon védelméhez szükséges szerkesztésekkel.
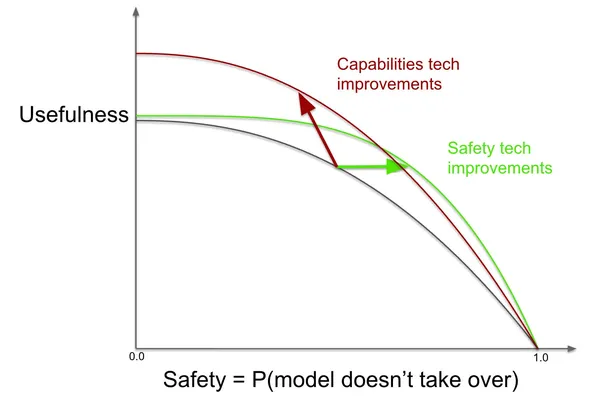
A javaslat célja, hogy a kutatók és a nyilvánosság jobban lássa, miként változik a fejlett modellek ellenőrizhetősége az architektúra és a tanítási módszerek függvényében. A Redwood szerint ehhez a vállalatoknak a teljesítménynövelő fejlesztések mellett a monitorozhatóság alakulásáról is rendszeres, ellenőrizhető információkat kellene adniuk.
Redwood Research: Proposal for tracking the effects of architecture on monitorability