A SambaNova szerint az AI-ügynökök miatt prémium lett a gyors következtetés
A SambaNova szerint az AI-ügynökök terjedése külön termékkategóriává tette a gyors, kis késleltetésű modellkiszolgálást. A vállalat olyan hibrid infrastruktúrát vázolt fel, amelyben a GPU-k és saját RDU-egységei eltérő feladatokat végeznek.
- A SambaNova szerint az AI-ügynökök miatt külön prémium kategóriává vált a gyors következtetés.
- A MiniMax nagy sebességű kimeneti tokenjeinek ára 2,40 dollár 1 millió tokenenként.
- Az OpenAI Fast módja a vállalat szerint akár 2,5-szer gyorsabb lehet a Standard feldolgozásnál.
- A SambaNova hibrid architektúrája a prefillhez GPU-kat, a dekódoláshoz RDU-egységeket használna.
- A SambaRack SN50 a SambaNova szerint nagyjából 820 token/másodperces sebességet ér el a MiniMax M2.7-tel.
Az ügynökök felerősítik a késleltetés problémáját
A SambaNova augusztus 10-én közzétett bejegyzése szerint a prémium következtetés, vagyis az inference, nagy és intelligens modellek gyors, folyamatos és kiszámítható kiszolgálását jelenti. Az AI-ügynökök esetében ez különösen fontos, mert a rendszer egyetlen válasz után nem áll le. Tervez, eszközöket hív meg, dokumentumokat és korábbi eredményeket olvas, kódot generál, ellenőrzi a munkáját, majd újabb ciklusokat indít.
A vállalat az OpenAI egyik beszámolójára hivatkozik, amely szerint egy hosszú futású Codex-ügynök nagyjából 25 órán át működött, hozzávetőleg 13 millió tokent használt fel, és mintegy 30 ezer sornyi kódot generált, miközben folytatta az ellenőrzést és a javítást. Ilyen munkafolyamatoknál a lassú tokenenkénti generálás nem csak egyetlen válasz elkészültét késlelteti, hanem a teljes termékélményt.
A szolgáltatók már külön árazott sebességet kínálnak
A SambaNova szerint a piac már elkezdte külön kezelni a gyorsabb kiszolgálást. A MiniMax a MiniMax-M2.7 modellnél a nagy sebességű kimeneti tokenekért 1 millió tokenenként 2,40 dollárt kér, szemben a normál kimenet 1,20 dolláros árával. Az OpenAI, az Anthropic és a Fireworks szintén kínál gyorsabb, prémium kategóriába sorolt módokat vagy csomagokat.
A forrás szerint az OpenAI új Fast módja olyan, nagy értékű, felhasználókkal közvetlenül kapcsolatban álló alkalmazásokhoz készült, ahol a késleltetés kiemelt szempont. A vállalat állítása szerint a GPT-5.6 Sol esetében ez a Standard feldolgozásnál akár 2,5-szer nagyobb sebességet biztosíthat, tokenenkénti felár mellett. Az Anthropic hasonló igényt céloz a Claude fast mode-dal. A Fireworks a Kimi K3 modellt Fast serverless kategóriában kínálja, a normál árhoz képest 50 százalékos felárral.
Rodrigo Liang, a SambaNova társalapítója és vezérigazgatója szerint „a prémium következtetés új kategória, amelyet az olyan ügynökök hajtanak, amelyeknek gyors, interaktív tokenekre van szükségük, a legjobb chipenkénti teljesítménnyel az intelligens, élvonalbeli modelleken”.
A SambaNova hibrid architektúrát javasol
A vállalat szerint a prémium kiszolgálás nehézsége abból fakad, hogy egyszerre kell jó minőséget, alacsony késleltetést, megfelelő áteresztőképességet, megbízhatóságot és elfogadható költséget biztosítani. A nagyobb modellek több memóriamozgatást, hálózati terhelést és összetettebb kiszolgálást igényelnek. A nagyobb konkurencia javíthatja az üzleti áteresztőképességet, ugyanakkor ronthatja az egy felhasználóra jutó élményt.
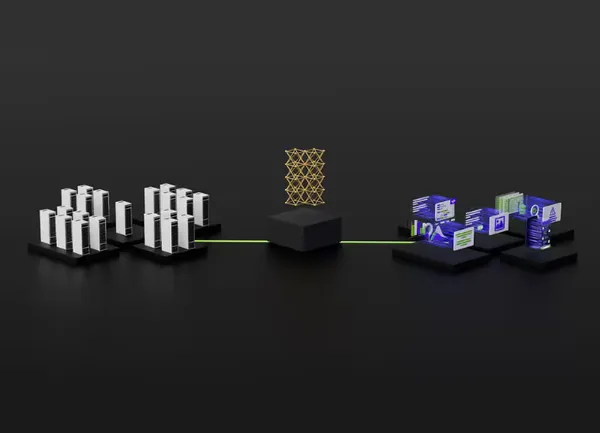
A SambaNova a feladatok szétválasztását, az úgynevezett disaggregated inference megközelítést tartja praktikusnak. A promptok, dokumentumok, kódok, eszközhívások és korábbi beszélgetések feldolgozása, vagyis a prefill, számításigényes szakasz, amelyhez a GPU-k jól illenek. A tokenenkénti dekódolás ezzel szemben késleltetésérzékeny, és a memória mozgatása válik szűk keresztmetszetté. Ezt a fázist a SambaNova Reconfigurable Dataflow Unit, röviden RDU egységei célozzák.
A szolgáltatási réteg a forrás szerint a gyorsítótár állapota, a kontextus hossza, a felhasználói szint és a késleltetési cél alapján irányíthatja a munkát a különböző erőforrások között. A SambaNova állítása szerint a SambaRack SN50 a MiniMax M2.7 modellt nagyjából 820 token/másodperces sebességgel futtatja prémium interakcióhoz, illetve hozzávetőleg 420 token/másodperccel, ha az áteresztőképesség és a konkurens kérések kezelése a cél.
Mit jelent ez az AI-szolgáltatások felhasználóinak?
A bejelentés alapján a felhasználók számára a gyorsaság elsősorban a több lépésben dolgozó rendszereknél válhat érzékelhetővé. Egy kódoló ügynök, kutatási segéd vagy vállalati asszisztens minden újabb tervezési, eszközhasználati és ellenőrzési ciklussal tovább dolgozik, ezért a tokenenkénti várakozás összeadódik.
A SambaNova szerint a szolgáltatók számára ez lehetőséget ad arra, hogy a gyorsabb kiszolgálást külön, prémium szintként árazzák, ahelyett hogy annak költségét teljes egészében maguk viseljék. A vállalat az OpenAI prompt-gyorsítótárazási útmutatójára is hivatkozik, amely szerint az ismétlődő előtagok használata akár 80 százalékkal csökkentheti az első tokenig eltelt időt, a bemeneti tokenek költségét pedig akár 90 százalékkal. A SambaNova értelmezésében ez tovább növeli a dekódolás, vagyis a felhasználó által közvetlenül érzékelt tokenkibocsátás szerepét.
SambaNova: Premium Inference: Serving Fast Tokens for Agentic AI