Virtuális kézmozdulatokkal segítené az XR-asszisztenseket a Google
A Google Research 2026. augusztus 25-én mutatta be az AgentHands nevű XR-kutatási prototípust. A rendszer nagy nyelvi modellre épül, és beszéddel szinkronizált, kifejező virtuális kézmozdulatokkal segítené a fizikai térben végzett feladatokat.
- A Google Research 2026. augusztus 25-én mutatta be az AgentHands XR-kutatási prototípust.
- A rendszer LLM-válaszokból beágyazott GestureEvent elemeket készít, majd ezeket beszéddel szinkronizált kézmozdulatként jeleníti meg.
- A prototípus szemkövetést és jelenetrekonstrukciót használ tárgyak 3D-s regisztrálásához.
- A 12 fős vizsgálatban az AgentHands a beszédalapú változathoz képest javította a helyek, műveletek és figyelmeztetések értelmezését.
- A bejelentés kutatási prototípusról szól, nem kereskedelmi termékbevezetésről.
Beszélő asszisztensből térben mutató segítő
Az AgentHands célja, hogy az XR-környezetben működő társalgási asszisztensek ne csak szóban adjanak útmutatást, hanem a felhasználó fizikai környezetéhez igazított kézmozdulatokkal is. A Google Research szerint a prototípus a mentális leképezés problémáját kezeli: azt a helyzetet, amikor a felhasználónak a szóbeli instrukcióból kell kitalálnia, pontosan melyik tárgyra, részre vagy mozdulatra utal az asszisztens.
A bejelentés szerint az olyan fejlesztések, mint a Project Astra és a Gemini 3.1 Flash Live, már lehetővé teszik, hogy a felhasználók valós időben beszéljenek fizikai környezetükről. Ezeknél gyakori megoldás, hogy a rendszer vizuális keretekkel jelöl tárgyakat a kameraképen. A Google Research szerint ez a 2D-s képernyőkön hatékony, az immerszív platformokon, például Android XR-en viszont új kérdést vet fel: hogyan lehet a sík felületen túl térbeli, testet öltött párbeszédet létrehozni.
Az AgentHands erre a problémára ad kutatási választ. A CHI 2026-on publikált prototípus a beszéddel együtt megjelenő gesztusok, angolul co-speech gestures elvét viszi át 3D-s környezetbe. A rendszer a Google Research leírása szerint nem csak mutatásra használ virtuális kezeket, hanem formákat ír le, cselekvéseket utánoz, és hangsúlyokat is közvetít, a hanggal összehangolva.
Hogyan működik az AgentHands
A kutatók először formatív vizsgálatot végeztek a Google XR és ember számítógép interakciós, HCI-szakértőivel, hogy meghatározzák, mitől lesz egy virtuális kéz jól értelmezhető 3D-s környezetben. Ebből többdimenziós taxonómiát állítottak össze, amely meghatározza, hogyan használja az asszisztens a kezeit a beszélgetés térbeli lehorgonyzására.
A taxonómia több szempontot kezel. Ide tartozik, hogy egy vagy két kéz jelenjen meg, valamint az is, milyen gesztusforma illik a helyzethez, például tenyér figyelmeztetéshez vagy hengeres fogás egy eszköz tartásának utánzásához. A térbeliség azt szabályozza, hol jelenjen meg a kéz: lehet a levegőben általános beszélgetéshez, tárgyhoz rögzítve egy konkrét rész azonosításához, vagy a felhasználóhoz viszonyítva társas jelzésekhez.
A rendszer a mozgás időbeliségét és a vizuális effekteket is kezeli. A gesztusok nem statikus pózok, lehetnek például öntést vagy körberajzolást utánzó animációk. Az XR vizuális rétegét a prototípus effektekkel egészítheti ki, például piros fénnyel jelezhet hőveszélyt.
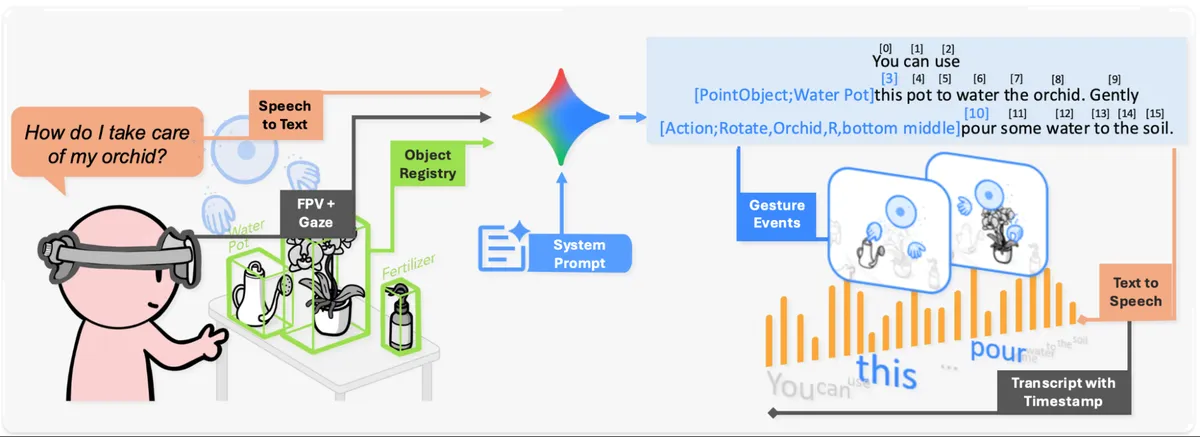
A működés első lépése egy könnyű objektumregisztrációs modul. A rendszer szemkövetés és jelenetrekonstrukció segítségével teszi lehetővé, hogy a felhasználó tárgyakat jelöljön meg, például egy orchideát vagy laptopot. Ezekből 3D-s határolódobozokat tartalmazó térbeli regiszter készül, amelyre az asszisztens később hivatkozhat.
A Google Research kézmozdulat-eseménykönyvtárat is készített. A viselkedéseket három szemantikai csoportba sorolták: rámutató gesztusok hivatkozáshoz, ikonikus gesztusok cselekvések vagy formák megjelenítéséhez, valamint kifejező gesztusok társas jelzésekhez és érzelmekhez.
A nyelvi válaszból időzített mozdulat lesz
Amikor a felhasználó kérdez, a háttérben működő nagy nyelvi modell olyan választ generál, amely beágyazott GestureEvent elemeket tartalmaz. Ezek az események konkrét kiváltó szavakhoz kapcsolódnak, és a taxonómia dimenziói szerint írják le a kézmozdulat alapelemeit.
Az XR-headseten futó helyi elemző ezután összehangolja a beszédszintézist, angolul text-to-speech vagy TTS lejátszást az animációs motorral. A rendszer szószintű időbélyegeket használ, így a Google Research szerint az asszisztens kezei a kimondott szavakkal pontos szinkronban hajtják végre a gesztusokat. A cél, hogy a nyelvi szándék és a fizikai cselekvés között folytonos kapcsolat jöjjön létre.
A bemutatott alkalmazási példák között szerepel az orchideagondozás. Ilyenkor az asszisztens nem pusztán azt mondja, hogy a felhasználó ellenőrizze a gyökereket, hanem a növény tövéhez mozgatja a kezeit, és körberajzolja a léggyökereket, miközben elmagyarázza a funkciójukat.
Egy másik példa a 3D-nyomtató kezelése. A rendszer képes megmutatni a vezérlőgombok használatához szükséges pontos fordítás és kattintás sorrendjét, valamint támogatja a menüben való navigálást. A harmadik bemutatott terület az életmódtámogatás: a prototípus wellness coachként is működhet, például interaktív figyelmeztető gesztussal és vizuális effektussal óvhat egészségtelen viselkedéstől.
Mit mutatott a felhasználói vizsgálat
A hatás mérésére a Google Research alanyon belüli vizsgálatot végzett 12 résztvevővel, N = 12. Az AgentHands rendszert beszédalapú kiindulási változattal hasonlították össze. Mindkét feltételben ugyanazt a kutatók által megírt szóbeli tartalmat használták, így a különbséget a testet öltő kezek és azok szinkronizált gesztusai adták.
A résztvevők két eljárásalapú feladatot végeztek. Az orchideagondozási feladatban növényi részeket, például léggyökereket és szárakat kellett azonosítaniuk, majd több lépésből álló gondozási tevékenységeket végeztek, célzott öntözéssel és megfelelő műtrágya-alkalmazással. A 3D-nyomtatós feladatban hardverelemeket, például a fúvókát és a nyomtatóágyat kellett felismerniük, majd bekapcsolási, SD-kártya behelyezési és vezérlőpaneles munkafolyamaton mentek végig.
Az eredmények a Google Research szerint azt jelezték, hogy az XR és a beszéddel együtt megjelenő gesztusok együtt hatékonyak a térben lehorgonyzott interakciókban. A résztvevők szignifikánsan könnyebben találták meg azokat a tárgyakat és irányokat, amelyekre az asszisztens utalt, p < 0.05. A szükséges tevékenységek követhetőségét is könnyebbnek értékelték, p < 0.05.
A forrás szerint a figyelmeztetések hatásosabbak voltak, amikor gesztusokkal és vizuális effektekkel párosultak. A 3D-nyomtatós feladatban használt égési effektet az egyik résztvevő a Google Research idézete szerint így jellemezte: „igazán lenyűgöző”. Egy másik résztvevő az orchideás feladatnál azt mondta: „csak akkor értettem meg, hogy fel kell emelnem az orchideát, hogy a víz lefolyhasson, amikor az asszisztens megmutatta az emelő mozdulatot”.
Mit jelenthet ez az XR-felhasználóknak
Az AgentHands egy kutatási prototípus, ezért a Google Research közleménye nem termékbevezetésről, árról vagy széles körű elérhetőségről szól. A jelentősége inkább abban áll, hogy megmutatja, milyen irányba mozdulhatnak az XR-ben működő asszisztensek, ha a beszédet térbeli, időzített mozdulatokkal egészítik ki.
A forrásból levezethető felhasználói előny a fizikai feladatok könnyebb követése. Ha az asszisztens pontosan ott mutat rá egy növényi részre, egy 3D-nyomtató alkatrészére vagy egy veszélyes pontra, ahol a felhasználó dolgozik, kevesebb találgatásra van szükség. A vizsgálat eredményei alapján ez javíthatja a helymeghatározást, a cselekvések megértését és a figyelmeztetések észrevételét.
A Google Research szerint a résztvevők az instrukciókat könnyebben értették és jegyezték meg, a minőségi visszajelzésekben pedig a kezeket egy vezető partnerhez hasonlították. Ez arra utal, hogy az XR-asszisztensek jövőbeli használatában a beszéd, a térbeli megértés és a gesztusok összekapcsolása különösen fontos lehet olyan helyzetekben, ahol a felhasználónak valódi tárgyakkal kell pontos lépéseket végrehajtania.