A vLLM bitre azonosította az RL-tréning és az inferencia eredményeit
A vLLM olyan módszert mutatott be, amelyben a megerősítéses tanulás tréning- és inferenciaoldala bitre azonos logprobokat állít elő minden mintavételezett tokenre. A DeepSeek-V4-Flash esetében a rendszer 91,3 százalékos rollout-teljesítményt ért el a nagy teljesítményű alaphoz képest, miközben a különbség minden lépésben nulla volt.
- A vLLM tréningben és inferenciában bitre azonos logprobokat állított elő.
- DeepSeek-V4-Flash esetén a diff több mint 100 lépésben minden alkalommal nulla volt.
- A konzisztens futás a nagy teljesítményű rollout alap 91,3 százalékát érte el.
- Nemotron-3.5-nél a SWE-bench Pro eredménye stabil maradt, miközben az alapváltozat visszaesett.
- A folyamatot agent skill, receptek és kód teszi átvihetőbbé új modellekre.
Eltérő számítások instabillá tehetik az RL-tréninget
A megerősítéses tanulásban az inferenciamotor választ generál, a tréningrendszer pedig újraszámolja a tokenek valószínűségeit, majd frissíti a modellt. Ha a két oldal ugyanazokkal a súlyokkal is eltérő számításokat végez, a tréning egy olyan szabályzatot optimalizál, amely különbözik attól, amely a választ létrehozta.
A vLLM szerint a rollout teljesítményének növelésére használt alacsony pontosságú számítás, az alacsony pontosságú KV-cache, valamint a kommunikációs és kerneloptimalizálások megváltoztatják az inferencia numerikáját. A különbség az egyes frissítésekkel növekedhet, és instabillá teheti a tréninget, ami összeomlásokhoz, visszaállításokhoz és újrafuttatásokhoz vezethet.
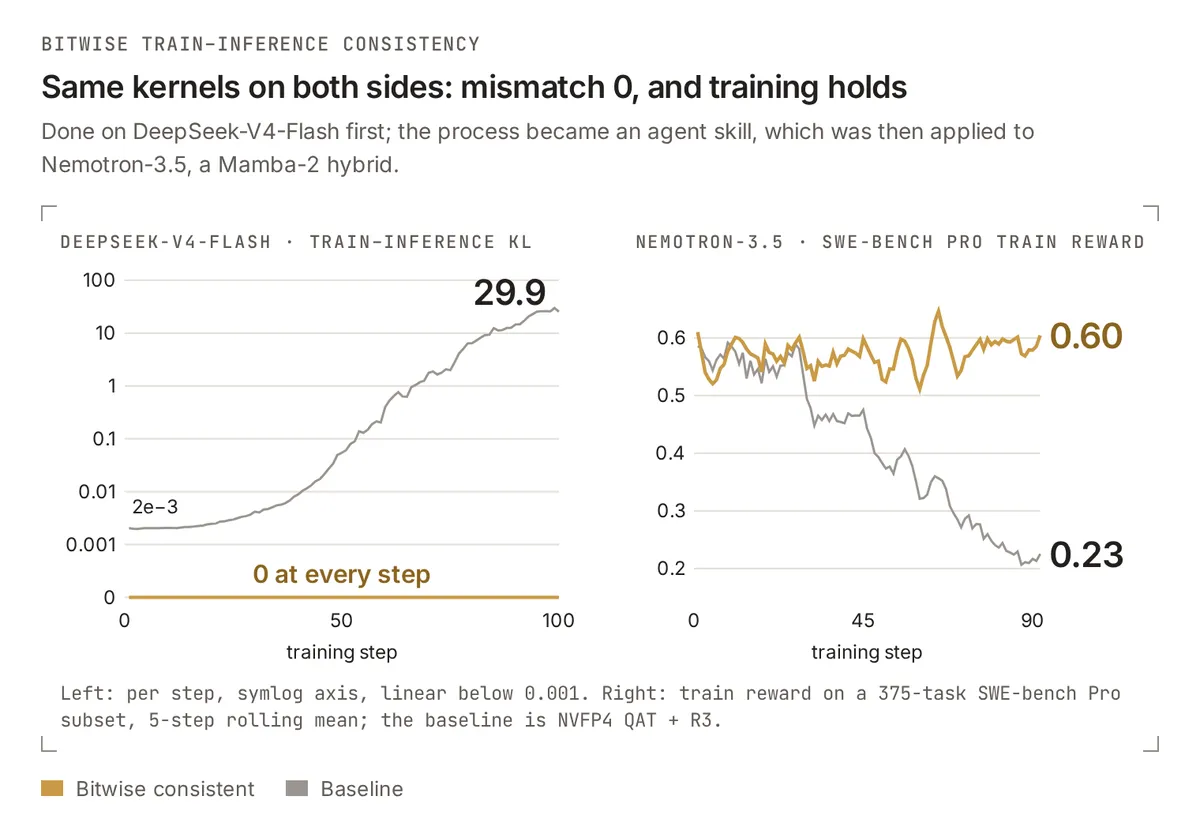
A DeepSeek-V4-Flash-Base kísérletben, algoritmikus korrekció nélkül, a nagy teljesítményű alapváltozat tréning és inferencia közötti KL-eltérése 2e-3-ról 29.9-re nőtt, miközben a jutalom visszaesett.
A tréning közvetlenül a vLLM inferenciás kerneljeit használja
A vLLM megközelítésében a tréning előreirányuló számítása közvetlenül a vLLM inferenciás kerneljeit hívja. Ezeket a nagy teljesítményű kerneleket úgy módosították, hogy a rollout és a tréning ugyanazt a logprobot adja minden mintavételezett tokenre.
A vLLM ezt bitre azonos eredményként definiálja. A rollout által számított és a tréningoldalon újraszámolt logprobok közötti eltérés, vagyis a diff, minden tokennél nulla. Az elfogadáshoz a tokenenkénti eltérés maximumának, átlagának és szórásának, valamint a k3 KL-értéknek is pontosan nullának kell lennie.
A megoldásnak akkor is azonos eredményt kell adnia, ha változik a batch összetétele, a prefillelés vagy a dekódolási szakasz, illetve a párhuzamos elrendezés. A vLLM szerint ezt a feltételt a DeepSeek-V4-Flash esetében minden vizsgált tréninglépésben teljesítették.
DeepSeek-V4-Flash és Nemotron-3.5 eredményei
A DeepSeek-V4-Flash több mint 100 tréninglépésén a diff minden lépésben nulla maradt. Ehhez a rendszer a nagy teljesítményű alapváltozat rollout-átviteli sebességének 91,3 százalékát érte el.
A módszert később a vLLM egy NVFP4-et használó Mamba-hibrid, a Nemotron-3.5 esetében is alkalmazta. A SWE-bench Pro ötlépéses gördülő átlagával mérve a konzisztens futás eredménye nagyjából 0,6 körül maradt, míg az alapváltozaté 0,56-ról 0,23-ra, a részletes leírás szerint 0,22-re esett.
A vLLM kiemeli, hogy ez a bejegyzés a numerikai konzisztenciát, a tréninggörbéket és a rollout teljesítményét méri. A teljes, faliórával mért gyorsulást a kevesebb összeomlás és újrafuttatás miatt hosszabb futásokon lehetne vizsgálni, ezt az összehasonlítást későbbre hagyták.
Agent skill segíti az új modellek illesztését
A bitre azonos működés elérése modellenként és operátoronkénti összehangolást, valamint ellenőrzést igényel. A vLLM ezt a folyamatot agent skill formájában is kiadta a hozzá tartozó receptekkel és kóddal.
Az agent skill azt írja le, hogyan lehet megtalálni az első operátort, ahol a tréning és az inferencia eltér, miként lehet minimális reprodukciót készíteni, kijavítani a problémát, majd újra lefuttatni a regressziós teszteket. A vLLM szerint a DeepSeek-V4.1 esetében már elérték a nulla diffet, a teljesítményhangolás véglegesítése pedig külön bejegyzésben jelenik meg.