A vLLM-ben akár 2,8-szorosára nőtt a Kimi K3 áteresztőképessége
Jelentősen gyorsult a Kimi K3 kiszolgálása a vLLM-ben: a fejlesztések 2,2, 2,8-szoros áteresztőképességet és 56, 60 százalékkal alacsonyabb késleltetést hoztak. A vLLM szerint az első napi támogatás után a teljes kiszolgálási verem több pontján is optimalizálni kellett a rendszert.
- A Kimi K3 áteresztőképessége 2,2, 2,8-szorosára nőtt a tesztben.
- Az átlagos késleltetés 56, 60 százalékkal csökkent.
- A TTFT javulása 72, 85 százalék között alakult.
- Az adaptív ütemezés és a KDA-ellenőrzőpontok csökkentették a felesleges munkát.
- A dekódolási kontextuspárhuzamosság hosszú, közös prefixeknél növelte a gyorsítótár kapacitását.
Nagy gyorsulás a tesztelt munkaterhelésen
A vLLM szeptember 13-án közzétett beszámolója szerint a Kimi K3 teljesítményét a v0.27.1 verzióhoz képest a 0913-as, 82a85dc1 commitot tartalmazó állapotban mérték. A teszt egy B300-as csomóponton, CUDA 13.3 használatával zajlott, 8 ezer bemeneti és 1 ezer kimeneti tokenes munkaterheléssel, TP8 konfigurációban, nyolc spekulatív tokennel.
A párhuzamos kérések számát 1, 4 és 16 értéken vizsgálták. Az átlagos késleltetés 12,37 másodpercről 5,30 másodpercre csökkent egyidejű kérésnél, ami 57,2 százalékos javulás. Négy kérésnél 23,67 másodpercről 10,50 másodpercre, 16 kérésnél pedig 55,90 másodpercről 22,17 másodpercre mérséklődött az érték.
Az áteresztőképesség egy kérésnél 83,3-ról 183,3 tokenre nőtt másodpercenként, négy kérésnél 166,7-ről 416,7-re, 16 kérésnél pedig 258,3-ról 725,0-ra. Az első tokenig eltelt idő, vagyis a TTFT, rendre 2262,9, 2314,9 és 7601,1 ezredmásodpercről 376,3, 640,5 és 1121,0 ezredmásodpercre csökkent.
Az ütemezéstől a GPU-kódig több ponton módosítottak
Az egyik változtatás az adaptív, ütemezett tokenkeret bevezetése volt. A korábbi logika alacsony kérdésszámnál a maximális, 8192 tokenes keret jelentős részét kihasználatlanul hagyta. A PR #51725 ezt a keretet a kérések számához igazítja, a PR #51726 pedig a magas memóriájú GPU-khoz tartozó alapértelmezett limitet 8192-ről 16 384-re emelte. A vLLM szerint ez a vizsgált munkaterhelésen 55, 65 százalékkal csökkentette a TTFT-t, az áteresztőképességet pedig legfeljebb 41,5 százalékkal növelte.
A KDA, vagyis a Kimi K3 rekurrens állapotának kezelése szintén változott. A belső prefix-ellenőrzőpontokkal egy 8 ezer tokenes előfeldolgozásnál a rendszer egyetlen FlashKDA-hívással dolgozza fel az összes tokent, miközben a 7680. tokennél elmenti az állapotot. Korábban ehhez két modell-előrefuttatásra és rétegenként két FlashKDA-hívásra volt szükség. A PR #52789 a vLLM szerint 9, 25 százalékkal csökkentette a TTFT-t.
A vegyes, spekulatív és nem spekulatív kötegek kezelésénél a korábbi hat index_select és két index_copy művelet helyett közvetlen, másolás nélküli szeleteket használnak. Ez 4-es és 16-os konkurenciánál 5,2, 7,7 százalékos áteresztőképesség-növekedést hozott, egyetlen kérésnél viszont nem változtatott az eredményen. Az MXFP4 véglegesítését is a látens farok kerneljébe helyezték át, így egy kernelindítás és egy köztes tenzor írása, majd olvasása maradt ki. Ez nagyjából 5 százalékkal csökkentette a végpontok közötti késleltetést.
Memóriakezelés és hosszú kontextusú kiszolgálás
A ReplaySSM megközelítés a KDA-állapot minden spekulatív pozíció utáni eltárolása helyett a legutóbbi SSM-bemeneteket puffereli, majd a véglegesítéskor újra felépíti az elfogadott állapotot. A visszagörgetés ilyenkor csak egy pufferpozíció mozgatását jelenti. A vLLM szerint azonos, 46,48 GiB-os gyorsítótárkeret mellett a tényleges kapacitás TP8 esetén 10,97 százalékkal nőtt, a pontosság romlása nélkül.
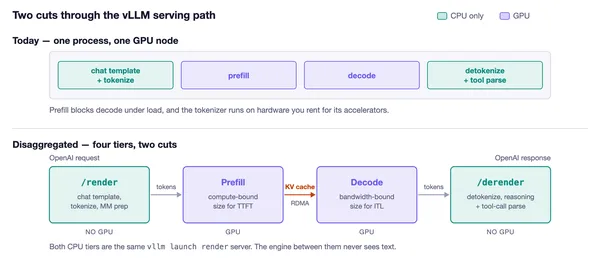
A fejlesztések érintették az előfeldolgozás és a dekódolás szétválasztását, valamint a gyorsítótárak áthelyezését is. A Kimi K3 esetében az MLA KV-gyorsítótár és a KDA-állapot egyaránt továbbítandó, miközben a KDA-állapot fejenként és dimenziónként szilánkolt. Emiatt a tisztán figyelemalapú modellekhez használt adatátviteli feltételezések itt nem alkalmazhatók közvetlenül.
A dekódolási kontextuspárhuzamosság a hosszú, közös prefixet használó ügynöki munkaterheléseknél lehet fontos. A módszer a szekvencia dimenziója mentén osztja fel az MLA látens KV-gyorsítótárát. Négy GB200-on a lekérdezéscsere késleltetése 10,4, 29,9 százalékkal csökkent. Egy 120 ezer tokenes munkaterhelésnél, amelyből 114 ezer token közös prefix volt, a KV-gyorsítótár kapacitása 1,93 millióról 19,75 millió tokenre nőtt. A TPOT mediánja egyidejű kérésnél 13,8 ezredmásodpercről 10,5-re, két kérésnél 16,2-ről 11,8-ra csökkent.
Mit kapnak ebből a Kimi K3 felhasználói?
A változtatások a Kimi K3-at vLLM-en futtató üzemeltetők számára alacsonyabb válaszidőt és nagyobb kapacitást jelenthetnek a bemutatott konfigurációhoz hasonló környezetben. A beszámoló szerint a fejlesztők a memóriakiosztást, a szekvencia- és csővezeték-párhuzamosságot, a KDA előfeldolgozását, az MLA-t, a MoE-t és a GEMM-műveleteket is vizsgálták. A teljes munkát a Kimi K3 Performance Optimization #50587 követi.
A vLLM külön kiemeli, hogy a javulást nem egyetlen nagy mátrixművelet gyorsítása adta. Az ütemezési korlátok, a kis tenzormásolások, a rekurrens állapotok és az adatmozgás egyaránt befolyásolhatta a végeredményt. A közzétett számok ezért a Kimi K3 és a vLLM adott verziói, illetve a megadott hardver- és tesztbeállítás mellett értendők.