AI-ügynökkel gyorsítana ROS 2 node-okat az NVIDIA Isaac ROS
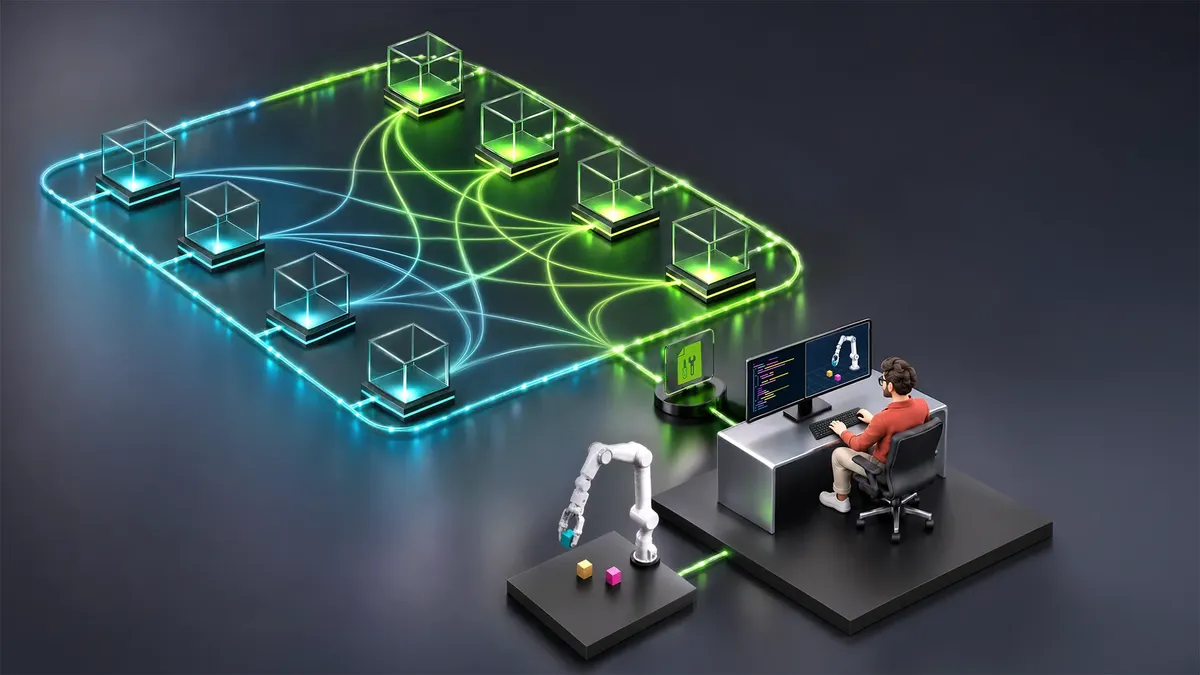
Az NVIDIA egy AI kódolóügynökre épülő munkafolyamatot mutatott be, amely ROS 2 node-ok CUDA buffer backendre való átállítását segíti. A cél, hogy a GPU-n lévő adatok bizonyos feltételek mellett felesleges CPU-s másolások nélkül mozoghassanak a ROS 2 gráfban.
- A rosidl::Buffer és a CUDA buffer backend bizonyos feltételek mellett nulla másolásos GPU-adatátvitelt tesz lehetővé ROS 2 node-ok között.
- Az NVIDIA szerint az Isaac ROS 5.0 összes node-ja frissült a CUDA buffer backend használatára.
- A migrate-node-to-rosidl-buffer skill AI kódolóügynökkel vizsgálja és tervezi meg a minimális átállítást.
- A példában a Depth Anything 3 TensorRT ROS 2 node továbbra is sensor_msgs/msg/Image üzenetet használ.
- Az ellenőrzéshez az NVIDIA Nsight Systems és a backend típusának vizsgálata használható.
GPU-n maradó adatok a ROS 2 gráfban
Az NVIDIA Developer Blog 2026. szeptember 22-én megjelent bejegyzése szerint a CUDA-val gyorsított robotikai feladatoknál önmagában a gyors kernel nem elég a teljes ROS 2 gráf felgyorsításához. A node-ok között mozgó üzenetek továbbra is sorosításon vagy CPU-memórián keresztüli másoláson mehetnek át, ami csökkentheti annak előnyét, hogy az érzékelési és AI-feladatok a GPU-n futnak.
A bejegyzés középpontjában a ROS 2 Lyricalben elérhető rosidl::Buffer absztrakció és az NVIDIA által a ROS Lyricalhez hozzájárult CUDA buffer backend áll. Ezekkel a ROS 2 node-ok a forrás szerint GPU-n lévő adatterheket cserélhetnek nulla másolásos adatátvitellel, ha a futásidejű feltételek ezt lehetővé teszik. Közben megmaradnak a szabványos ROS 2 üzenetek és a node-határok.
Az NVIDIA azt írja, hogy az NVIDIA Isaac ROS 5.0 összes node-ját frissítették a CUDA buffer backend használatára, hogy kihasználják a rosidl::Buffer által lehetővé tett hatékonyabb adatmozgatást.
Mit tud a rosidl::Buffer és a CUDA buffer backend?
A ROS 2 Lyricalben a változó hosszúságú primitív tömbmezők, például a uint8[], a generált C++ kódban rosidl::Buffer<uint8_t> típusként jelennek meg. Az alapértelmezett, CPU-alapú rosidl::Buffer a meglévő ROS 2 kód által várt std::vector<uint8_t> felülethez hasonlóan viselkedik, így megőrzi a forráskompatibilitást.
Az NVIDIA által hozzájárult CUDA buffer backend a rosidl::Buffer<uint8_t> tárolását CUDA Virtual Memory Management, vagyis VMM segítségével valósítja meg. Ha a kiadó és a feliratkozó teljesíti a backend futásidejű követelményeit, az adatterhelés társhelyzetű node-ok között sorosítás és host oldali másolás nélkül mozoghat. Ha ezek a feltételek nem teljesülnek, a ROS 2 automatikusan visszaáll a CPU-s útvonalra, amely kompatibilis a meglévő ROS 2 node-okkal.
Az optimalizált útvonalhoz ugyanaz a host, CUDA-eszköz, Linux-felhasználó és támogatott RMW implementáció szükséges. A forrás példaként az rmw_fastrtps_cpp és az rmw_zenoh_cpp implementációt említi.
AI-ügynök végzi az átállítási auditot
A cikk egy agent-driven, vagyis ügynökvezérelt munkafolyamatot mutat be. Ebben egy AI kódolóügynök a kifejezetten erre készített migrate-node-to-rosidl-buffer skill segítségével vizsgál meg egy meglévő CUDA-gyorsított node-ot. Az ügynök feladata az adatmozgás követése, egy minimális, az interfészt megőrző átalakítás megtervezése, majd annak ellenőrzése, hogy a CUDA adatátviteli útvonal valóban bekapcsolt-e.
A skill nem sablonnal váltja ki a node-ot, és nem automatikus teljes újraírást végez. A leírás szerint többek között rögzíti a kiinduló revíziót, a cél ROS-környezetet és a helyi változásokat, ellenőrzi az üzenetmező típusának kompatibilitását, hozzáadja a CUDA buffer backend csomagokat függőségként, majd végigköveti az üzenetmezőket a fogadástól a publikálásig.
Az audit kiterjed a tranzitív CUDA-hívásokra, a stride-okra, a streamekre, az opcionális kimenetekre és a tulajdonlásra is. A cél a forrás szerint a lehető legkisebb, az eredeti ROS-szerződést megőrző javítás elkészítése, majd a szemantika, a backend-egyeztetés, a külön folyamatok közötti átvitel, a bufferélettartam és a tényleges memóriamásolási viselkedés külön ellenőrzése.
A példa a Depth Anything 3 TensorRT ROS 2 node
Az NVIDIA a Depth Anything 3, röviden DA3, TensorRT ROS 2 node-on mutatja be az átállítást. A forrás szerint a DA3 modell tetszőleges számú vizuális bemenetből képes térben konzisztens geometriát becsülni, ismert kamerapózokkal vagy azok nélkül. A példában a node meglévő callbackje a beérkező ROS képet OpenCV nézetté alakítja, NVIDIA TensorRT-vel monokuláris metrikus mélységbecslést futtat, majd az eredményül kapott cv::Mat objektumot visszaalakítja ROS képpé, és lebegőpontos mélységképként publikálja.
A cikk szerint a node algoritmusa már eleve GPU-gyorsított, de a ROS-határon CPU-alapú adatút veszi körül. Ez megfelelő lehet CPU-s producer vagy fogyasztó mellett, viszont feleslegessé válhat, ha a két oldalon lévő node-ok már CUDA-memóriát tudnak előállítani és fogyasztani. Ilyenkor a két, adatterhelés méretű host oldali átvitel, a host allokáció és a sorosítás optimalizálható.
Az átállítás során az üzenetdefiníció nem változik, a node továbbra is a sensor_msgs/msg/Image típust használja. A skill a cuda_buffer és cuda_buffer_backend csomagokat adja hozzá függőségként, a feliratkozást pedig úgy módosítja, hogy elfogadjon CUDA-backed buffereket. A CPU-s útvonal alapértelmezett tartalék marad, ezért a node szintjén nincs szükség külön CPU-s és CUDA-s callbackre.
A TensorRT wrapper is úgy módosul, hogy CUDA buffer handle-öket fogadjon bemeneti és kimeneti adatokhoz, miközben megőrzi meglévő API-ját. Az NVIDIA szerint a ROS transport változtatása kicsi marad: egy feliratkozási opció, egy CUDA allokáció, két stream-tudatos handle-kinyerés és egy publikálás. Nincs szükség egyedi üzenetre, duplikált CUDA topicra vagy külön CPU/CUDA publisher ágra.
Mit jelent ez a fejlesztőknek?
A bejegyzés alapján a megközelítés fő előnye, hogy a GPU-gyorsított robotikai alkalmazások fejlesztői szabványos ROS 2 mezőkön keresztül használhatják a hatékonyabb adatmozgatást. A memóriamegosztás és az adat-élettartam kezelése a rosidl::Buffer és a CUDA buffer backend mögé kerül, miközben az inkompatibilis partnerek számára megmarad a CPU-s visszaesési út.
Az NVIDIA az ellenőrzéshez az NVIDIA Nsight Systems használatát említi. Ezzel igazolható, hogy a ROS-határon nincs adatterhelés méretű host-device átvitel. A cikk szerint az is ellenőrizhető, hogy a msg->data.get_backend_type() értéke cuda, ha mindkét végpont teljesíti a követelményeket.
A következő lépések között az NVIDIA Isaac ROS 5.0 letöltése, a ROS 2 Lyrical rosidl::Buffer és CUDA buffer backend dokumentációjának áttekintése, valamint a cikkben használt migrate-node-to-rosidl-buffer agent skill telepítése szerepel.
NVIDIA Developer: Accelerating a ROS 2 Node with an AI Agent and NVIDIA Isaac ROS