Az NVIDIA AI-ügynökökre szabott TensorRT-projektet épít
Az NVIDIA olyan nyílt forráskódú projektet épít, amelyben a kódoló AI-ügynökök önálló, ellenőrizhető feladatokon dolgoznak. A TensorRT Model Connect július 29-i kiadása 128 modellcsaládot fedett le NVIDIA GB300-on tesztelve.
- A TensorRT Model Connect nyílt forráskódú C++ modellreferencia-implementációkat kínál.
- A projekt AI-ügynökökre szabott, elkülönített és visszafordítható munkafolyamatokra épül.
- A július 29-i kiadás 128 modellcsaládot fedett le NVIDIA GB300-on tesztelve.
- Az elfogadást tesztek, referencia-összehasonlítások, teljesítménymérések és emberi felülvizsgálat segíti.
A TensorRT Model Connect célja
Az NVIDIA TensorRT Model Connect nyílt forráskódú, C++ nyelven készült modellreferencia-implementációk gyűjteménye, amely az NVIDIA TensorRT-re épül. A projekt kiinduló kérdése az volt, hogy miként lehetne az NVIDIA következtetési veremének teljesítményét olyan modellfejlesztők számára is elérhetővé tenni, akik nem TensorRT-szakértők.
Az NVIDIA eredetileg kódoló AI-ügynökökkel végzett kísérletként indította a munkát. A csapat később arra kereste a választ, hogyan nézne ki egy komoly szoftverprojekt, ha már a kezdetektől AI-ügynökökre terveznék, ahelyett hogy egy meglévő fejlesztési folyamatot gyorsítanának fel velük.
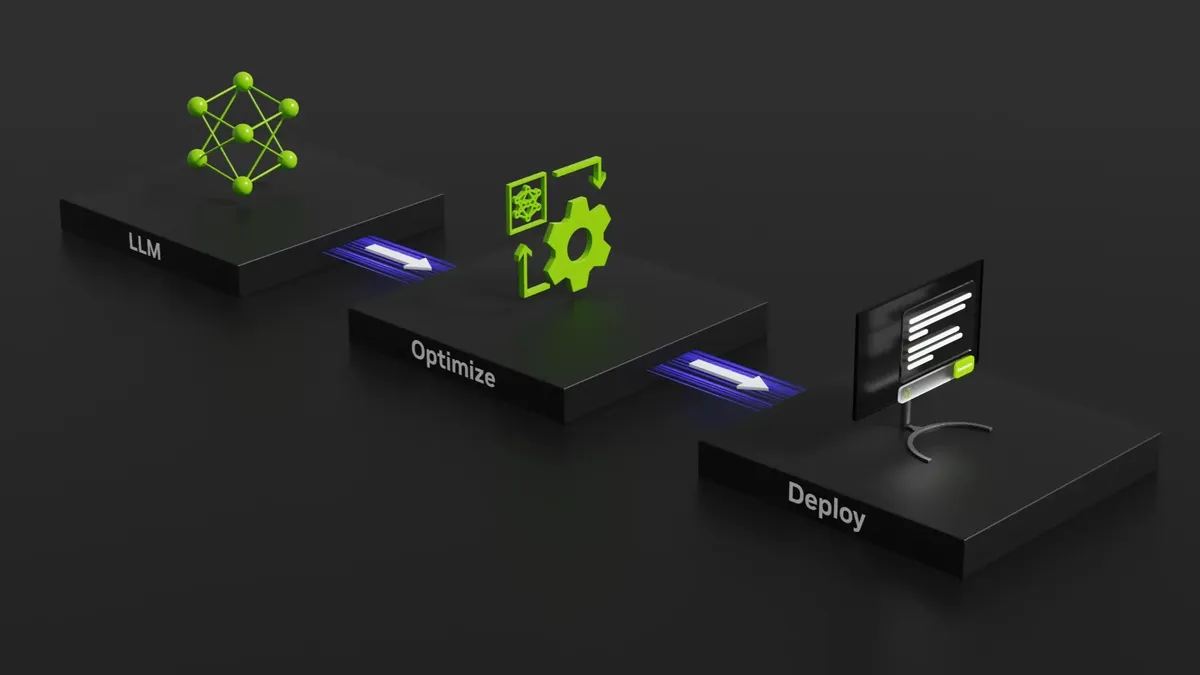
A projekt támogatott Hugging Face- vagy helyi ellenőrzőpontokból verziózott .bundle artefaktumokat készít, majd feladatorientált natív C++ API-kat kínál többek között szöveges, képi, hangalapú, diffúziós, szegmentációs, beágyazási és előrejelzési feladatokhoz.
Párhuzamos munka, szigorú elfogadási feltételek
Az NVIDIA szerint az AI-natív működés lényege, hogy az AI által előállított eredményeket moduláris, ellenőrizhető munkadarabokként kezelik. Az elkülönítés célja, hogy egy hibás változtatás ne indítson el hibákból álló láncreakciót a teljes rendszerben.
A fejlesztési feladatokat ezért úgy választják ki, hogy azok vízszintesen, egymástól függetlenül skálázhatók legyenek. A modellcsaládok, konfigurációk, operátorok, futtatási útvonalak és ellenőrzési esetek gyakran külön vizsgálhatók. Az NVIDIA TensorRT Model Connect július 29-i, nyilvános kiadási összehasonlítása szerint 128 modellcsaládot tartalmazott, amelyeket NVIDIA GB300-on teszteltek.
Az ügynökök általában egy célkitűzést kapnak, például egy modellcsalád támogatását, pontossági hiányosság megszüntetését vagy egy teljesítményút javítását. A részletes megvalósítási recept helyett a csapat meghatározza a kívánt eredményt, a határokat és az elfogadáshoz szükséges bizonyítékokat. Ezek között meglévő referencia-implementációk viselkedése, projektspecifikus tesztek és technikai korlátok szerepelhetnek.
Az elkülönítés a hibák terjedését is korlátozza
A projekt több, eltérő sebességgel változó réteget választ szét. A TensorRT és a CUDA stabil végrehajtási alapot ad, ahol a kompatibilitás, a teljesítmény, a megbízhatóság és a hosszú távú szerződések kapnak elsőbbséget. A TensorRT Model Connect gyorsabban változó integrációs rétegként kapcsolja össze ezt az alapot a folyamatosan bővülő modellökoszisztémával.
A modellcsaládok saját implementációikban tartják a modellre jellemző tudást, így a felépítők, futtatási folyamatok, segédkernel-ek, konfigurációk és ellenőrzési bizonyítékok annál a családnál maradnak, amelyik használja őket. Az NVIDIA szerint némi kódismétlés elfogadható ár azért, hogy a független fejlesztési egységek biztonságosabban skálázódjanak.
A változtatásokat lehetőleg könnyű értékelni és visszavonni. A közös infrastruktúrába csak akkor emelnek fel egy működést, ha több független tulajdonosnak van szüksége ugyanarra a feltételezésmentes szerződésre. A fejlesztés gyorsulása így nem jelenti az ellenőrzés elhagyását: a tesztek, referenciák, teljesítménymérések és az emberi felülvizsgálat döntik el, mi kerülhet kiadásba.
NVIDIA Developer: AI Native by Design: Lessons Learned from Building NVIDIA TensorRT Model Connect