Az NVIDIA AI-ügynökökre szabott TensorRT-projekt tanulságait mutatja be
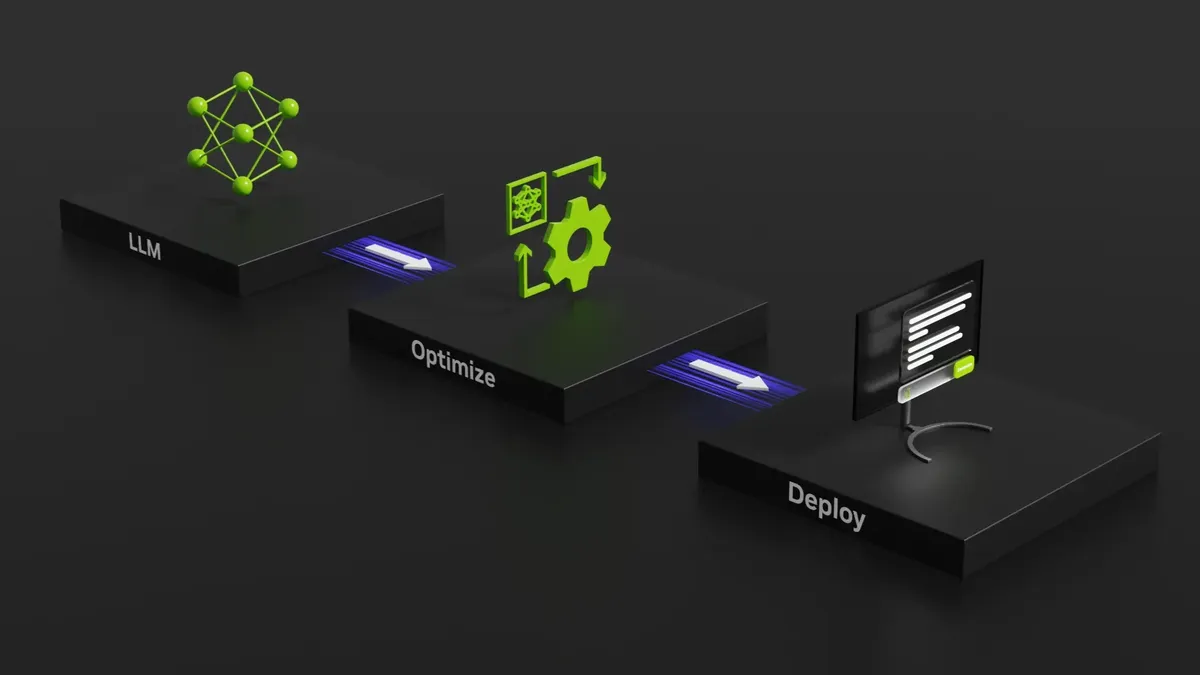
Az NVIDIA olyan fejlesztési módszereket ismertetett, amelyekkel a TensorRT Model Connect nyílt forráskódú projektet kezdettől fogva kódoló AI-ügynökökre építve alakították ki. A megközelítés középpontjában a párhuzamosítható feladatok, a modellcsaládok elkülönítése és a szigorúan ismételhető ellenőrzés áll.
- A TensorRT Model Connect nyílt forráskódú C++ referenciaimplementációkat kínál TensorRT-re építve.
- A projektet párhuzamosítható feladatokra és modellcsaládonként elkülönített fejlesztésre tervezték.
- A 2026. július 29-i kiadás 128, NVIDIA GB300 rendszeren tesztelt modellcsaládot fedett le.
- Az AI-ügynökök szabadon választhatják meg a megvalósítás útját, de szigorú ellenőrzési feltételeknek kell megfelelniük.
A TensorRT Model Connect célja
Az NVIDIA TensorRT Model Connect C++ nyelven készült, nyílt forráskódú referenciaimplementációk gyűjteménye, amely az NVIDIA TensorRT-re épül. A projekt gyakorlati kérdésből indult: elérhetővé tehető-e az NVIDIA következtetési veremének teljesítménye olyan modellfejlesztők számára is, akik nem TensorRT-szakértők?
Az NVIDIA csapata eredetileg kódoló AI-ügynökökkel végzett kísérletként tekintett a munkára. Néhány nap után azonban nagyobb kérdésre keresték a választ: hogyan nézne ki egy komoly szoftverprojekt, ha már a kezdetektől AI-ügynökökre terveznék, ahelyett hogy egy meglévő fejlesztési folyamatot gyorsítanának fel velük?
A TensorRT Model Connect a támogatott Hugging Face vagy helyi ellenőrzőpontokból verziózott .bundle fájlokat készítő referenciaimplementációkat kínál. Ezekhez feladatorientált natív C++ API-k kapcsolódnak szöveges, képi, hang-, diffúziós, szegmentációs, beágyazási és előrejelzési feladatokhoz.
Párhuzamos munka és elkülönített modellcsaládok
Az NVIDIA szerint az AI-ügynökök különösen akkor hasznosak, amikor a feladat sok, egymástól független munkafolyamatra bontható. A modellek hosszú farka ilyen feladatnak számít, mivel a modellcsaládok, konfigurációk, operátorok, futtatási útvonalak és ellenőrzési esetek gyakran egymástól függetlenül vizsgálhatók.
A projektben a modellcsaládok saját referenciaimplementációkat kapnak. A családhoz tartozik többek között a modellépítő, a futtatási folyamat, a segédkernel, a konfiguráció és az ellenőrzés bizonyítéka. Ez csökkenti annak kockázatát, hogy egy módosítás más, egymástól független részekben is hibát okozzon.
Az NVIDIA 2026. július 29-i nyilvános kiadási összehasonlítása szerint a projekt 128 modellcsaládot fedett le, amelyeket NVIDIA GB300 rendszeren teszteltek. A vállalat hangsúlyozza, hogy ez a szám önmagában nem méri az AI-ügynökök termelékenységét, azt viszont megmutatja, miért előnyös az önálló egységek hozzáadásával bővíthető architektúra.
A cél rugalmas, a bizonyíték szigorú
Az ügynökök általában egy elérendő eredményt kapnak, például egy modellcsalád támogatását, pontossági eltérés megszüntetését, teljesítményjavítást vagy egy műszaki szerződés megerősítését. A feladat mellett az elfogadáshoz szükséges bizonyítékokat is meghatározzák. Ezek között szerepelhet egy bevett referenciaimplementáció viselkedése, valamint a projekt saját tesztjei és korlátai.
Az NVIDIA nem írja elő minden esetben a teljes megvalósítási tervet. Az ügynök elkülönített feladatban kutathat, implementálhat, tesztelhet, hibázhat és javíthat. A megoldás útja rugalmas, az elfogadási feltételek azonban változatlanok maradnak.
A vállalat szerint az AI gyorsabbá teszi a lehetséges implementációk előállítását, de önmagában nem teszi olcsóbbá a helyesség bizonyítását. A tesztek, a referencia-összehasonlítások, a teljesítménymérések és az emberi felülvizsgálat döntik el, mi kerülhet kiadásra. Az emberi döntéshozatal így a rendszer megtervezésére, az elfogadási feltételek meghatározására és a kiadási döntésekért viselt felelősségre helyeződik át.
NVIDIA Developer: AI Native by Design: Lessons Learned from Building NVIDIA TensorRT Model Connect