Az Arize AI új módszerrel keresné az ügynökök rejtett hibáit
A produkcióban futó AI-ügynökök olyan hibákat is elkövethetnek, amelyekre a fejlesztők előre nem készítettek tesztet. Az Arize AI Signal nevű rendszere a futási nyomok elemzésével keresi a visszatérő problémákat, majd ezekből új tesztesetek és javítási javaslatok készülhetnek.
- A végső válasz pontszáma önmagában nem mutatja meg az ügynök teljes működését.
- A Signal produkciós nyomok között keres visszatérő és új hibamintázatokat.
- A rendszer rangsorolt vizsgálatokat készít bizonyítékokkal és következő lépésre vonatkozó javaslattal.
- A felismert hibákból regressziós adatkészlet és célzott értékelés készíthető.
- A példák kiválasztása, a mérési feltételek meghatározása és a kiadási döntés továbbra is emberi feladat.
A jó végső válasz is elfedheti a hibát
Az Arize AI szeptember 17-én közzétett írása szerint a hagyományos értékelések elsősorban azokat a kockázatokat mérik, amelyeket a fejlesztők már előre meg tudtak határozni. A produkciós ügynökök közben olyan problémákat is létrehozhatnak, amelyek nem szerepelnek az értékelési készletben.
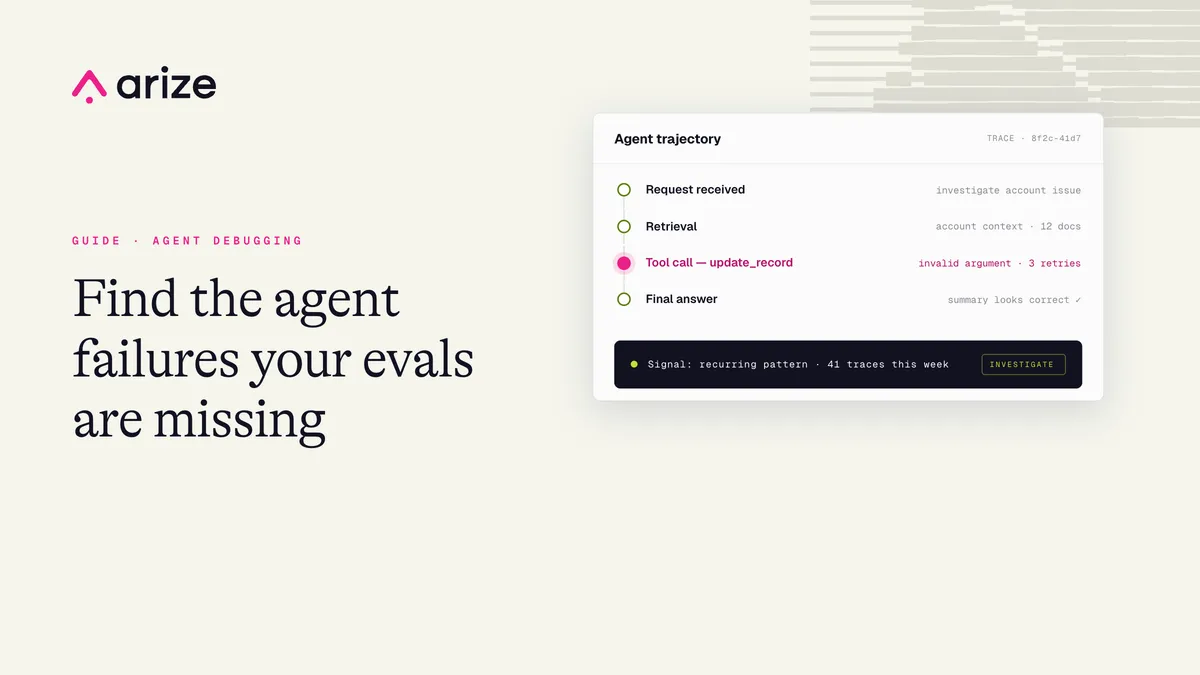
Ilyen lehet, ha egy eszköz hibás argumentumot kap, egy újrapróbálkozási ciklus többletköltséget okoz előrelépés nélkül, vagy az ügynök helyesnek tűnő végső választ ad annak ellenére, hogy a kért művelet valójában nem történt meg.
Az ügynök pályája, vagyis a trajectory, a kérés és a kontextus mellett a modellhívásokat, a keresést, az eszközhívásokat és azok válaszait, a hibákat, az újrapróbálkozásokat, az engedélykéréseket, az állapotváltozásokat, a létrehozott eredményeket és a végső választ is magában foglalja. Az Arize szerint a produkció megbízhatósága ezért nem ítélhető meg kizárólag az utolsó válasz alapján.
A Signal a futások között keres mintázatokat
Az Arize egy kontrollált benchmarkban hét modellt futtatott ugyanazon az ügynöki keretrendszeren, 19 GitHub-műveleti feladattal, modellenként tíz alkalommal. A helyességi eredmény 79,6 és 85,1 százalék között maradt, miközben a késleltetés, az eszközhívások száma, az újrapróbálkozások és az időtúllépés kockázata jóval nagyobb eltéréseket mutatott. A cég tanulsága szerint a végső válasz pontszáma hasonlónak mutathat rendszereket, miközben a működésük költsége és hibakitettsége jelentősen eltér.
A Signal az Arize AX része, és a vállalat leírása szerint folyamatosan működő AI-munkatársként vizsgálja a produkciós nyomokat. Ütemezetten ellenőrzi a futásokat, összekapcsolja a hasonló eseteket, nyilvántartja a korábban azonosított problémákat, majd rangsorolt vizsgálati jelentést készít.
A jelentés összefoglalót, valószínűsíthető kiváltó okot, hatást, bizonyítékokat és következő lépésre vonatkozó javaslatot tartalmazhat. Az Arize szerint a rendszer a releváns eszközhívásokat, kereséseket, hibákat, újrapróbálkozásokat és eredményeket is figyelembe veszi, így a mérnököknek nem egy véletlenszerű nyomból kell kiindulniuk.
A felfedezett hibából regressziós teszt lehet
Az Arize négy értékelési réteget különít el. A kódalapú értékelők az egyértelmű feltételeket, például a sémákat, a kötelező lépéseket és az állapotváltozásokat ellenőrzik. Az LLM-alapú bírák stabil szempontrendszerrel vizsgálhatják a megalapozottságot, a relevanciát vagy az utasítások követését. Az Agent-as-a-Judge összetett, több lépésből álló viselkedést elemezhet, míg a Signal a produkcióban ismétlődő és újonnan megjelenő mintázatokat keresi.
A Signal és az Agent-as-a-Judge az Arize AX szerint kiegészíti egymást. A Signal azt mutatja meg, mely mintázatok fontosak a produkciós futások nagyobb csoportjában, az Agent-as-a-Judge pedig összetett ítéletet alkalmazhat egy-egy futás nyomaira.
Amikor egy hiba ismertté válik, a csapat reprezentatív példákat adhat egy adatkészlethez, meghatározhatja az elvárt viselkedést, majd kódalapú értékelőt, LLM-bírót vagy Agent-as-a-Judge vizsgálatot rendelhet hozzá. A fejlesztők ezután a rögzített példákon összevetik az alapállapotot és a jelölt javítást, figyelve többek között a válaszokra, az eszközhasználatra, a keresésre, a késleltetésre, a költségre, a pályára és az értékelési eredményekre.
Az Arize ezeket az adatkészleteket „élő tesztfixturesként” írja le, amelyek a produkciós hibák újabb példáival bővülhetnek. A folyamatban azonban továbbra is szükség van mérnöki munkára: az emberek választják ki a példákat, határozzák meg az elvárt viselkedést, állítják be az értékeléseket, és döntenek arról, hogy egy módosítás kiadható-e.
Arize AI: How to find and debug agent failures your evals are missing