Az olcsóbb működéshez önmagában nem elég a promptok gyorsítótárazása
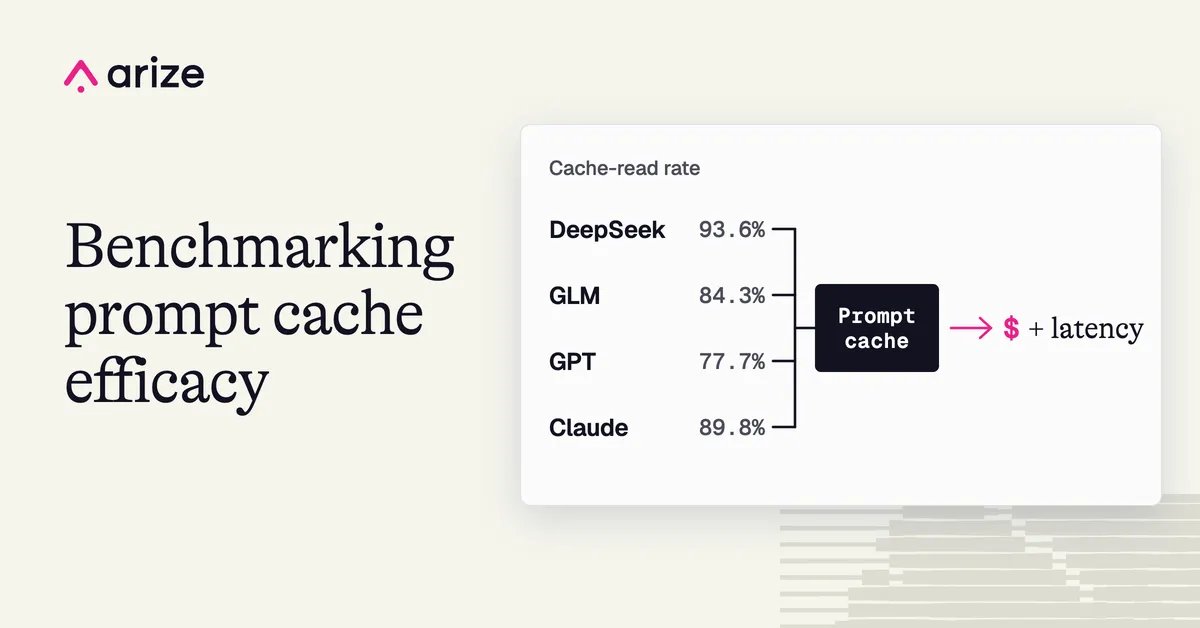
A promptok gyorsítótárazása csökkentheti az ismétlődő bemenetek feldolgozásának költségét, de az Arize AI tesztje szerint a magas cache újraolvasási arány önmagában nem garantál olcsóbb működést. A kiadásokban a kimeneti tokenek mennyisége és az alkalmazott árak is meghatározóak.
- A DeepSeek V4 Pro 0813 érte el a legmagasabb, 93,6 százalékos cache újraolvasási arányt.
- A DeepSeek 100 futásra számított Phoenix-becsült költsége 1,17 dollár volt.
- A Claude 89,8 százalékos cache arány mellett is a legdrágábbnak bizonyult, 14,63 dollárral.
- A hosszabb beszélgetések mind a négy modellnél magasabb cache újrahasznosítással jártak.
- A kimeneti tokenek mennyisége jelentősen befolyásolta a becsült költséget.
Négy modell, száz beszélgetés modellenként
Az Arize AI 2026. október 2-án közzétett benchmarkja egy többfordulós, Wonder Toys termékkatalógusára épülő vásárlási asszisztenst vizsgált. A kutatók 20 beszélgetést használtak, amelyek hossza 5 és 20 forduló között változott. Minden beszélgetést modellenként és szolgáltatói útvonalanként ötször futtattak le, így minden vizsgált útvonalhoz 100 beszélgetési nyom (trace) tartozott.
A feladat, a termékkatalógus, az utasítások, az adathalmaz és az értékelési szempontok változatlanok maradtak. A DeepSeek és a GLM az OpenRouteren keresztül futott, a GPT közvetlenül az OpenAI-n, a Claude pedig közvetlenül az Anthropic szolgáltatásán keresztül. Mindegyik útvonal az adott szolgáltató támogatott gyorsítótárazási mechanizmusát használta.
Az értékeket az Arize Phoenixben rögzített tokenadatok alapján számították ki. A költség a Phoenix becslése, amelyet nem vetettek össze a szolgáltatók tényleges számláival. Mivel a modell és a szolgáltatói útvonal egyszerre változott, az eredmények ezeknek a párosításoknak a viselkedését mutatják, és nem választják külön a modell, illetve a gyorsítótárazás hatását.
A DeepSeek vezetett a cache használatában és a becsült költségben
A legmagasabb cache újraolvasási arányt a DeepSeek V4 Pro 0813 érte el, 93,6 százalékkal. A Claude Opus 5.5 89,8 százalékot, a GLM 5.3 Prime 84,3 százalékot, a GPT-6.1 Sol pedig 77,7 százalékot produkált.
A DeepSeekhez tartozott a legalacsonyabb, 100 futásra számított Phoenix-becsült összköltség is, 1,17 dollárral. Az átlagos nyomkésleltetés szintén ennél az útvonalnál volt a legrövidebb, 34,7 másodperc. A GLM becsült költsége 4,49 dollár, átlagos késleltetése 91,4 másodperc lett. A GPT értékei 2,74 dollár és 55,6 másodperc, a Claude értékei pedig 14,63 dollár és 81,2 másodperc voltak.
Az Arize AI külön kiemelte, hogy ezekből az adatokból nem következik, hogy önmagában a gyorsítótárazás okozta volna a DeepSeek előnyét.
A hosszabb beszélgetések több bemenetet hasznosítottak újra
Mind a négy vizsgált modellnél nőtt a cache-ből beolvasott prompttokenek aránya a beszélgetések hosszával. A GPT esetében volt a legnagyobb változás: 5 fordulónál 34,2 százalékról 20 fordulónál 87,0 százalékra emelkedett az arány. A DeepSeek már 5 fordulónál 85,7 százalékon állt, 20 fordulónál pedig 95,6 százalékot ért el.
A GLM 70,0 százalékról 88,3 százalékra, a Claude 84,1 százalékról 91,7 százalékra nőtt az öt, illetve húszfordulós beszélgetések között. Ez azt jelenti, hogy rövid beszélgetéseknél az egyes modellek átlagos rangsora eltérhet a hosszú beszélgetésekben látott mintázattól.
A gyorsítótárazott bemenetek aránya azonban nem mondja el a teljes költségtörténetet. A Claude 89,8 százalékos cache arány mellett is a legdrágább volt, mert a becsült kiadás nagy részét a kimeneti tokenek adták. A GPT 157 314 kimeneti tokent generált, a GLM 725 047-et, ezért a GPT alacsonyabb cache arány mellett is olcsóbbnak bizonyult ebben a tesztben.
A Phoenixben a részletes tokenadatok is vizsgálhatók
Az Arize Phoenix a Harbor keretrendszerrel együtt a futásokat verziózott adathalmazokként és kísérletekként rögzítette. A kísérleti nézetben egymás mellett hasonlítható össze a cache használata, a becsült költség és a késleltetés. A nyomnézetben egy-egy többfordulós beszélgetés minden modellhívása külön LLM-sávként jelenik meg, a token- és költségadatokkal együtt.
Ez lehetővé teszi annak ellenőrzését, hogy egy hívás főként új bemenetet dolgozott fel, vagy korábban látott kontextust olvasott be a gyorsítótárból. Az Arize példája szerint egy Claude-hívás teljes tokenjeinek 60 százaléka cache-olvasásként jelent meg, miközben a becsült költség 81 százalékát a kimenet adta.
Az Arize AI szerint a saját munkafolyamatok vizsgálatakor érdemes rögzíteni a feladatot, az adathalmazt és az ismételt futásokat, majd együtt elemezni a cache arányát, a kimeneti tokenek számát, a költséget, a késleltetést és a feladat minőségét. A benchmark eredményei erre a munkafolyamatra és ezekre a modell, szolgáltatói útvonal párosításokra vonatkoznak.