Az Arize AX közvetlenül támogatja a Jev-as-a-Judge értékeléseket
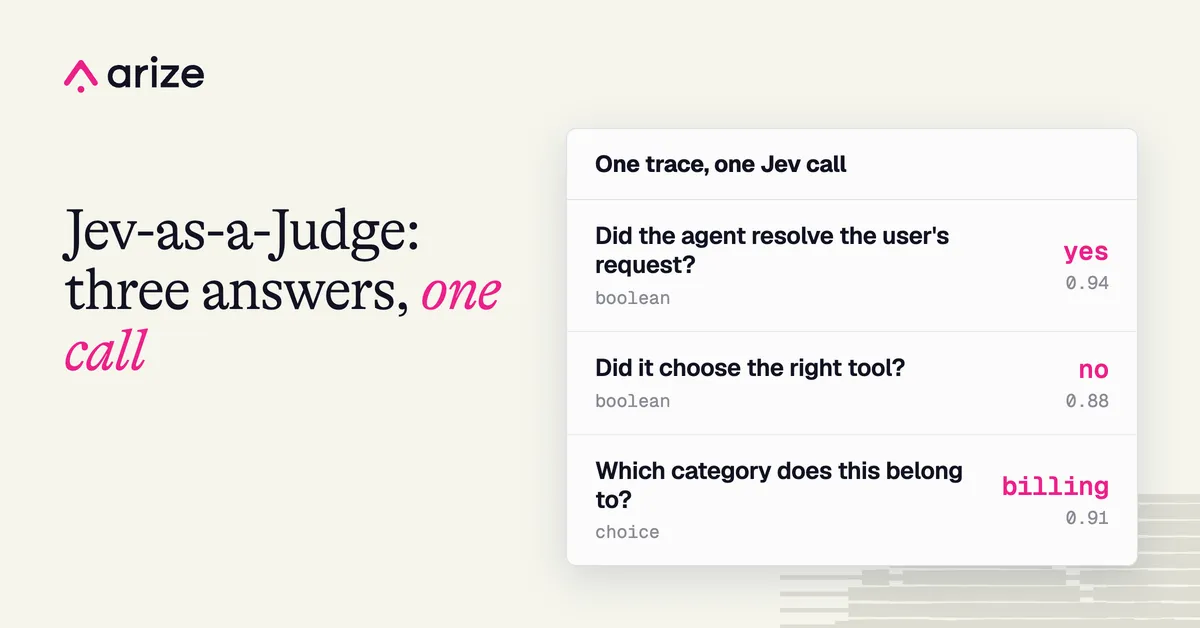
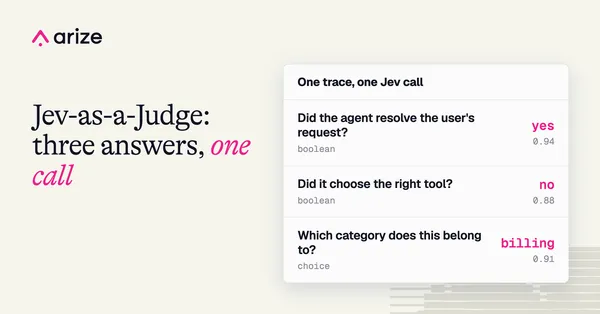
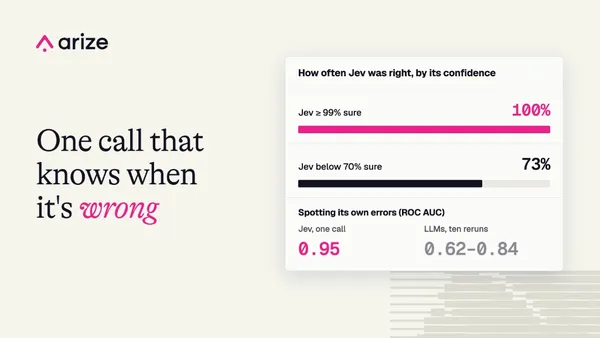
Az Arize AX natív integrációt kapott a TypeSafe AI Jev rendszerével, így a csapatok közvetlenül a platformon értékelhetik a gyártásból származó nyomkövetéseket. A Jev strukturált címkéket és megbízhatósági pontszámokat ad vissza eldöntendő, választásos és pontozásos kérdésekre.
- Az Arize AX natív Jev-as-a-Judge integrációt kapott.
- A Jev eldöntendő, választásos és pontozásos kérdésekre ad strukturált eredményeket.
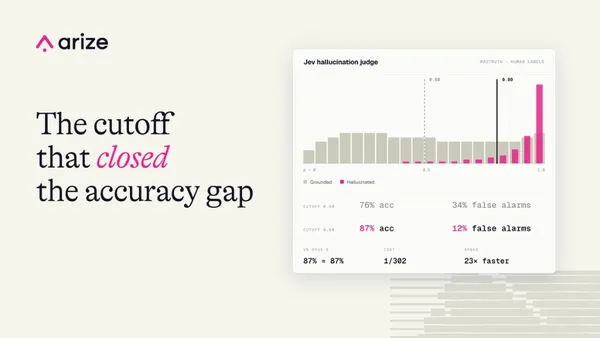
- Egy benchmarkban a hangolt Jev 87 százalékos pontosságot ért el a Claude Opus 5 mellett.
- A tesztben a Jev nagyjából 1/300 költséggel és 23-szor gyorsabban futott.
- A széles körű bevezetés előtt emberi címkékkel végzett kalibrálás szükséges.
Strukturált kérdésekre készült értékelő
Az Arize AI szeptember 28-i bejelentése szerint az Arize AX közvetlenül integrálódik a TypeSafe AI rendszerével. Az integráció a Jev-as-a-Judge értékeléseket natívan beépíti az Arize értékelési munkafolyamatába.
A Jev a TypeSafe AI System One döntési modellje, amelyet strukturált döntésekhez, nem pedig szöveggeneráláshoz terveztek. A nyomkövetésből származó közös állapot és egy vagy több típusos kérdés alapján egyetlen hívásban ad strukturált eredményeket.
A rendszerrel többek között az vizsgálható, hogy egy ügynök megoldotta-e a felhasználó kérését, a megfelelő eszközt választotta-e, megfelel-e a válasz egy meghatározott szabályzatnak, illetve melyik kategóriába tartozik az interakció.
A beállítás és a kalibrálás kulcsfontosságú
Az Arize szerint nem minden értékelési feladathoz van szükség általános célú, magyarázatot készítő nagy nyelvi modellre. A Jev olyan feladatokra használható, amelyeknél egyértelműek a kritériumok és rögzített a lehetséges kimenetek köre. A csapatok először reprezentatív példákon, emberi címkékkel vethetik össze a Jev döntéseit, majd ez alapján mérhetik fel, hogy a pontosság, a költség és a késleltetés megfelel-e az elvárásaiknak.
Az Arize egyik hallucinációészlelési benchmarkjában a küszöbértékkel hangolt Jev 87 százalékos pontossággal egyezett a Claude Opus 5 eredményével. Ugyanebben a tesztben a Jev nagyjából a költség 1/300-ad részéért futott, és 23-szor gyorsabb volt. A vállalat ugyanakkor kiemelte, hogy a küszöbérték hangolása meghatározó: a Jev alapértelmezett határértéke lényegesen gyengébben teljesített.
Ezért a széles körű használat előtt emberi címkékkel végzett kalibrálást javasolnak. Ha írásos magyarázatra van szükség, egy LLM-alapú bíró lehet megfelelőbb, míg egy ügynökbíró további kontextust gyűjthet vagy vizsgálatot végezhet a döntés előtt.
Közvetlenül az Arize AX-ben használható
Az Arize korábban távoli értékelőn keresztül is bemutatta a Jev használatát valós idejű védelmi szabályokhoz. A natív támogatás megszünteti az ehhez szükséges külön szolgáltatási réteget, és a munkafolyamatot közvetlenül az AX-be helyezi.
A használathoz a TypeSafe AI API-kulcsot a Settings, AI Providers, TypeSafe AI menüpontban kell megadni. Ezután új Jev-as-a-Judge értékelő hozható létre, megadható, hogy mely nyomkövetési adatokat vizsgálja, és milyen kérdésekre válaszoljon. A beállítás emberi címkékkel ellátott példákon tesztelhető, majd az értékelő online értékelési feladathoz kapcsolható a beérkező gyártási nyomkövetések vizsgálatához.
Az Arize szerint az alacsonyabb értékelési költség lehetővé teheti több gyártási forgalom elemzését. Így a csapatok több példát kaphatnak arról, hol hibáznak az ügynökök, és min érdemes javítani.