Az Arize szerint a Jev 300-szor olcsóbban érte el Claude Opus 5 pontosságát
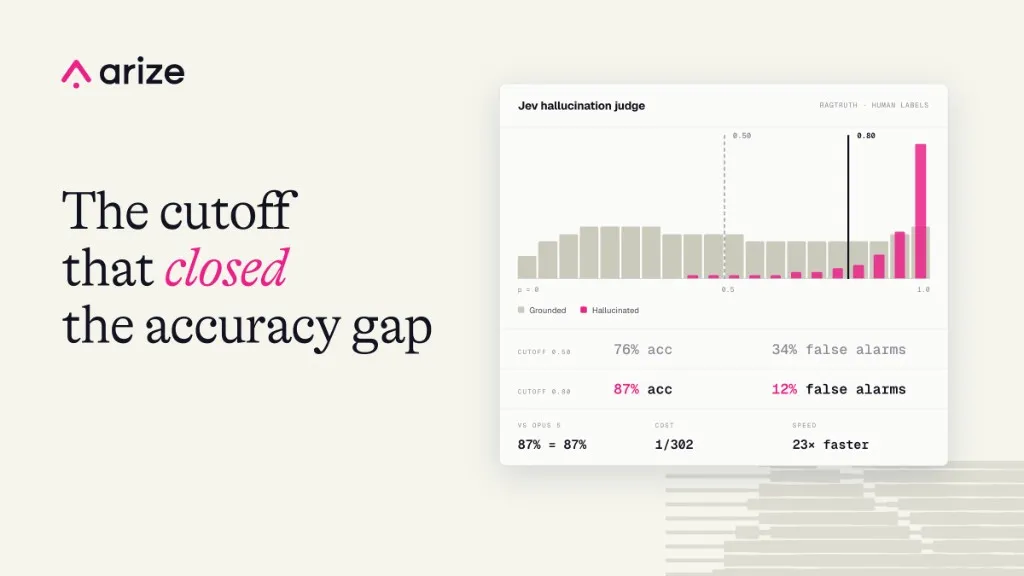
A Jev a Claude Opus 5-tel azonos, 87 százalékos pontosságot ért el az Arize hallucination detection tesztjén, miközben a vállalat szerint körülbelül 300-szor olcsóbb és 23-szor gyorsabb volt. Az eredményhez azonban megfelelő döntési küszöböt kellett beállítani.
- A Jev és a Claude Opus 5 egyaránt 87 százalékos pontosságot ért el hangolás után.
- A Jev ezer hallucinációs értékelése 0,05 dollárba került, az Opus 5-é 14,30 dollárba.
- A Jev körülbelül 141 milliszekundum alatt válaszolt, az Opus 5 több mint 3 másodperc alatt.
- A 0,5-ös alapértelmezett küszöb a Jevnél 76 százalékos pontosságot eredményezett.
- Az Arize külön validációs és tesztadat használatát javasolja a küszöb beállításához.
A küszöbérték döntően befolyásolta az eredményt
Az Arize szeptember 23-án közzétett elemzésében a TypeSafe által fejlesztett Jevet vetette össze a Claude Opus 5 és a GPT-5.6 Terra modelllel. A vizsgálat 23 325 értékelést tartalmazott, két, emberek által címkézett adathalmazon. A kutatás egyik feladata a RAGTruth adathalmazban szereplő válaszok hallucinációinak felismerése, a másik a SummEval hírszöveg-összefoglalóinak minősítése volt.
Az első futtatás félrevezető eredményt adott. Az alapértelmezett 0,5-ös küszöbnél a Jev 76 százalékos pontosságot ért el, míg a Claude Opus 5 83 százalékot. Az Arize szerint a probléma nem a Jev valószínűségi becsléseivel volt, hanem azzal, hogy a becslést hol fordították át végleges döntéssé.
A Jev egy állítás igazságának valószínűségét adja vissza, szöveges magyarázat nélkül. A tesztben a hallucinációsnak jelölt válaszok medián pontszáma 0,96 volt, ugyanakkor a tökéletesen megalapozott válaszok 34 százaléka is 0,5 fölötti értéket kapott. Ez a küszöb sok téves riasztást okozott.
A hangolt Jev elérte a Claude Opus 5 szintjét
Az Arize a küszöbértéket emberi címkékkel rendelkező validációs adaton hangolta, majd külön tesztadaton ellenőrizte. A Jev számára kiválasztott 0,80-as küszöb mellett a pontosság 87 százalék lett. Ugyanezt az eredményt érte el a Claude Opus 5 is, amelynél 0,65-ös küszöböt használtak.
A két modell hibaprofilja is azonos volt a beszámoló szerint: mindkettőnél 13 százalékos téves riasztási és 14 százalékos kihagyási arányt mértek. Az Arize hangsúlyozza, hogy az eredmények konfidenciaintervallumai átfedtek, ezért a teszt alapján a modellek teljesítménye megkülönböztethetetlennek tekinthető, nem pedig úgy, hogy a Jev bizonyítottan jobb lenne.
A ROC AUC mutató, amely azt méri, hogy a rendszer mennyire jól rendezi sorrendbe a hallucinált és a megalapozott válaszokat, szintén hasonló eredményt mutatott. A Jev értéke 0,94, a Claude Opus 5-é 0,95 volt.
Jelentős különbség a költségben és a sebességben
A hallucinációfelismerési feladatban a Jev ezer értékelésenként 0,05 dollárba került, szemben a Claude Opus 5 14,30 dolláros költségével. A válaszidő is eltért: a Jev körülbelül 141 milliszekundum alatt válaszolt, míg az Opus 5-nek több mint 3 másodpercre volt szüksége.
Az Arize szerint ez meghatározhatja, hogyan használható egy értékelő rendszer. A Jev sebessége lehetővé teheti, hogy minden választ közvetlenül a kérés feldolgozási útvonalán ellenőrizzenek, míg a lassabb modellt inkább mintavételes, utólagos vizsgálatokhoz használják.
A SummEval feladatban a Jev szakértői értékelésekhez mért rangkorrelációja 0,74 volt, a Claude Opus 5-é 0,70, a GPT-5.6 Terra értéke pedig szintén nagyjából emberi szintű teljesítményt mutatott. A Jev itt az Arize számítása szerint 216-szor olcsóbb volt.
Az Arize külön adaton javasolja a küszöb hangolását
Az elemzés gyakorlati ajánlása szerint a fejlesztőknek néhány száz, saját forgalomból származó példát kellene emberekkel címkéztetniük. Ezután a bíráló rendszer valószínűségi értékeit kell megőrizni, több küszöbértéket összevetni, és külön vizsgálni a téves riasztások, valamint a kihagyott hallucinációk arányát.
A küszöböt a validációs adaton kell kiválasztani, a teljesítményt pedig külön tesztadaton kell ellenőrizni. Az Arize szerint a beállítást újra kell hangolni, ha változik a feladat vagy a modell verziója. A bejegyzés fő tanulsága, hogy egy valószínűséget visszaadó bíró esetében a döntési küszöb önálló szabályozható tényező, amely a modell kiválasztásához hasonlóan erősen befolyásolja a végső pontosságot.
Arize AI: Jev vs. LLM-as-a-Judge: Accuracy and cost benchmarks