A Jev valószínűségei olyan hibákat is jeleznek, amelyeket az LLM-ek elrejtenek
A Jev címkénkénti valószínűségei megbízhatóan jelezték, mikor tévedett az értékelésben, miközben az ismételten futtatott nyelvi modellek sok hibás döntésnél változatlanok maradtak. Az Arize 36 190 döntésen vizsgálta a módszert.
- A Jev 36 190 döntésen adott valószínűséget a címkéihez.
- A hibás Jev-döntések medián valószínűsége 0,71 volt.
- A legalább 99 százalékos valószínűségű 3561 döntés mind helyesnek bizonyult.
- A Jev drop-in beállításban az esetek 0,97 százalékában változtatott címkét.
- A 0,5 bites küszöb a példák 11 százalékát jelölte emberi ellenőrzésre.
A Jev egyetlen futtatásból is bizonytalanságot mutat
Az Arize szeptember 28-án közzétett vizsgálata szerint a Jev természetes nyelvű bemenetet dolgoz fel, de szöveg generálása helyett minden címkéhez valószínűséget ad vissza. Ez azért fontos, mert a legtöbb nagy nyelvi modellre épülő értékelő, vagyis LLM-bíró, a gyakorlatban osztályozóként működik: a válaszokat előre meghatározott címkékhez kell igazítani.
A kutatásban öt LLM-et és a Jev két változatát futtatták a Phoenix tíz értékelőjéhez tartozó benchmarkokon, egyenként tízszer. A teszt összesen 36 190 döntést tartalmazott. A Phoenix minden beépített értékelőjéhez ember által címkézett adatsort tart fenn, ezekben együtt 517 példa szerepelt. A feladatok között volt a helyesség, a személyes adatok felismerése, a teljesség, az eszközhasználat, a visszakeresés relevanciája, a hallucináció, az elutasítás és a tömörség vizsgálata.
A Jev ritkábban változtatta meg a címkéit
A Jev drop-in beállításban az esetek 0,97 százalékában változtatta meg a címkét a tíz futtatás valamelyikén, natív API-használat mellett pedig 0,19 százalékban. Ez volt a legalacsonyabb arány a vizsgált bírók között. A Jev nem teljesen determinisztikus, a valószínűségei kissé elmozdulhatnak, de ezek a változások ritkán módosították a végső címkét.
A Jev átlagos pontossága mindkét beállításban 98,3 százalék volt, és az Arize szerint a feladatonkénti különbségek egyike sem bizonyult jelentősnek. A natív használat legnagyobb javulása a teljességet vizsgáló feladaton jelentkezett, 7,1 százalékponttal. Ez a feladat átlagosan mintegy 1950 token hosszúságú beszélgetéseket ellenőrzött.
A teljes mérés költsége 169,84 dollár volt, ebből a Jev részesedése 64 centet tett ki. Az összehasonlításban szereplő LLM-bírók címkéket adtak vissza, címkénkénti valószínűségeket viszont nem.
A valószínűség a hibás döntések kiszűrésében is segíthet
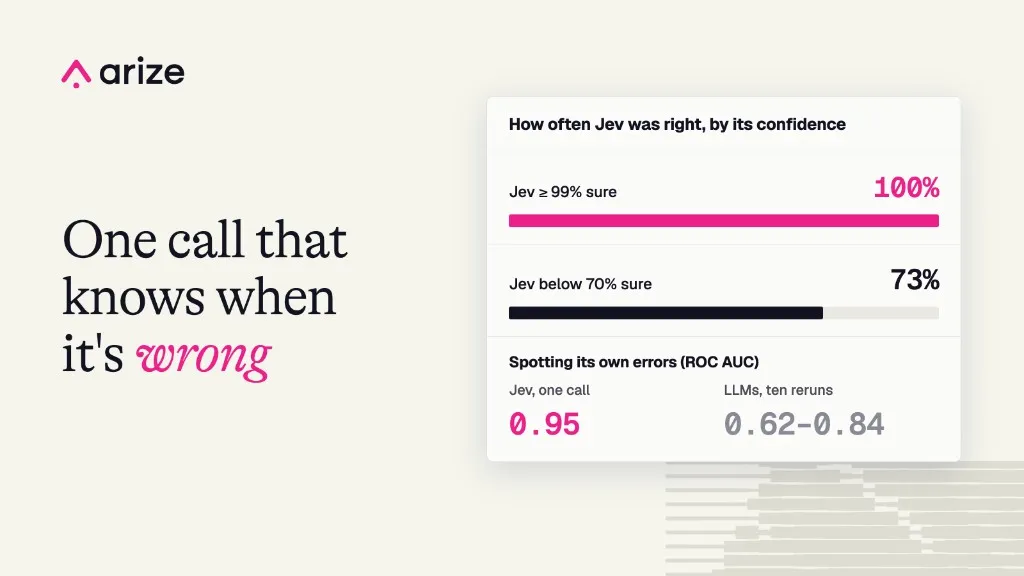
A drop-in Jev helyes döntéseinél a kiválasztott címke medián valószínűsége 1,00 volt, a hibás döntéseknél viszont 0,71. A legalább 99 százalékos valószínűséggel meghozott 3561 döntés mind helyesnek bizonyult. A 70 százalék alatti értékeknél a Jev az esetek 73 százalékában adott helyes választ.
A saját hibák felismerésére a Jev ROC AUC értéke drop-in módban 0,95, natív használat mellett 0,99 volt. Az LLM-ek ismételt válaszai alapján számított bizonytalanság értékei 0,62 és 0,84 közötti ROC AUC-t értek el. Az Arize szerint az LLM-ek hibáinak 27 és 75 százaléka ismételt futtatások során egyáltalán nem változott, így ez a módszer ezeket nem tudta volna jelezni.
A Jev entrópiája az emberi ellenőrzésre váró példák kijelölésében is hasznosnak bizonyult. A közel biztos Jev-döntések mellett az LLM-ek 3 százalékban ingadoztak, a majdnem pénzfeldobásnyi bizonytalanságú példáknál viszont 71 százalékban. Az Arize szerint egy 0,5 bites küszöb a példák 11 százalékát jelöli ki, ezeknél az LLM-ek csaknem kétharmadukban változtatták a válaszukat.
Arize AI: What Jev’s probabilities reveal that repeated LLM judgments miss