Jev-as-a-Judge értékelés érkezett az Arize AX platformra
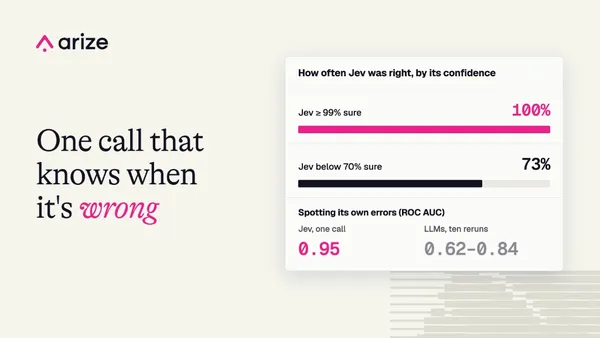
Az Arize AX közvetlenül integrálta a TypeSafe AI Jev döntési modelljét, így a csapatok natív módon értékelhetik a gyártási nyomokat. A Jev-as-a-Judge strukturált címkéket és megbízhatósági pontszámokat ad vissza.
- Az Arize AX natív TypeSafe AI-integrációt kapott.
- A Jev strukturált címkéket és megbízhatósági pontszámokat ad.
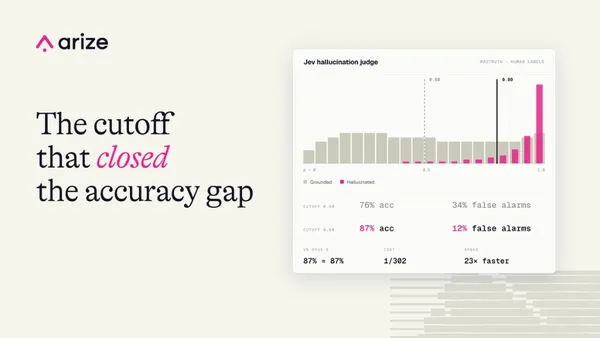
- A hangolt Jev 87 százalékos pontosságot ért el a tesztben.
- A Jev ugyanebben a tesztben nagyjából 1/300 költséggel és 23-szoros sebességgel működött.
- A bevezetés előtt emberi címkékkel végzett kalibrálást javasolnak.
Strukturált értékelés az Arize AX-ben
Az Arize AI 2026. szeptember 28-án jelentette be, hogy az Arize AX közvetlen TypeSafe AI-integrációt kapott. A kapcsolat natív Jev-as-a-Judge értékeléseket tesz lehetővé az Arize értékelési munkafolyamatában.
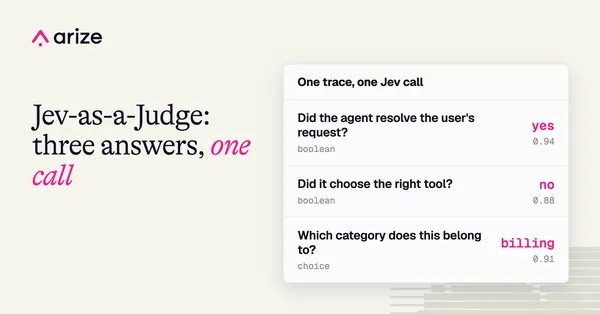
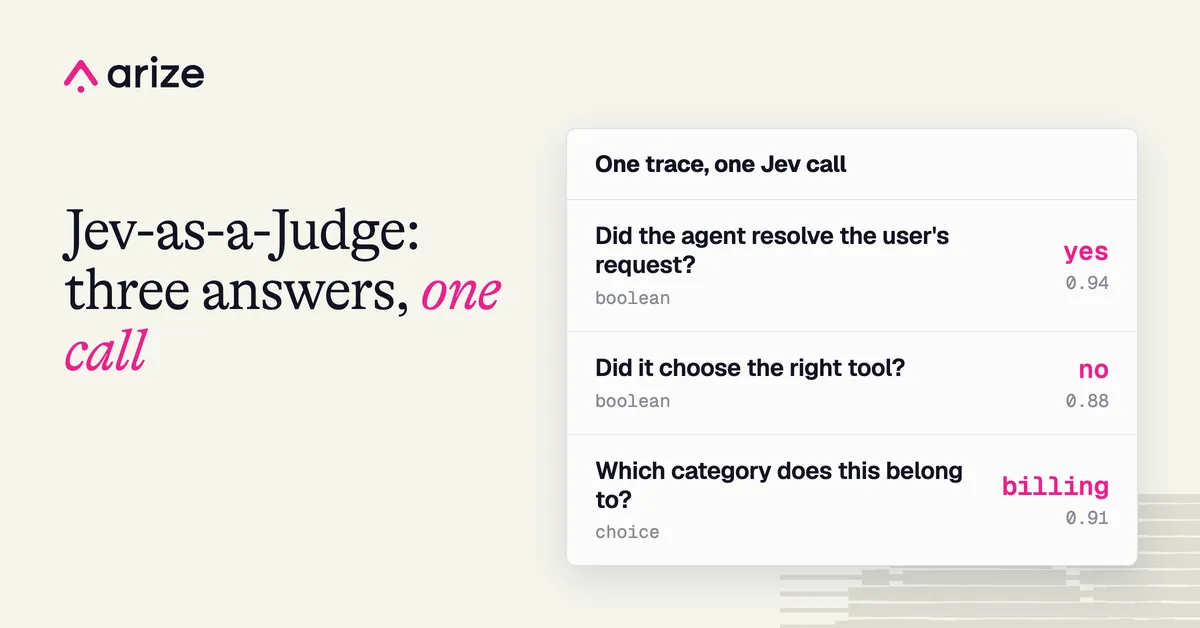
A Jev a TypeSafe AI System One döntési modellje, amelyet strukturált döntésekre, nem pedig szöveggenerálásra terveztek. A csapatok logikai, választásalapú és pontszámokon alapuló kérdésekkel vizsgálhatják a nyomokat. A rendszer strukturált címkéket és megbízhatósági pontszámokat ad vissza közvetlenül az Arize AX-ben.
Az értékeléshez a nyomból származó közös állapotot és egy vagy több, típusosan meghatározott kérdést kell megadni. A Jev ezután egyetlen hívásban ad strukturált eredményeket.
Milyen feladatokra szánják a Jevet?
Az Arize szerint számos gyártási értékelés jól körülhatárolt kérdésekre keresi a választ. Ilyen lehet például, hogy egy ügynök megoldotta-e a felhasználó kérését, a megfelelő eszközt választotta-e, megfelel-e a válasz egy rögzített szabályzatnak, vagy melyik kategóriába tartozik az interakció.
A Jev osztályozásra, pontozásra és útválasztásra készült. Az Arize azt javasolja, hogy a csapatok először egyértelmű kritériumokkal és rögzített lehetséges kimenetekkel rendelkező értékeléseken próbálják ki. A modell döntését reprezentatív példákon emberi címkékkel is össze lehet vetni, mielőtt a pontosság, a költség és a késleltetés alapján szélesebb körben alkalmaznák.
Az Arize szerint az LLM-alapú bírók akkor lehetnek hasznosak, ha írásos magyarázatra van szükség, egy ügynökbíró pedig további kontextust gyűjthet vagy vizsgálódhat a döntés előtt. Az olcsóbb értékelés több gyártási forgalom vizsgálatát teheti praktikussá, így több példa gyűlhet arról, hol hibáznak az ügynökök és min lehet javítani.
A tesztben a hangolás döntőnek bizonyult
Az Arize a Jevet hallucinációk felismerésén tesztelte, és pontosságát, költségét, valamint késleltetését LLM-alapú bírókkal hasonlította össze. Egy Arize-benchmarkban a küszöbértékre hangolt Jev 87 százalékos pontosságot ért el, ami megegyezett a Claude Opus 5 eredményével. Ugyanebben a tesztben a Jev nagyjából a költség egy háromszázadába került, és 23-szor gyorsabb volt.
A vállalat ugyanakkor kiemelte a küszöbérték hangolásának fontosságát. A Jev alapértelmezett határértéke lényegesen gyengébben teljesített. Ezért az értékelőket széles körű bevezetés előtt emberi címkékkel ellátott adatokon kell kalibrálni.
A natív támogatás megszünteti a korábban szükséges külön szolgáltatási réteget. A beállításhoz a TypeSafe AI API-kulcsot az Arize AX Settings, AI Providers, TypeSafe AI menüpontjában kell megadni, majd létre kell hozni egy Jev-as-a-Judge értékelőt. Ezután meghatározható, milyen nyomadatokat vizsgáljon és milyen kérdésekre válaszoljon, végül az értékelő online feladathoz kapcsolható a beérkező gyártási nyomok elemzéséhez.