Az MIT módszere érthetőbbé tenné az önvezető autók hibáit
Az MIT News 2026. szeptember 2-án számolt be a CW-Net nevű módszerről, amely az önvezető autók AI-rendszerének döntéseit érthető fogalmakká alakítja. A fejlesztést az MIT kutatói és a Motional autonómjármű-technológiai cég készítette, a kutatás a Nature-ben jelent meg.
- Az MIT és a Motional CW-Net néven fejlesztett módszert az önvezető autók döntéseinek magyarázatára.
- A rendszer érthető fogalmakkal írja le a tervezőmodell döntéseit, például álló jármű vagy kerékpáros közelsége alapján.
- A CW-Netet 130 millió önvezető autós jelenetet tartalmazó adathalmazon tanították.
- Privát pályateszten és Las Vegas-i helyzeteken alapuló szimulációban is javította a jármű viselkedésének előrejelzését.
- A kutatók szerint a módszer segítheti a biztonsági sofőröket és a mérnöki hibakeresést.
Érthető fogalmak a feketedoboz helyett
Az önvezető autókat gyakran mélytanulási modellek irányítják, amelyek váratlan helyzetekben hibázhatnak. Az MIT News példája szerint egy jármű akár megmagyarázhatatlanul fékezhet, és elállhatja egy érkező mentőjármű útját. Ilyenkor a biztonsági sofőrnek vagy az utasnak gyorsan kell reagálnia, hogy elkerülje az ütközést.
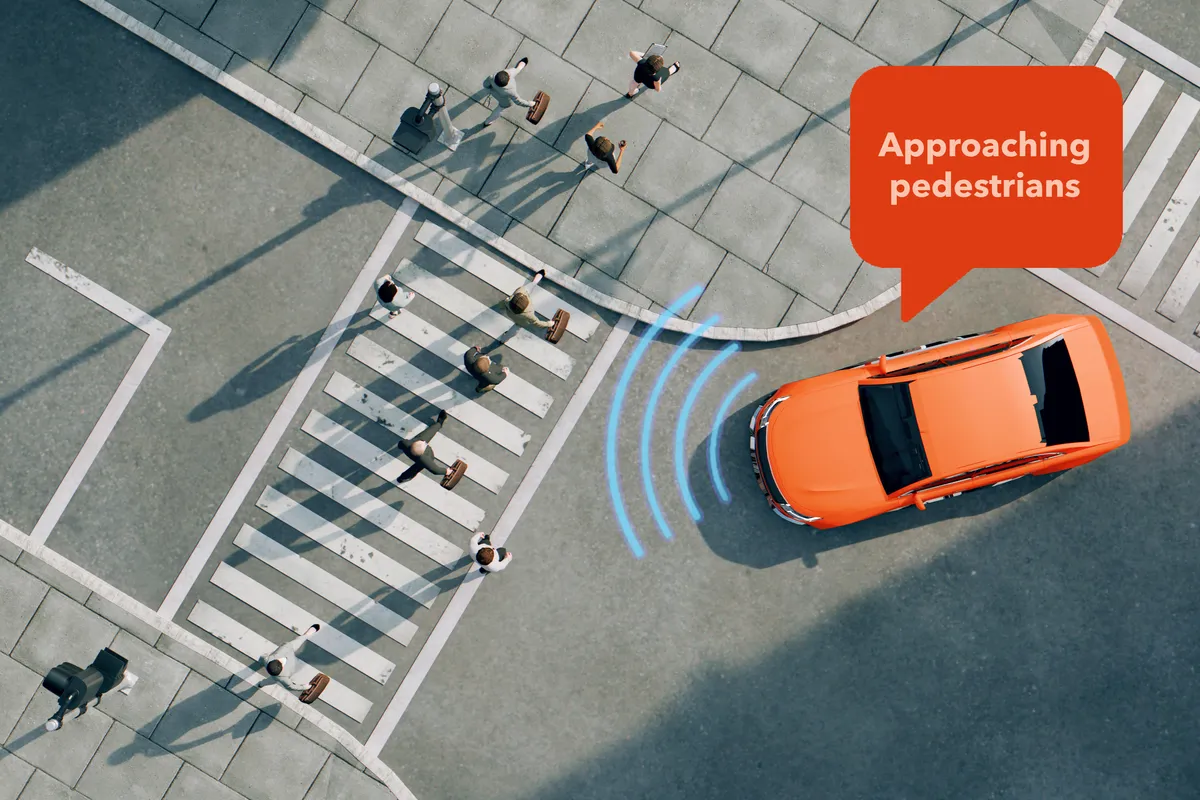
Erre a problémára dolgozta ki az MIT és a Motional a Concept-Wrapper Network, röviden CW-Net nevű módszert. A rendszer célja, hogy a járművet irányító gépi tanulási tervezőmodell döntéseit olyan fogalmakkal magyarázza, mint az álló jármű megközelítése vagy a kerékpároshoz közel. A forrás szerint a módszer úgy ad magyarázatot, hogy közben nem rontja a jármű vezetési teljesítményét.
A gépi tanulási alapú tervezők az önvezető autó agyaként működnek: feldolgozzák a kamerákból és lidar szenzorokból érkező adatokat, összefoglalják a jármű környezetét, eldöntik a következő lépést, majd pályát adnak a járműnek. Ezek a tervezők rendszerint feketedoboz-modellek, vagyis belső döntési folyamatuk annyira összetett, hogy nehezen érthető.
Hogyan működik a CW-Net
A CW-Net egy fogalomosztályozó AI-algoritmus, amelyet arra tanítottak, hogy felismerje a bemeneti adatokban megjelenő magas szintű fogalmakat. A kutatók a modult az autonóm jármű meglévő gépi tanulási tervezőarchitektúrájának közepébe illesztik. A modul a modell belső következtetési folyamatát érthető fogalmakká fordítja, majd arra kényszeríti a tervezőmodell utolsó részét, hogy ezeket a fogalmakat használja a jármű következő mozgásának meghatározásához.
Az MIT News szerint ez biztosítja, hogy a fogalmak hűen magyarázzák a jármű cselekvéseit. A CW-Net a besorolt fogalmakból valós időben készít magyarázatot, amelyet a jármű pályájával együtt ad ki.
Eoin Kenny, a tanulmány vezető szerzője, korábbi MIT-posztdoktor, jelenleg a J.P. Morgan Chase vezető AI-kutatója az MIT Newsnak úgy fogalmazott: „Ahelyett, hogy csak azon tűnődnénk, miért állt meg az autó, a valós idejű adatok visszajelzést adnak, amely lehetővé teszi a rendszer tesztelését bevetés közben. Ezeket az adatokat egy mérnöknek is oda lehet adni, hogy adott esetben javítsa a rendszert.”
A kutatók a CW-Netet 130 millió önvezető autós jelenetből álló adathalmazon tanították, amelyben minden jelenethez több címkézett fogalom tartozott. A forrás szerint a nagy, címkézett adathalmaz segít abban, hogy a rendszer sokféle környezetben pontosan azonosítsa a fogalmakat.
Pályateszten és szimulációban is javította az előrejelzést
A kutatók a CW-Netet egy valódi autonóm tesztjárművön, egy Motional robotaxin próbálták ki, privát tesztpályán, biztonsági sofőrrel. A teszt alapján a magyarázatok segítettek a sofőrnek pontosabban megjósolni, hogyan viselkedik a jármű meglepő helyzetekben.
Az MIT News egy konkrét példát is ismertetett: a jármű következetesen megállt, amikor kerékpároshoz közeledett, a biztonsági sofőr pedig azt feltételezte, hogy azért fékez, mert érzékeli a kerékpárost. A CW-Net magyarázatai viszont azt mutatták, hogy a modell nem volt megfelelően beállítva a kerékpáros észlelésére, és olyan pályát választott volna, amely ütközéshez vezet. A jármű azért állt meg, mert a vészfékezési eljárás aktiválódott, amikor túl közel került.
Az ilyen információ a forrás szerint segíthet a biztonsági sofőrnek abban, hogy hasonló helyzetekben korábban csökkentse a sebességet vagy kézi vezetési módba kapcsoljon. Mérnöki oldalon pedig támpontot adhat a modell javításához, hogy a jövőben elkerülhető legyen az adott hiba.
A kutatók nagyobb online szimulációs vizsgálatokat is végeztek, Las Vegas útjain rögzített valós vezetési helyzetekkel. Ezekben hasonló eredményeket láttak: a CW-Net magyarázatai jelentősen javították a résztvevők képességét arra, hogy előre jelezzék az autonóm jármű viselkedését.
Miért fontos ez a felhasználóknak és a fejlesztőknek
A kutatás jelentősége abban áll, hogy az önvezető rendszerek biztonsága nemcsak a helyes döntéseken múlik, hanem azon is, hogy az emberek mennyire tudják előre látni a jármű viselkedését. Julie Shah, az MIT aeronautika és asztronautika professzora, a CSAIL Interactive Robotics Group igazgatója és a tanulmány társszenior szerzője szerint a munka azt mutatja meg, hogyan támogathatják a magyarázatok az ember mentális modelljét és a rendszer viselkedésének megértését.
Shah az MIT Newsnak azt mondta: „Ha nem úgy építjük ezeket a technológiákat, hogy támaszkodni tudjunk rájuk és előre tudjuk jelezni a viselkedésüket, akkor ingatag és nem biztonságos alapot teremtünk a használatukhoz.”
A szerzők szerint a CW-Net visszajelzést adhat a mérnököknek az autóba épített AI-rendszerek hibakereséséhez. Hosszabb távon a technika az autonóm járművek biztonságát és átláthatóságát is növelheti, miközben segíthet megfelelő bizalmat kialakítani a sofőrökben és az utasokban.
A kutatók a jövőben kiterjesztenék a CW-Netet, hogy több fogalmat fedjen le, valamint különböző tanítási és tervezési technikákat vizsgálnának a teljesítmény és az értelmezhetőség javítására. Kenny szerint a tanulmány megmutatja, mennyire fontos lehet az értelmezhetőség a nagy kockázatú környezetekben, az önvezető autóknál és más biztonságkritikus rendszereknél.