Mooncake
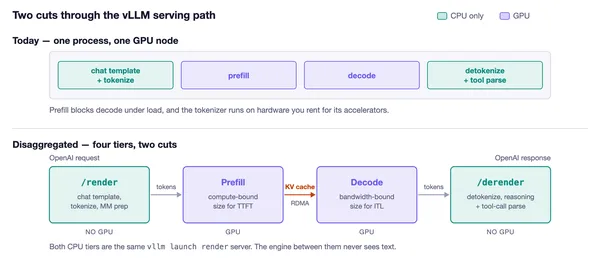
A vLLM különválasztaná a promptfeldolgozást és a tokenek generálását
A vLLM új útmutatója azt mutatja be, hogyan választható szét a nagy nyelvi modellek kiszolgálásában a promptok feldolgozása, a tokenek generálása és a CPU-s…
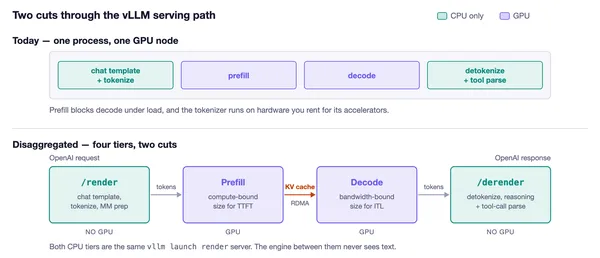
A vLLM négy részre bontaná az LLM-kiszolgálást
A vLLM új útmutatója a nagy nyelvi modellek kiszolgálásának szétválasztását mutatja be. A prefill és a decode külön példányokra helyezésével csökkenthető a hosszú…
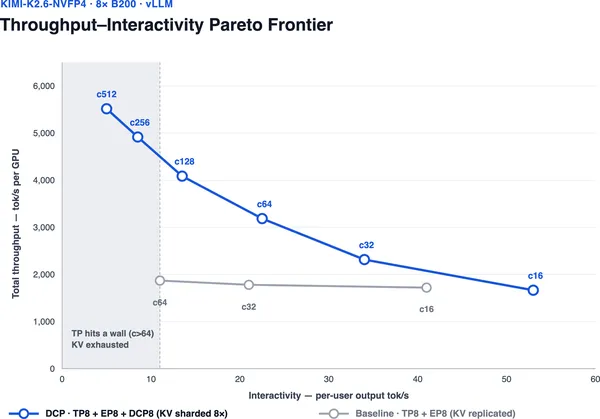
A vLLM új módszere több hosszú kontextusú AI-kérést szolgál ki
A vLLM Decode Context Parallelism technikája a hosszú kontextusú modellek KV-cache-ét a sorozat hossza mentén osztja szét a GPU-k között. A megoldás a vLLM mérése…