A vLLM új módszere több hosszú kontextusú AI-kérést szolgál ki
A vLLM Decode Context Parallelism technikája a hosszú kontextusú modellek KV-cache-ét a sorozat hossza mentén osztja szét a GPU-k között. A megoldás a vLLM mérése szerint jelentősen növelheti a párhuzamosan kiszolgálható kérések számát és a GPU-nkénti áteresztőképességet.
- A DCP a KV-cache-t a sorozat hossza mentén osztja szét a GPU-k között.
- A vLLM mérésében a DCP 512-es konkurenciánál 6091 token/másodperc/GPU teljesítményt ért el.
- A hagyományos TP 64-es konkurenciánál elérte a teljes memóriahasználatot.
- A módszer egy extra vLLM-paraméterrel kapcsolható be.
- A DCP különösen az MLA-modellek számára lehet hasznos.
A hosszú kontextus miatt fogy el a GPU-memória
A hosszú kontextusú inferencia egyre fontosabb az ügynöki AI-rendszerekben, amelyek nagy kódtárakat és hosszú beszélgetési előzményeket dolgozhatnak fel. Az ügynöki benchmarkok 64 ezertől akár 1 millió tokenig terjedő bemeneteket is használnak, ezekhez pedig nagyméretű KV-cache tartozik.
A hagyományos tenzorpárhuzamosításban (tensor parallelism, TP) a KV-cache a figyelmi fejek között oszlik meg. A csoportosított lekérdezési figyelmet használó modelleknél ez legfeljebb addig működik, amíg minden GPU-ra jut egy külön kulcs-érték fej. Ha a GPU-k száma ennél nagyobb, a cache egy része megkettőződik. A multi-head latent attention, vagyis MLA esetén a Key és Value egyetlen, minden lekérdezési fej által megosztott látens vektorba tömörül, ezért a cache a TP minden fokán teljes egészében megjelenhet.
Ez gyorsan feltölti a GPU-memóriát, korlátozza a párhuzamos kérések számát, és visszafogja az áteresztőképességet.
A DCP a tokenpozíciók között osztja fel a cache-t
A vLLM Decode Context Parallelism, röviden DCP, a KV-cache-t a kontextus, vagyis a sorozat dimenziója mentén darabolja fel. Egy 200 ezer tokenes kérésnél például négy GPU egyenként 50 ezer tokenhez tartozó cache-részt tárolhat. Így minden GPU csak a KV-cache egy részét őrzi és olvassa.
A módszer felszabadítja a memóriát, ami nagyobb kötegméretet és magasabb egyidejű kérdésszámot tesz lehetővé. A vLLM szerint nagy sávszélességű GPU-k közötti kapcsolat esetén ez segíthet megőrizni az interaktív válaszidőt akkor is, amikor sok hosszú kontextusú ügynök fut párhuzamosan.
A dekódolás folyamata egy lekérdezés-összegyűjtésből, a helyi cache-részen végzett számításból, majd az eredmények összegyűjtéséből és szétosztásából áll. MLA-modelleknél opcionálisan a lekérdezés kivetítése is replikálható betöltéskor, így a dekódolás közben elhagyható az ehhez szükséges összegyűjtés.
A vLLM méréseiben nagyobb terhelés mellett is skálázódott
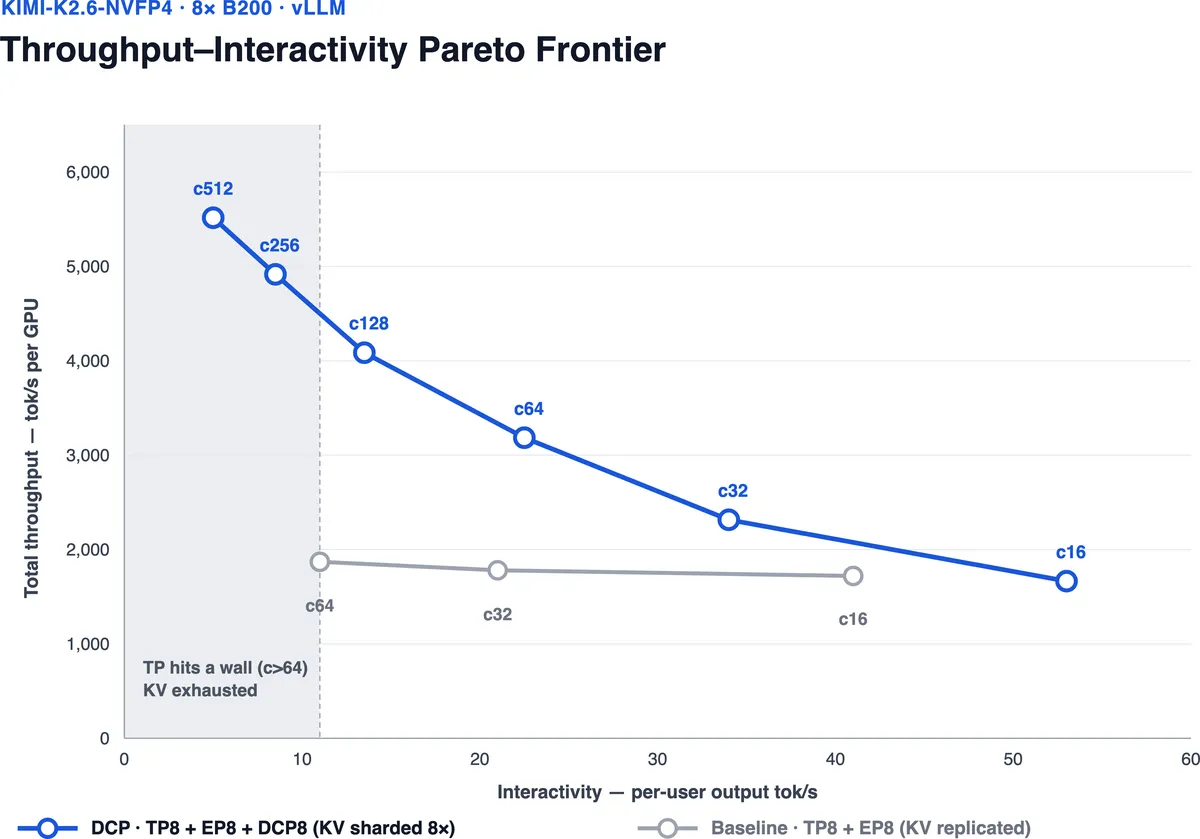
A vLLM egy azonos hardveren, modellen és munkaterhelésen végzett összehasonlítást. Egyetlen, 8 darab B200 GPU-t tartalmazó csomóponton Kimi K2.6 modellt futtattak NVFP4 formátumban, a párhuzamos kérések számát 16 és 512 között változtatva.
A hagyományos TP-beállításnál a memóriahasználat 64-es konkurenciánál elérte a 100 százalékot, az áteresztőképesség pedig körülbelül 1863 token/másodperc/GPU értéknél tetőzött. A DCP ezzel szemben 512-es konkurenciánál 6091 token/másodperc/GPU teljesítményt ért el, miközben a KV-cache használata 82 százalék maradt.
A vLLM hosszúság szerinti bontásában a DCP 200 ezer token feletti sorozatoknál is stabil teljesítményfrontot tartott. A rövidebb és hosszabb kategóriák görbéi közel fedték egymást, miközben a replikált cache-re épülő alapbeállítás ezeknél a méreteknél már nem tudott tovább skálázódni.
Egy extra beállítással engedélyezhető
A DCP a meglévő tensor-parallel beállítás mellett egyetlen további argumentummal kapcsolható be: decode_context_parallel_size. A vLLM offline használatnál és a vllm serve parancsnál is ezt a paramétert javasolja.
A dokumentált MLA-modellek között szerepel a DeepSeek-V2, a DeepSeek-V3, a DeepSeek-R1 és a Kimi K2.6. Ezeknél a tensor_parallel_size értékének legalább akkorának kell lennie, mint a decode_context_parallel_size értékének, továbbá a két számnak oszthatónak kell lennie egymással. A vLLM szerint az MLA különösen alkalmas a DCP-re, mivel a hagyományos TP nem tudja kisebb részekre bontani az egyetlen effektív KV-fejet.
A vLLM közlése szerint a DCP-t csaknem egy éve támogatja, a mostani bemutatás aktualitását pedig a hosszú kontextusú, ügynöki felhasználások terjedésével indokolja.