TypeSafe
A LanceDB szerint gyors és versenyképes a Jev újrarangsoroló
A LanceDB öt adathalmazon hasonlította össze a Jev újrarangsorolót 19 konfigurációval. A vállalat szerint a Jev gyors és versenyképes, miközben a találatok relevanciáját…
A LanceDB szerint a Jev gyors és versenyképes reranker
A LanceDB öt adathalmazon és 19, előre elkészített reranker-konfigurációval vetette össze a TypeSafe Jev modelljét. A vállalat szerint a Jev gyors és versenyképes…
A Jev gépi döntéseket ad az alkalmazások kezébe szöveg nélkül
A TypeSafe Jev nevű AI-modellje osztályozási, pontozási és útválasztási feladatokra készült. A rendszer szöveges válasz helyett közvetlenül felhasználható, típusos…
A Pydantic AI már Jevvel is osztályozza az ügynökök döntéseit
A Pydantic AI 2.50.0 támogatja a TypeSafe Jev döntési modelljét, amely szöveges válaszok generálása helyett előre meghatározott kérdésekre ad típusos válaszokat. A…
A Pydantic AI már Jevvel is megmutatja, hogyan döntött az ügynök
A Pydantic AI 2.50.0 támogatja a TypeSafe Jev döntési modelljét, amely szövegből strukturált válaszokat választ ki generált szöveg nélkül. A Pydantic Logfire új nézete…
Döntési modelleket támogat az Ollama, három modell már elérhető
Az Ollama 0.35-ös verziójától Jev API-alapú döntési modellek futtathatók helyben, az új /v1/systemone végponton keresztül. A vállalat szerint a megoldás gyors döntéseket…
Az Ollama helyben futó döntési modelleket támogat
Az Ollama 0.35 verziója támogatja a TypeSafe Jev API-jára épülő döntési modelleket, amelyek egyetlen kérésben több, névvel ellátott kérdésre válaszolnak. A funkcióhoz…
A Pydantic AI Gatewayen is elérhető a TypeSafe Jev modellje
A TypeSafe osztályozómodellje, a Jev mostantól a Pydantic AI Gatewayen keresztül is hívható. A fejlesztők egyetlen Gateway-kulccsal használhatják, miközben a Jev kérései…
KutatásAz MLflow tesztjén a Jev gyors volt, de hibákat is átengedett
A Jev strukturált döntési modell az MLflow új tesztjén 72 válaszból 64 esetben egyezett az emberi címkézéssel. A modell gyorsabb és olcsóbb volt a GPT-OSS-120B-nél, de…
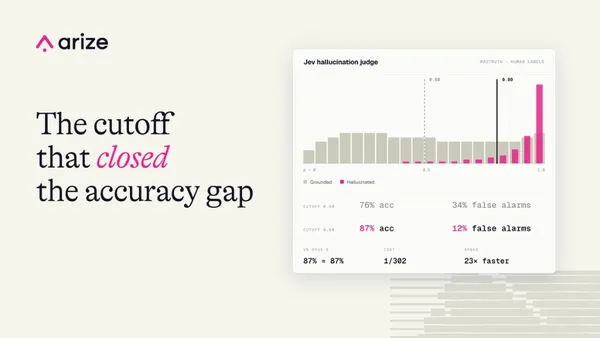
Az Arize szerint a Jev 300-szor olcsóbban érte el Claude Opus 5 pontosságát
A Jev a Claude Opus 5-tel azonos, 87 százalékos pontosságot ért el az Arize hallucination detection tesztjén, miközben a vállalat szerint körülbelül 300-szor olcsóbb és…
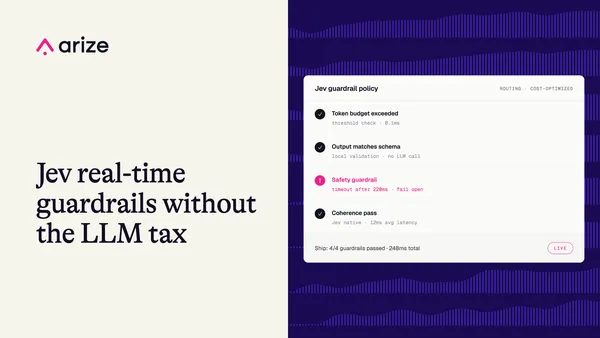
A Jev gyorsabban szűri ki az LLM-ek veszélyes döntéseit
Az Arize AI összehasonlította a TypeSafe Jev döntési modelljét és az OpenAI GPT-5.4 nano modelljét egy autókereskedői chatbot védelmében. A Jev a bemutatóban 15-18-szor…
Olcsóbb tömeges AI-értékelést kínál a Jev és a Pydantic Evals
A TypeSafe Jev strukturált döntéseket és valószínűségeket ad vissza, így a Pydantic Evals segítségével nagy mennyiségű AI-válasz értékelhető magyarázat generálása…
A Jev gyorsabb és olcsóbb, de kevésbé pontos a Claude Opus 5-nél
A Jev 1.13 a Banking77 szándékfelismerési tesztjén 81,0 százalékos pontosságot ért el, a Claude Opus 5 pedig 84,4 százalékot. Az OpenRouter mérése szerint a Jev medián…
KutatásA Jev kiválthatja az LLM-es bírákat? Az MLflow tesztelte
A TypeSafe Jev modellje 30 MLflow-val kapcsolatos kérdés mindegyikén egyezett az emberi értékeléssel, miközben a tesztben ez volt a leggyorsabb és legolcsóbb bíró. A…
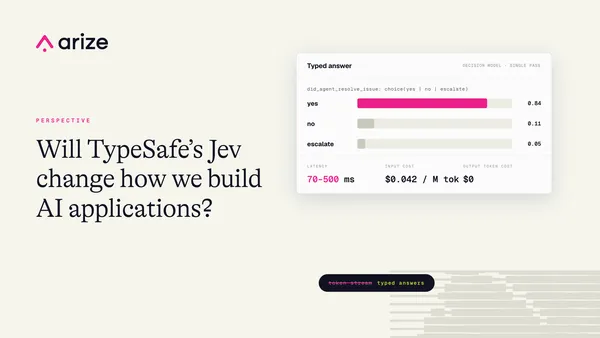
A TypeSafe Jev döntéseket hoz, de egyetlen mondatot sem ír
A TypeSafe Jev olyan modell, amely osztályoz, pontoz és útvonalat választ, de nem generál szabad szöveget. A cég mérései szerint bizonyos feladatokon akár 200-szor…