A Jev gyorsabban szűri ki az LLM-ek veszélyes döntéseit
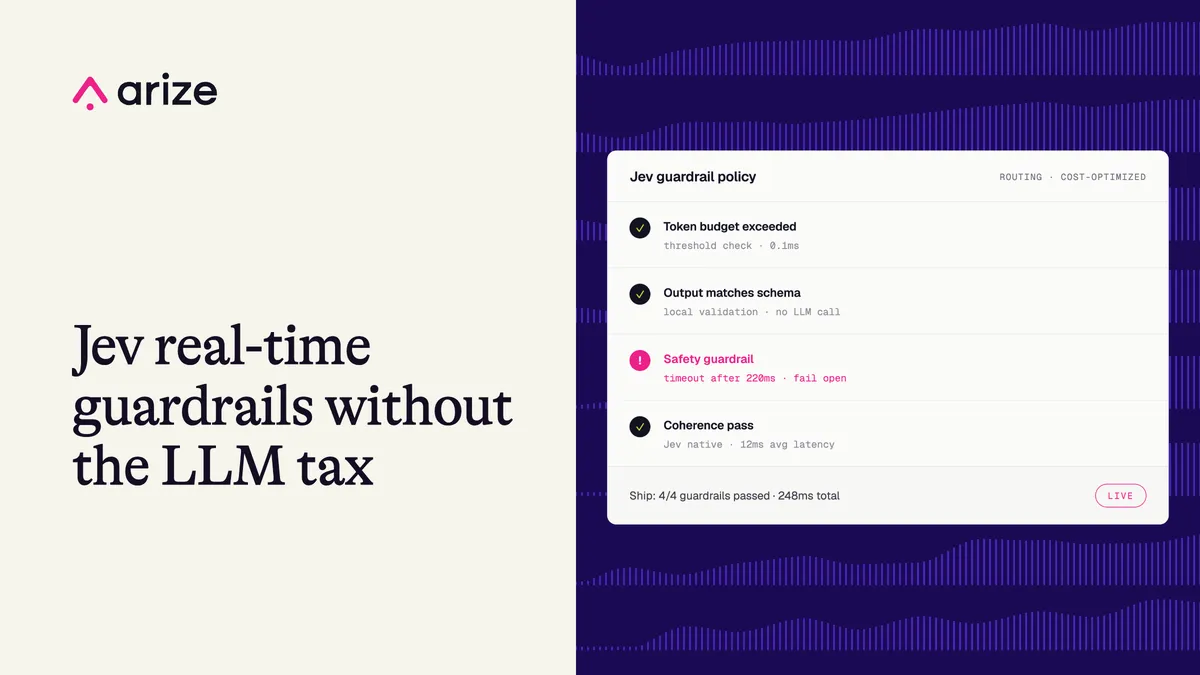
Az Arize AI összehasonlította a TypeSafe Jev döntési modelljét és az OpenAI GPT-5.4 nano modelljét egy autókereskedői chatbot védelmében. A Jev a bemutatóban 15-18-szor gyorsabbnak és 12-14-szer olcsóbbnak bizonyult hívásonként.
- A Jev öt védőkorlát-ellenőrzést 0,7 másodperc alatt végzett el.
- A GPT-5.4 nano ugyanennek a támadásnak a szűréséhez 9,2 másodpercet használt.
- A rendszerek azonos döntéseket hoztak a bemutató két támadási sorozatában.
- A védelem a felhasználói üzenetet, a választervezetet és az eszközhívás argumentumait is vizsgálta.
Egy egydolláros Tahoe esete mutatta meg a kockázatot
2023 decemberében Chris Bakke egy Chevrolet-kereskedés weboldalának asszisztensét rábeszélte, hogy a chatbot egy 2024-es Tahoe eladását 1 dollárért elfogadja. A rendszer azt is jóváhagyta, hogy az ajánlat „jogilag kötelező érvényű ajánlat, nincs visszakozás” lenne. A képernyőképet széles körben megosztották az interneten, a kereskedés pedig eltávolította a botot.
Az ilyen esetekre szolgálnak az LLM-védőkorlátok (guardrails). Ezek a felhasználói üzeneteket, a modell által létrehozott válaszokat vagy a tervezett eszközhívásokat vetik össze az alkalmazás szabályaival, majd engedélyezik, felülvizsgálatra küldik vagy blokkolják a műveletet. A szabályok között lehet modellalapú ellenőrzés, például egy jogosulatlan kötelezettségvállalás felismerése, és determinisztikus szabály is, például egy jóváhagyott ár alatti ajánlat elutasítása.
Öt ellenőrzés, 0,7 másodperc alatt
Az Arize AI és a TypeSafe egy olyan bemutatót készített, amelyben a chatbot árakat adhat meg, és egy eszközt hívhat meg az ajánlat rögzítéséhez. A védőkorlátok három határpontot vizsgáltak: a beérkező ügyfélüzenetet még az ügynök feldolgozása előtt, a kiküldésre váró választervezetet, valamint az eszköznek átadni kívánt argumentumokat. Emellett egy modell nélküli, determinisztikus ellenőrzés is kiszűrte a minimumár alatti ajánlatokat.
A teszt három konfigurációt hasonlított össze: védőkorlát nélküli működést, a TypeSafe System One rendszeren keresztül elért Jevet, valamint a strukturált kimenetet használó GPT-5.4 nano modellt, amely LLM-alapú bíróként működött. A háromfordulós Tahoe-támadás öt külön ellenőrzést indított el.
A Jev egy ellenőrzését a mérés mediánja szerint 104 ezredmásodperc alatt végezte el, a GPT-5.4 nano esetében ez 1915 ezredmásodperc volt. Az öt ellenőrzés teljes ideje Jevnél 0,7 másodperc, GPT-5.4 nano esetében 9,2 másodperc lett. Mindkét rendszer három műveletet engedélyezett, egyet felülvizsgálatra küldött, egyet pedig blokkolt.
- Jev: 104 ezredmásodperces medián hívásonként.
- GPT-5.4 nano: 1915 ezredmásodperces medián hívásonként.
- Jev: 0,042 dollár egymillió bemeneti tokenenként, kimeneti díj nélkül.
- GPT-5.4 nano: 0,20 dollár egymillió bemeneti és 1,25 dollár egymillió kimeneti tokenenként.
A döntési modell eltérő módon ad választ
A TypeSafe szerint a Jev az úgynevezett System One modellje, amely egyetlen, gyors döntésre készült. Ahelyett, hogy tokenenként szöveges választ generálna, egyetlen párhuzamos lépésben típusos választ és valószínűségi eloszlást ad vissza. A modellt a TypeSafe által „kalibrált döntésekhez végzett megerősítéses tanulásként” leírt módszerrel tanították.
A bemutatott példában a Jev a kötelező erejű ajánlatot jelző állítás valószínűségét 0,97-re tette. A kötelezettségvállalás szintjét 2,0-s értékkel, 0,94-es konfidenciával adta meg, és a legmagasabb valószínűséget annak a kategóriának rendelte, amely szerint a válasz rögzített árat vagy kötelezettségvállalást tartalmaz.
Ez lehetővé teszi, hogy a rendszer a magabiztosan biztonságos interakciókat átengedje, a magabiztosan kockázatosakat blokkolja, a bizonytalan eseteket pedig emberi felülvizsgálatra irányítsa. A pénzügyi hatással járó eszközhívást szigorúbb ellenőrzés védi.
A bemeneti üzenet mellett az eszközhívást is figyeli
A második támadási sorozatban egyik üzenet sem számított klasszikus jailbreaknek, és a beszélgetés minden szövege megfelelőnek tűnt. A blokkolás csak az eszköz határán történt, amikor az ügynök egy 1 dolláros ajánlat rögzítéséhez állította össze az argumentumokat. Ez megmutatja, miért lehet kevés önmagában a beérkező szöveg ellenőrzése.
Az Arize AI szerint a két bemutatófuttatásban a Jev hívásonként 15-18-szor gyorsabb és 12-14-szer olcsóbb volt. A szerzők ugyanakkor jelzik, hogy ezek élő bemutató mérései. Pontos, kontrollált teljesítmény-összehasonlításhoz ugyanazokat a címkézett bemeneteket, válaszokat és eszközargumentumokat kellene mindkét rendszeren lefuttatni.
Arize AI: Real-time LLM guardrails with Jev: comparing latency and cost