A TypeSafe Jev döntéseket hoz, de egyetlen mondatot sem ír
A TypeSafe Jev olyan modell, amely osztályoz, pontoz és útvonalat választ, de nem generál szabad szöveget. A cég mérései szerint bizonyos feladatokon akár 200-szor gyorsabb és 400-szor olcsóbb lehet az LLM-eknél.
- A TypeSafe Jev strukturált döntéseket hoz szöveggenerálás nélkül.
- A TypeSafe mérései szerint a modell akár 200-szor gyorsabb és 400-szor olcsóbb lehet.
- A Jev valószínűségi értékeket ad, amelyek bizonytalan esetek emberhez irányítására használhatók.
- A modell legfontosabb korlátja, hogy nem magyarázza meg a döntéseit.
- A korai független tesztek biztatók, de kis mintákon készültek.
Strukturált válaszok, szöveggenerálás nélkül
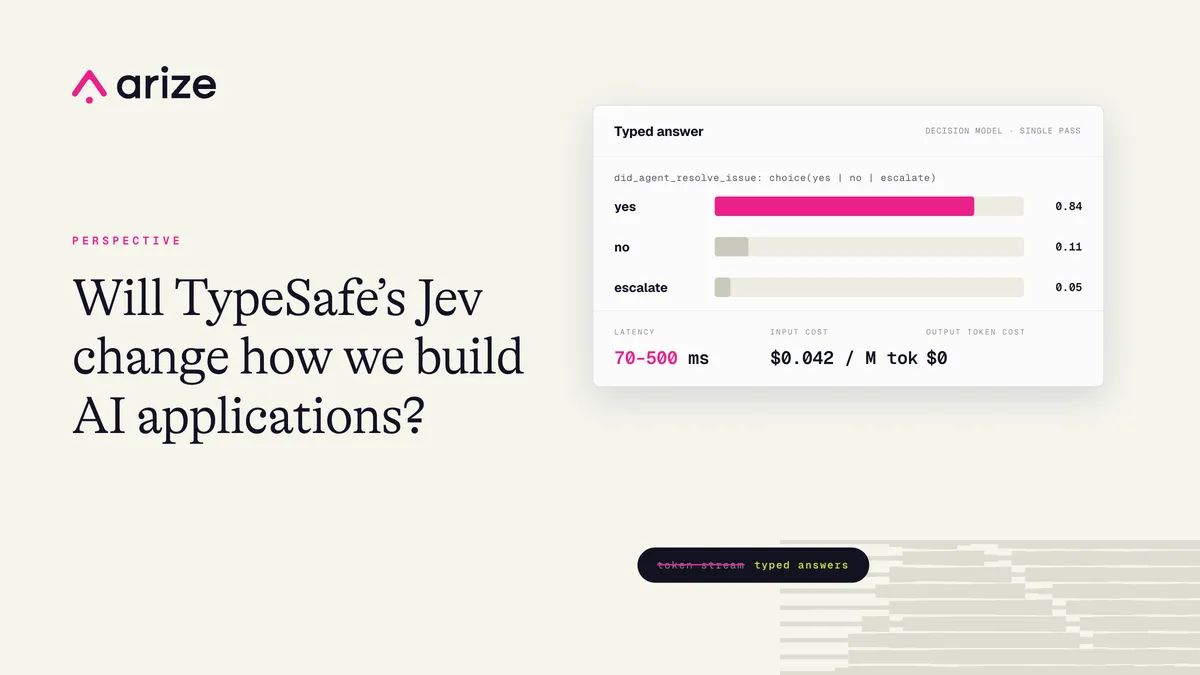
A TypeSafe első System One modelljeként bemutatott Jev strukturált döntési feladatokra készült. Bemeneti adatokat és típusosan megadott kérdéseket kap, majd szabad szöveg helyett válaszokat és azok valószínűségi értékeit adja vissza. A modell nem tokenfolyamot generál, a válaszokat egyetlen párhuzamos lépésben közli.
A TypeSafe szerint a Jev válaszideje 70 és 500 milliszekundum között alakulhat, a használat díja pedig 0,042 dollár egymillió bemeneti tokenenként. A vállalat Reinforcement Learning for Calibrated Decisions, vagyis kalibrált döntésekhez használt megerősítéses tanulás módszerrel, röviden RLCD-vel képezte a modellt. Ennek célja, hogy a magasabb valószínűségi érték valóban nagyobb helyességi esélyt jelentsen.
A TypeSafe azt állítja, hogy a Jev nem tud hallucinálni, az Arize AI elemzése szerint ez a kijelentés túlzó. A modell valóban nem adhat a megadott sémán kívüli választ, de a sémán belül hibás döntést hozhat. A valószínűségi érték ilyenkor a bizonytalanság jelzésére szolgálhat.
A korai mérések szerint jelentős lehet a költségelőny
A TypeSafe négy döntési munkafolyamaton végzett tesztjeiben a Jev átlagosan 68 százalékos pontosságot ért el, egy eset költsége 0,0004 dollár, az átlagos késleltetés pedig 0,4 másodperc volt. A GPT-5.6 Terra ugyanezekben a mérésekben 68 százalékos pontosságot, 0,03 dolláros esetenkénti költséget és 10 másodperces válaszidőt mutatott. Az Opus 5 pontossága 73 százalék, költsége 0,18 dollár, válaszideje 38 másodperc volt.
Az Arize AI kiemeli, hogy ezek a tesztek nem emberi címkékkel létrehozott igazságértékekhez hasonlították a válaszokat, hanem más modellek referenciavalószínűségeihez. A vállalat ezért saját összehasonlító méréseket is tervez.
A korai, független adatok hasonló irányt mutatnak. Az Every munkatársa 777 értékelést futtatott le 0,7 másodpercnél rövidebb idő alatt, nagyjából negyedcentes költséggel. A NearHere egy brit eseményoldal listáinak moderálásakor a Jevnél 96 százalékos eredményt mért, szemben a Gemini Flash-Lite 86 százalékával, döntésenként 58-szor alacsonyabb költség mellett. Egy fejlesztő 18 514 kéretlen e-mailen tesztelte a modellt, és a Jev eredménye statisztikai döntetlen lett egy címkéken tanított osztályozóéval.
A rugalmasságért magyarázat nélkül kell fizetni
Az LLM-eket azért használják gyakran bíróként, mert külön feladatspecifikus, nagy méretű tanítóadatbázis nélkül is képesek döntési kritériumokat követni. A hagyományos logisztikus regresszió és a finomhangolt kódolók ezzel szemben címkézett adathalmazt és tanítási folyamatot igényelnek.
A Jev ugyanazokat az egyszerű nyelvű kritériumokat fogadja el, amelyeket egy LLM-bíró utasításában is meg lehet adni. Az Arize AI szerint ez lehetővé teszi, hogy a nulla példás osztályozás és az autoregresszív szöveggenerálás elváljon egymástól. A kéretlen leveleken végzett egyik tesztben a Jev 98,3 százalékos pontosságot ért el feladatspecifikus finomhangolás nélkül. A tesztelő az értékelési feltételeket 1000 címkézett e-mail hibáinak áttekintése után pontosította. A körülbelül 14 800 címkézett e-mailen tanított TF-IDF logisztikus regresszió 98,4 százalékot ért el, a két módszer közötti különbség statisztikailag nem volt jelentős.
A fő kompromisszum a magyarázat hiánya. A TypeSafe dokumentációja szerint a System One modellek nem indokolják meg a döntéseiket. A Jev kategóriát és valószínűségeket ad vissza, így kevésbé mutatja meg, miért hibázott egy rendszer, vagy hogyan lehetne javítani rajta. Az Arize AI által felvázolt működés szerint a Jev minden nyomot vagy döntést ellenőrizhet, a bizonytalan vagy hibásnak tűnő eseteket pedig egy LLM-bíróhoz lehet továbbítani írásos magyarázatért.
A valószínűségek emberi felülvizsgálatot is irányíthatnak
A Jev egyik fontos ígérete, hogy a valószínűségi értékek alapján elkülöníthetők az automatikusan kezelhető és a bizonytalan esetek. A TypeSafe szerint egy modell önmagában kevéssé automatizálható, ha ugyan 95 százalékban helyesen dönt, de nem tudja jelezni, mikor tartozik a fennmaradó 5 százalékba.
Ez a megközelítés háromféle alkalmazási döntést támogathat: megadható egy küszöb, amely eldönti, mikor léphet működésbe az automatizmus, kialakítható egy eszkalációs út az emberi felülvizsgálathoz, és figyelhető a rendszer teljesítményének eltolódása. A korai eredmények kis mintákból származnak, ezért az Arize AI szerint további, saját benchmarkokra lesz szükség annak megállapításához, hogy a Jev költség- és sebességelőnye mennyire általánosítható.
Arize AI: TypeSafe’s Jev: Can decision models replace LLM judges?