A Cognition lett a Vera Rubin NVL72 első ügyfele a CoreWeave felhőjében
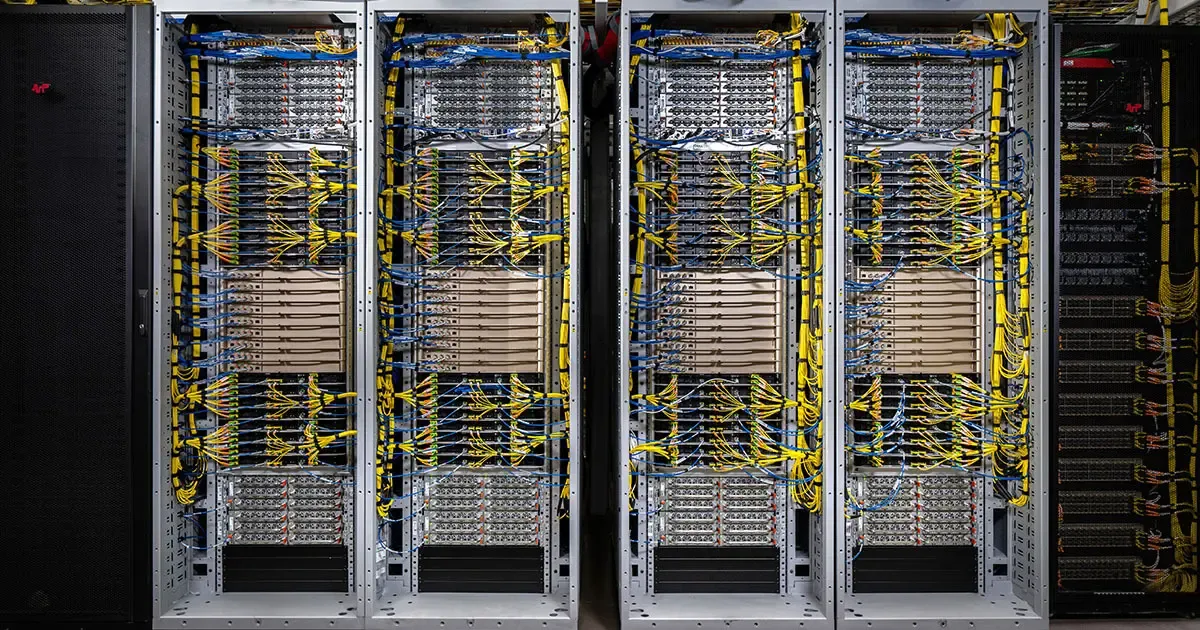
Korlátozottan elérhetővé vált a CoreWeave Cloudon az NVIDIA Vera Rubin NVL72 platform, amelyen a Cognition már éles, ügynökalapú AI-munkaterheléseket futtat. A Devin fejlesztői rendszer készítője a CoreWeave szerint az első ügyfél, amely termelési környezetben használja az új platformot.
- Korlátozottan elérhető a NVIDIA Vera Rubin NVL72 a CoreWeave Cloudon.
- A Cognition és a Devin az első termelési ügynökalapú ügyfél.
- Az SWE-2 következtetésénél akár 4,8-szoros tokenátvitelt mértek.
- A megerősítéses tanulás kimeneti tokenátvitele 3,8-szorosára nőtt.
- A platform 72 Rubin GPU-t és 36 Vera CPU-t integrál.
Korlátozottan indult el a Vera Rubin a CoreWeave-nál
A CoreWeave október 22-i közleménye szerint a NVIDIA Vera Rubin NVL72 már korlátozottan elérhető a CoreWeave Cloudon. A vállalat több régióban több száz NVIDIA Rubin GPU-t telepített, és megkezdte az ügyfélmunkaterhelések termelési környezetben történő futtatását. Ezek között szerepel a Cognition használata is.
A platformot olyan mesterségesintelligencia-feladatokra szánják, amelyek hosszú kontextust, nagy párhuzamosságot és alacsony késleltetést igényelnek. Az ügyfelek a CoreWeave Kubernetes Service, a CoreWeave Inference, a CoreWeave SUNK, a CoreWeave AI Object Storage és a CoreWeave Mission Control szolgáltatásaival együtt használhatják a kapacitást. A CoreWeave szerint ez lehetővé teszi a nagy számításigényű tanítás, a nagy áteresztőképességű ügynökalapú következtetés és a teljes AI-folyamat kezelését.
A Cognition a Devinhez használja az új rendszert
A Cognition, a Devin nevű autonóm AI-szoftvermérnök készítője, első ügyfélként futtat termelési ügynökalapú munkaterheléseket NVIDIA Vera Rubin NVL72 rendszeren a CoreWeave Cloudban. A Devin teljes kódadattárakon dolgozhat, és feladataihoz hosszú következtetési láncokat, kódgenerálást, hibakeresést, végrehajtást, értékelést és ismétlést használ.
A Cognition a modell betanítását és a termelési következtetést is ugyanazon, bare metal CoreWeave Cloud platformon futtatja. A munkafolyamat része a valós idejű lekérdezések kis késleltetésű kiszolgálása, a KV-cache kezelésének és a futtatási beállításoknak a finomhangolása, valamint a kísérletek követése a Weights & Biases Models segítségével. A vállalat emellett nagyméretű előtanítást, finomhangolást, megerősítéses tanulást és tesztidejű skálázást végez a Devin modelljein.
A CoreWeave közlése szerint a Cognition a kezdeti kapacitásról több ezer GPU-ra skálázott a tanítás és a dedikált következtetés számára. Mérnökei a rackek átadását követő napokon belül termelési munkaterheléseket indítottak, saját egyedi üzembe helyezési munkálatok nélkül.
Akár 4,8-szoros tokenátvitelt mértek
A Vera Rubin NVL72 egy folyadékhűtéses platform, amely 72 Rubin GPU-t és 36 Vera CPU-t kapcsol össze egyetlen logikai GPU-ként. A GPU-kat NVIDIA NVLink 6 köti össze. A rendszer 1400 TB/s HBM4 memória-sávszélességet és 216 TB/s NVLink-sávszélességet kínál, a CoreWeave szerint pedig billió paraméteres modellek kezelésére is alkalmas.
A Cognition mérnökei a CoreWeave-en a Vera Rubin NVL72-t a korábbi NVIDIA GB200 NVL72 alapértékeivel hasonlították össze, a saját SWE-2 benchmarkjukban. Az eredmények szerint az SWE-2 következtetésénél a teljes tokenátvitel GPU-nként akár 4,8-szorosára nőtt, azonos interaktivitás mellett. A megerősítéses tanulásnál a kimeneti tokenátvitel 3,8-szoros javulást mutatott, szintén GPU-nként és azonos interaktivitás mellett.
A CoreWeave szerint az ügynökalapú feladatoknál az egyes lépések egymásra épülnek: a rendszer kontextust olvas be, következtet, eszközöket hív, kódot futtat, értékeli az eredményt, majd ismétel. A vállalat állítása szerint a gyorsabb feldolgozás ezért a teljes munkafolyamatban összeadódó időmegtakarítást eredményezhet.
A kapacitásra kiválasztott ügyfelek jelentkezhetnek
A CoreWeave közlése alapján a Vera Rubin NVL72 már nem pusztán fejlesztési terv, hanem kiválasztott ügyfelek számára termelési munkaterhelések futtatására kész platform a CoreWeave Cloudon. A vállalat kapacitástervezési tájékoztatót és úgynevezett ARENA Pass hozzáférést kínál azoknak, akik saját munkaterhelésükkel próbálnák ki a rendszert.
Silas Alberti, a Cognition kutatásért felelős alelnöke és alapító csapatának tagja szerint az ügynökalapú kódolás hosszú kontextust, nagy párhuzamosságot és gyors következtetést igényel. A Cognition közlése szerint a Vera Rubin NVL72-vel mért 4,8-szoros tokenátviteli növekedés felgyorsítja a Devin által végzett összetett mérnöki feladatok lépéseit.