A CoreWeave szerint gyorsul az AI-számítás iránti kereslet
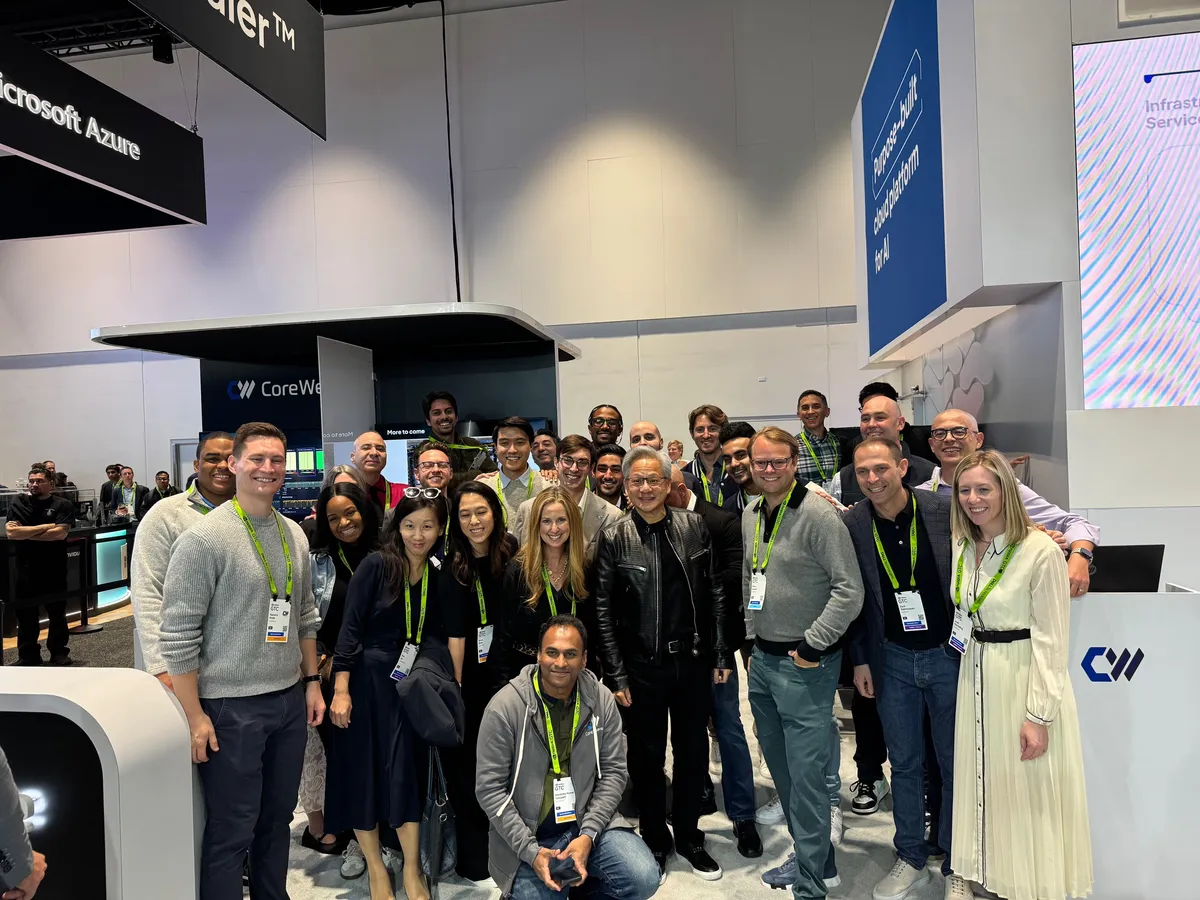
A CoreWeave összefoglalta az NVIDIA GTC 2025 konferencia legfontosabb eseményeit, köztük az új Blackwell Ultra platformot, az AI-infrastruktúra fejlesztéseit és saját termékbejelentéseit. A vállalat szerint a gondolkodó és ügynökalapú mesterséges intelligencia terjedése gyorsítja az AI-számítás iránti keresletet.
- A CoreWeave összefoglalta az NVIDIA GTC 2025 legfontosabb történéseit.
- Jensen Huang bemutatta az NVIDIA Blackwell Ultra platformot.
- A CoreWeave új AI-objektumtárhelyet és NVIDIA-alapú számítási példányokat jelentett be.
- A vállalat szerint H100 GPU-kon 50 százalék feletti modell-FLOPS-kihasználtságot ér el.
- A CoreWeave támogatást jelentett be az NVIDIA AI Enterprise és NVIDIA Cloud Functions szolgáltatásokhoz.
A GTC középpontjában az AI-infrastruktúra állt
Az NVIDIA vezérigazgatója, Jensen Huang nyitóelőadásában az AI-infrastruktúráról, az úgynevezett AI-gyárakról, az ügynökalapú mesterséges intelligenciáról és a robotikáról beszélt. Az előadás egyik bejelentése az új NVIDIA Blackwell Ultra platform volt.
A CoreWeave beszámolója szerint az esemény egyik legfontosabb üzenete az volt, hogy gyorsul az AI-számítás iránti kereslet. A vállalat ezt a gondolkodó AI és az ügynökalapú AI terjedésével hozta összefüggésbe, amelyek a világszerte zajló adatközponti beruházások léptékét és összetettségét is alakítják.
A CoreWeave szakértői több NVIDIA-színpadi előadásban vettek részt. Ezek az AI-infrastruktúra megközelítéseit, az adatközpontok hatékonyságának és fenntarthatóságának javítását, valamint a GPU-klaszterek teljesítményének növelését vizsgálták.
Nagy GPU-klaszterek és partneri együttműködések
Peter Salanki, a CoreWeave technológiai igazgatója az egyszerre több mint 100 ezer GPU-t kiszolgáló AI-adatközpontok és felhők hálózati kihívásairól beszélt. A vállalat bemutatta, hogyan épített ki nagy léptékű NVIDIA Quantum-2 InfiniBand hálózatot, és milyen tapasztalatokat szerzett több ezer GPU összekapcsolásában.
A Jane Streettel közös előadás az AI-infrastruktúra használatát mutatta be kvantitatív kereskedési modellek tanítására és finomhangolására. Egy másik prezentáció az NVIDIA GB200 NVL72 klaszterek teljesítményhangolásával, a modellbetöltéssel, a mentési pontok kezelésével és a hibakezeléssel foglalkozott.
A CoreWeave standján az IBM, a Cohere és a Rescale képviselőivel is tartottak közös beszélgetéseket. Az IBM-mel az összetett AI-modellek, köztük az IBM Granite 3.2 tanításához és finomhangolásához szükséges infrastruktúráról, valamint egy új IBM-tárhelyszolgáltatásról beszéltek. A Cohere-rel az NVIDIA GB200 NVL72 állványok korai méréseit ismertették. A CoreWeave szerint ezek a mérések jelentős áteresztőképesség-növekedést mutattak az NVIDIA HGX H100 rendszerekhez képest.
A vállalat további, igény szerint megtekinthető előadásokat is támogatott. Ezek között szerepelt az AI-klaszterek teljesítményének és ellenálló képességének javítása, valamint a CoreWeave Distributed File Storage teljesítményének vizsgálata egy 32 ezres NVIDIA H200 GPU-klaszterben.
Új tárhely, számítási példányok és felhőszolgáltatások
A konferencián a CoreWeave több termékbejelentést is tett. Általánosan elérhetővé vált a CoreWeave AI Object Storage, egy nagy I/O-igényű és nagy adathalmazokat használó AI- és gépi tanulási munkafolyamatokra optimalizált objektumtárhely. A vállalat ezt nagy léptékű teljesítményre, a munkafolyamatokkal való integrációra és vállalati szintű megbízhatóságra tervezett megoldásként mutatta be.
A CoreWeave új számítási példányok bevezetését is bejelentette az NVIDIA RTX PRO 6000 Blackwell Server Edition GPU-ival. A cég állítása szerint ezek a GPU-k az NVIDIA L40S-hez képest akár 5,3-szor gyorsabb nagy nyelvi modellkövetkeztetést és 3,5-szor gyorsabb szövegből képet generálást kínálhatnak.
A CoreWeave Cloud Platform támogatást kap az NVIDIA AI Enterprise szoftverplatformhoz és az NVIDIA Cloud Functions szolgáltatáshoz. A vállalat közlése szerint az NVIDIA GB200 NVL72-n futó NVIDIA Cloud Functions egyik első felhőszolgáltatói kínálatát biztosítja.
A CoreWeave a saját méréseit is ismertette. A vállalat legfrissebb tanulmánya szerint NVIDIA H100 GPU-kon 50 százalék feletti modell-FLOPS-kihasználtságot ér el, és akár 1,2-szer nagyobb teljesítményt biztosít alternatív megoldásokhoz képest. Ezek a számok a CoreWeave saját vizsgálatának eredményei.
Mit jelenthet mindez a felhasználóknak?
A bemutatott fejlesztések elsősorban az AI-modellek tanítását, finomhangolását és futtatását végző fejlesztőknek, kutatóknak és vállalatoknak szólnak. A nagyobb GPU-klaszterek, a gyorsabb tárhely és az új felhőszolgáltatások célja, hogy az AI-munkafolyamatok nagyobb léptékben és a CoreWeave szerint hatékonyabban működjenek.
A konferencián elhangzott példák alapján a hangsúly a számítási kapacitás mellett a hálózatok, a tárhely, a hibakezelés és az üzemeltetés összehangolásán is van. A CoreWeave összefoglalója így egy olyan infrastruktúra-modellt mutat be, amelyben a GPU-k, a nagy teljesítményű adatkezelés és az AI-szoftverszolgáltatások együtt támogatják az AI-alkalmazások fejlesztését és bevezetését.
CoreWeave: GTC 2025: A Recap of an Awe-Inspiring Week